Сбор данных
|
В этом модуле вы познакомитесь с понятием стандартов, в частности со стандартом Darwin Core и его компонентами. Вы также узнаете о типах первичных данных о биоразнообразии и о том, как наиболее эффективно предоставлять эти данные через GBIF. В заключение вы ознакомитесь с принципами обеспечения качества данных при их вводе, а также узнаете о подходах к контролю качества и согласованности данных, включая географическую привязку, даты, имена и проверку соответствия таксонов. |
Standards and Darwin Core
|
В этом видеоролике (23:25) вы узнаете, как стандарты используются в повседневной жизни. Затем вы познакомитесь с "https://www.tdwg.org/" [Стандарты информации о биоразнообразии^] и разработанными ею стандартами, включая стандарт "https://www.tdwg.org/standards/dwc/" [Стандарт Darwin Core^], который будет использоваться на протяжении всего курса. Субтитры к этому видеоролику пока недоступны. Если вы не можете просмотреть встроенное видео, вы можете скачать его на свой компьютер по ссылке:$standards_and_darwin_core_v3-720p.mp4[download,opts=download]. (MP4 — 71,5 МБ) Если вы предпочитаете ознакомиться с материалом в текстовом виде, транскрипт видеоролика приведён ниже |
Presentation transcript
Нажмите, чтобы раскрыть
Слайд 1 — Стандарты и Darwin Core
В этой презентации вы познакомитесь со стандартами данных, используемыми для работы с данными о биоразнообразии. Основное внимание будет уделено Darwin Core.
Слайд 2. Стандарты: давайте договоримся действовать согласованно
Инженер и промышленник У. Эдвардс Деминг сказал:
«Стандартизация не означает, что все мы должны носить одежду одинакового цвета и покроя, есть одинаковые бутерброды или жить в одинаковых комнатах с одинаковой мебелью. Дома могут быть бесконечно разнообразными по своему устройству, но при этом строятся из нескольких типов кирпича, стандартных пиломатериалов, а также водопроводных и отопительных труб и соединительных элементов стандартных размеров».
Он хотел показать, что стандартизация не препятствует творчеству. Он также напомнил нам, что стандарты уже окружают нас повсюду.
Далее мы дадим определение понятию «стандарт» и рассмотрим, как мы ежедневно взаимодействуем со стандартами. Затем вы познакомитесь со стандартами информации о биоразнообразии, включая стандарт Darwin Core, который будет использоваться на протяжении всего курса.
Слайд 3 — Что такое стандарт?
Так что же такое «стандарт»?
В самом простом виде это выглядит так:
«Общепринятый способ выполнения чего-либо».
Стандарты представляют собой совокупность норм, соглашений, технических условий, требований, ограничений и правил.
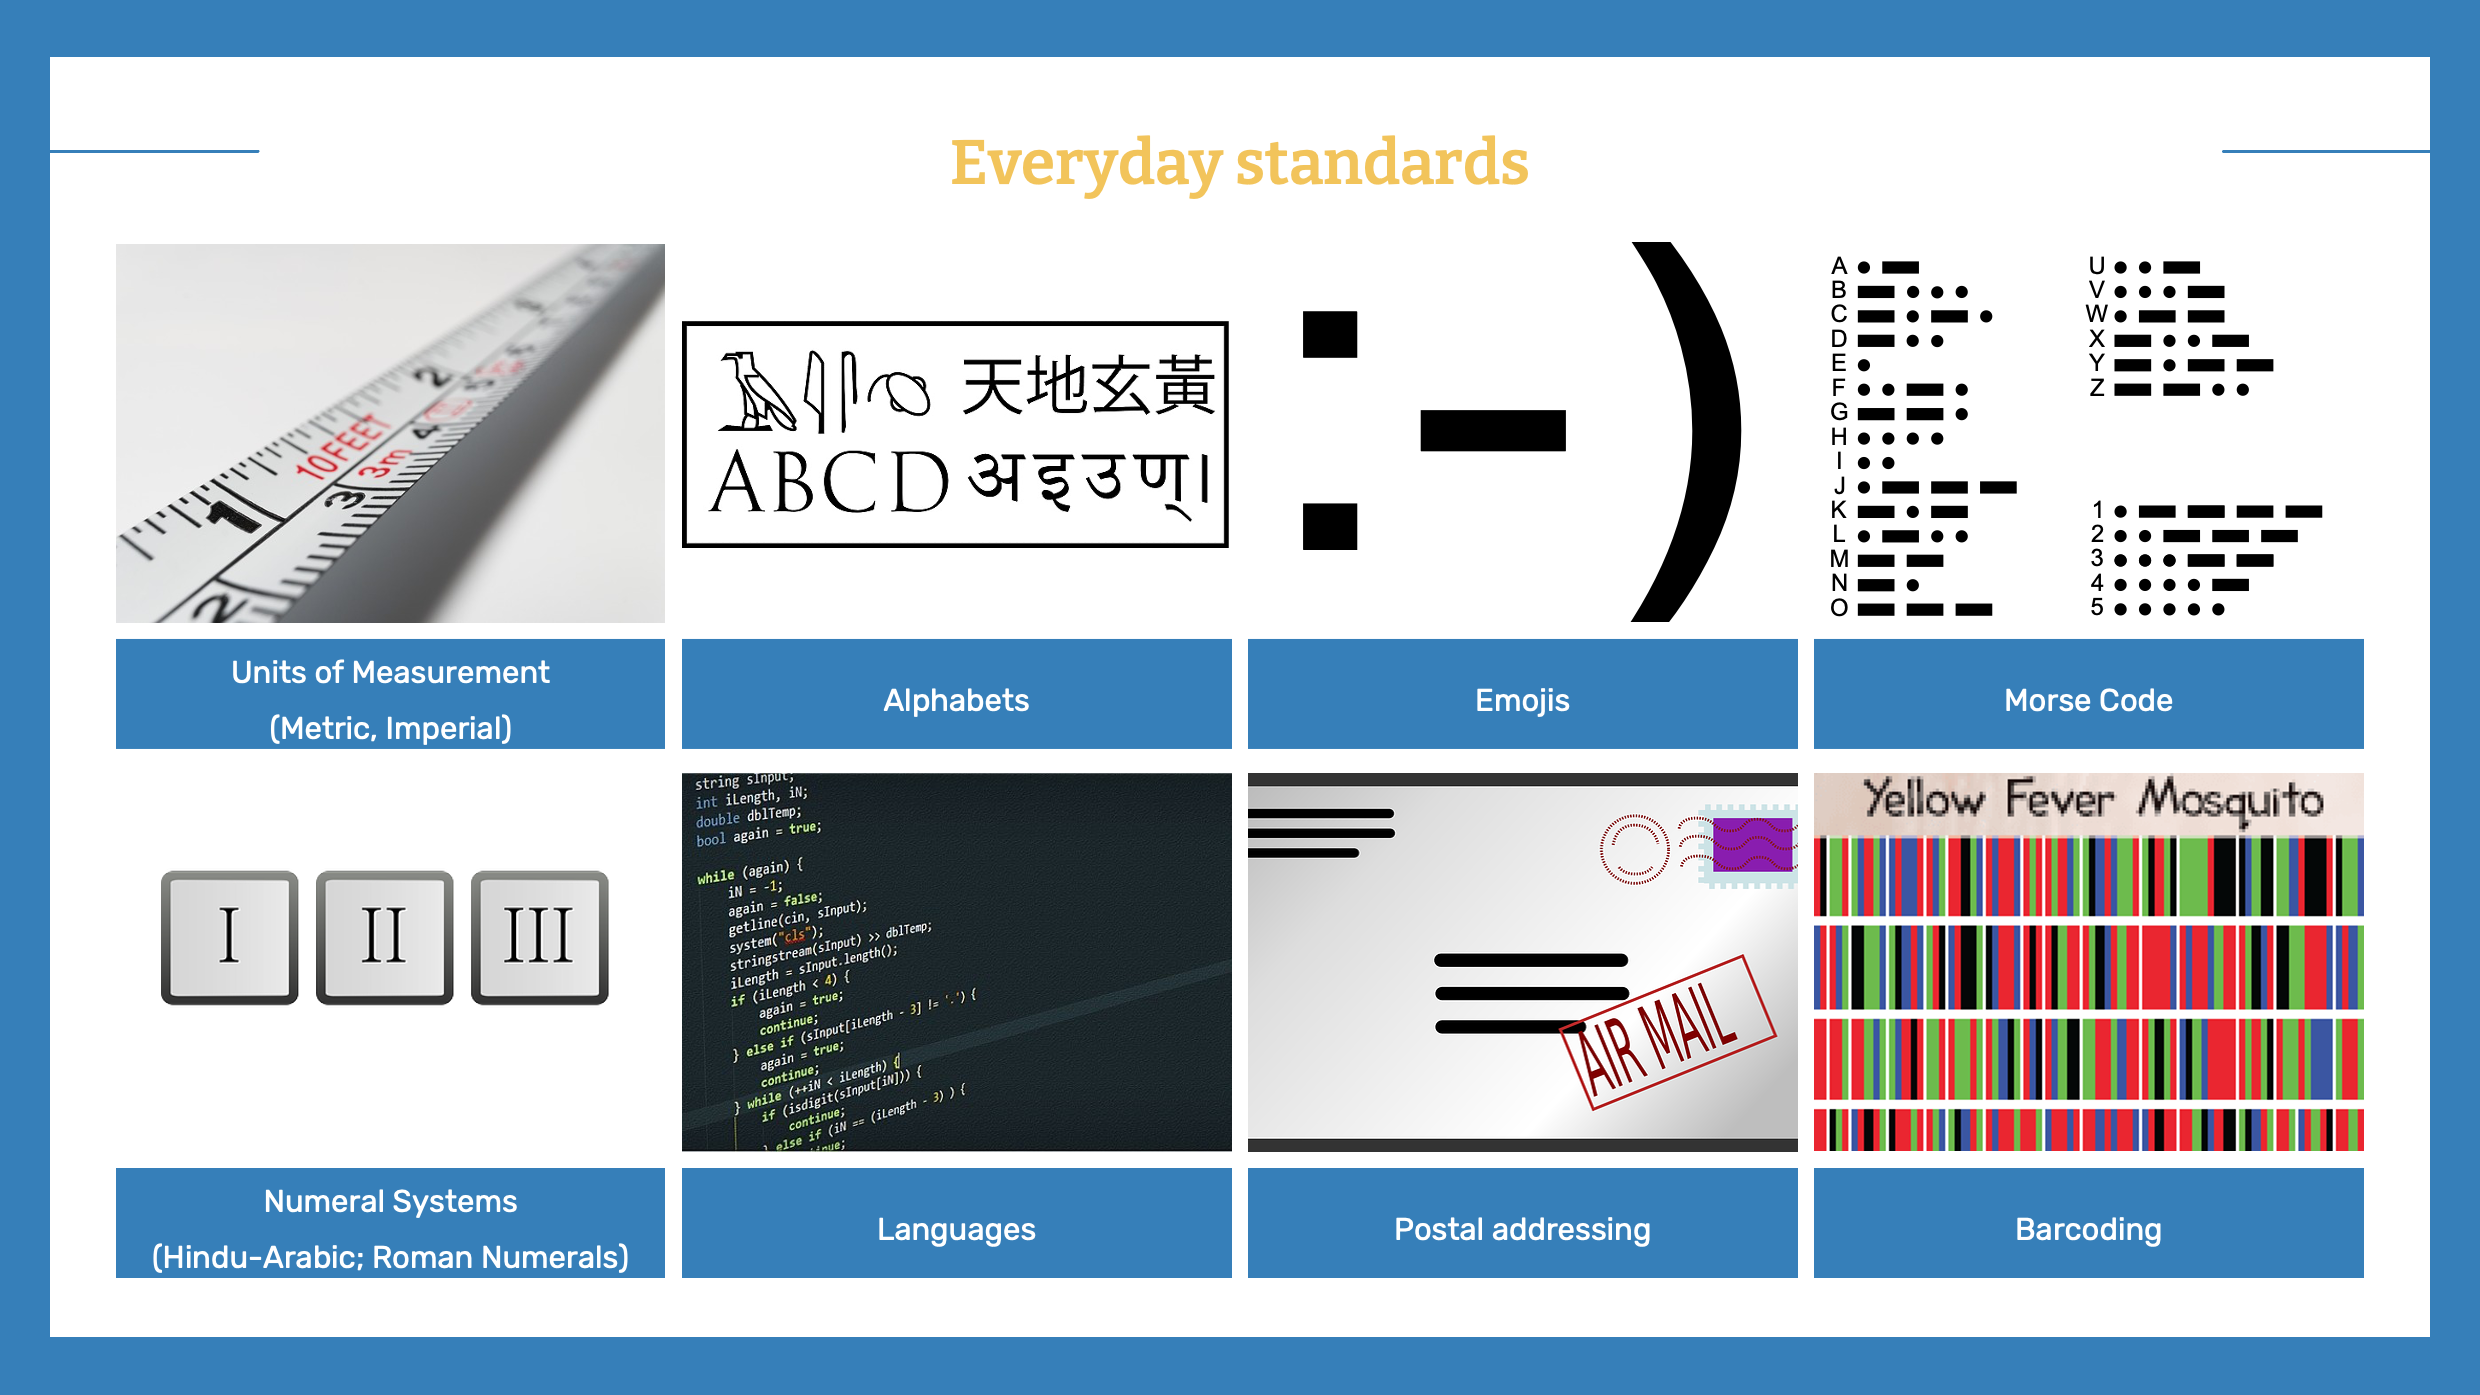
Слайд 4 — Повседневные стандарты
Основная цель стандартов — создать основу для "взаимопонимания". Они должны обеспечивать ясность и способствовать эффективному обмену информацией.
Вот несколько примеров того, как стандарты помогают передавать информацию в повседневной жизни:
-
Единицы измерения
-
Системы счисления
-
Алфавиты
-
Языки
-
Смайлики
-
Почтовая адресация
-
Азбука Морзе
-
Штрих-кодирование
Изображение «Измерение» — автор Arek Socha с сайта Pixabay https://pixabay.com/photos/measurement-millimeter-centimeter-1476913/ Изображение «Цифры» авторства Clker-Free-Vector-Images с сайта Pixabay https://pixabay.com/vectors/numerals-roman-number-blocks-35937/ Изображение «Алфавит» авторства https://en.wikipedia.org/wiki/Alphabet#/media/File:Historical_Writing_Systems_Template_Image.jpg Изображение «Языки» от Christopher Kuszajewski с Pixabay https://pixabay.com/photos/source-code-code-programming-c-583537/ Изображение «Азбука Морзе» от https://en.wikipedia.org/wiki/Morse_code#/media/File:International_Morse_Code.svg Изображение «Почта» от OpenClipart-Vectors с сайта Pixabay https://pixabay.com/vectors/airmail-mail-envelope-post-postal-145212/ Изображение смайликов от https://en.wikipedia.org/wiki/Emoticon#/media/File:Emoticon_Smile_Face.svg Штрих-код. Изображение предоставлено IBOL https://ibol.org/site/wp-content/uploads/2018/12/bookmark-vectors.png


Слайд 5 — Повседневный стандарт — пример
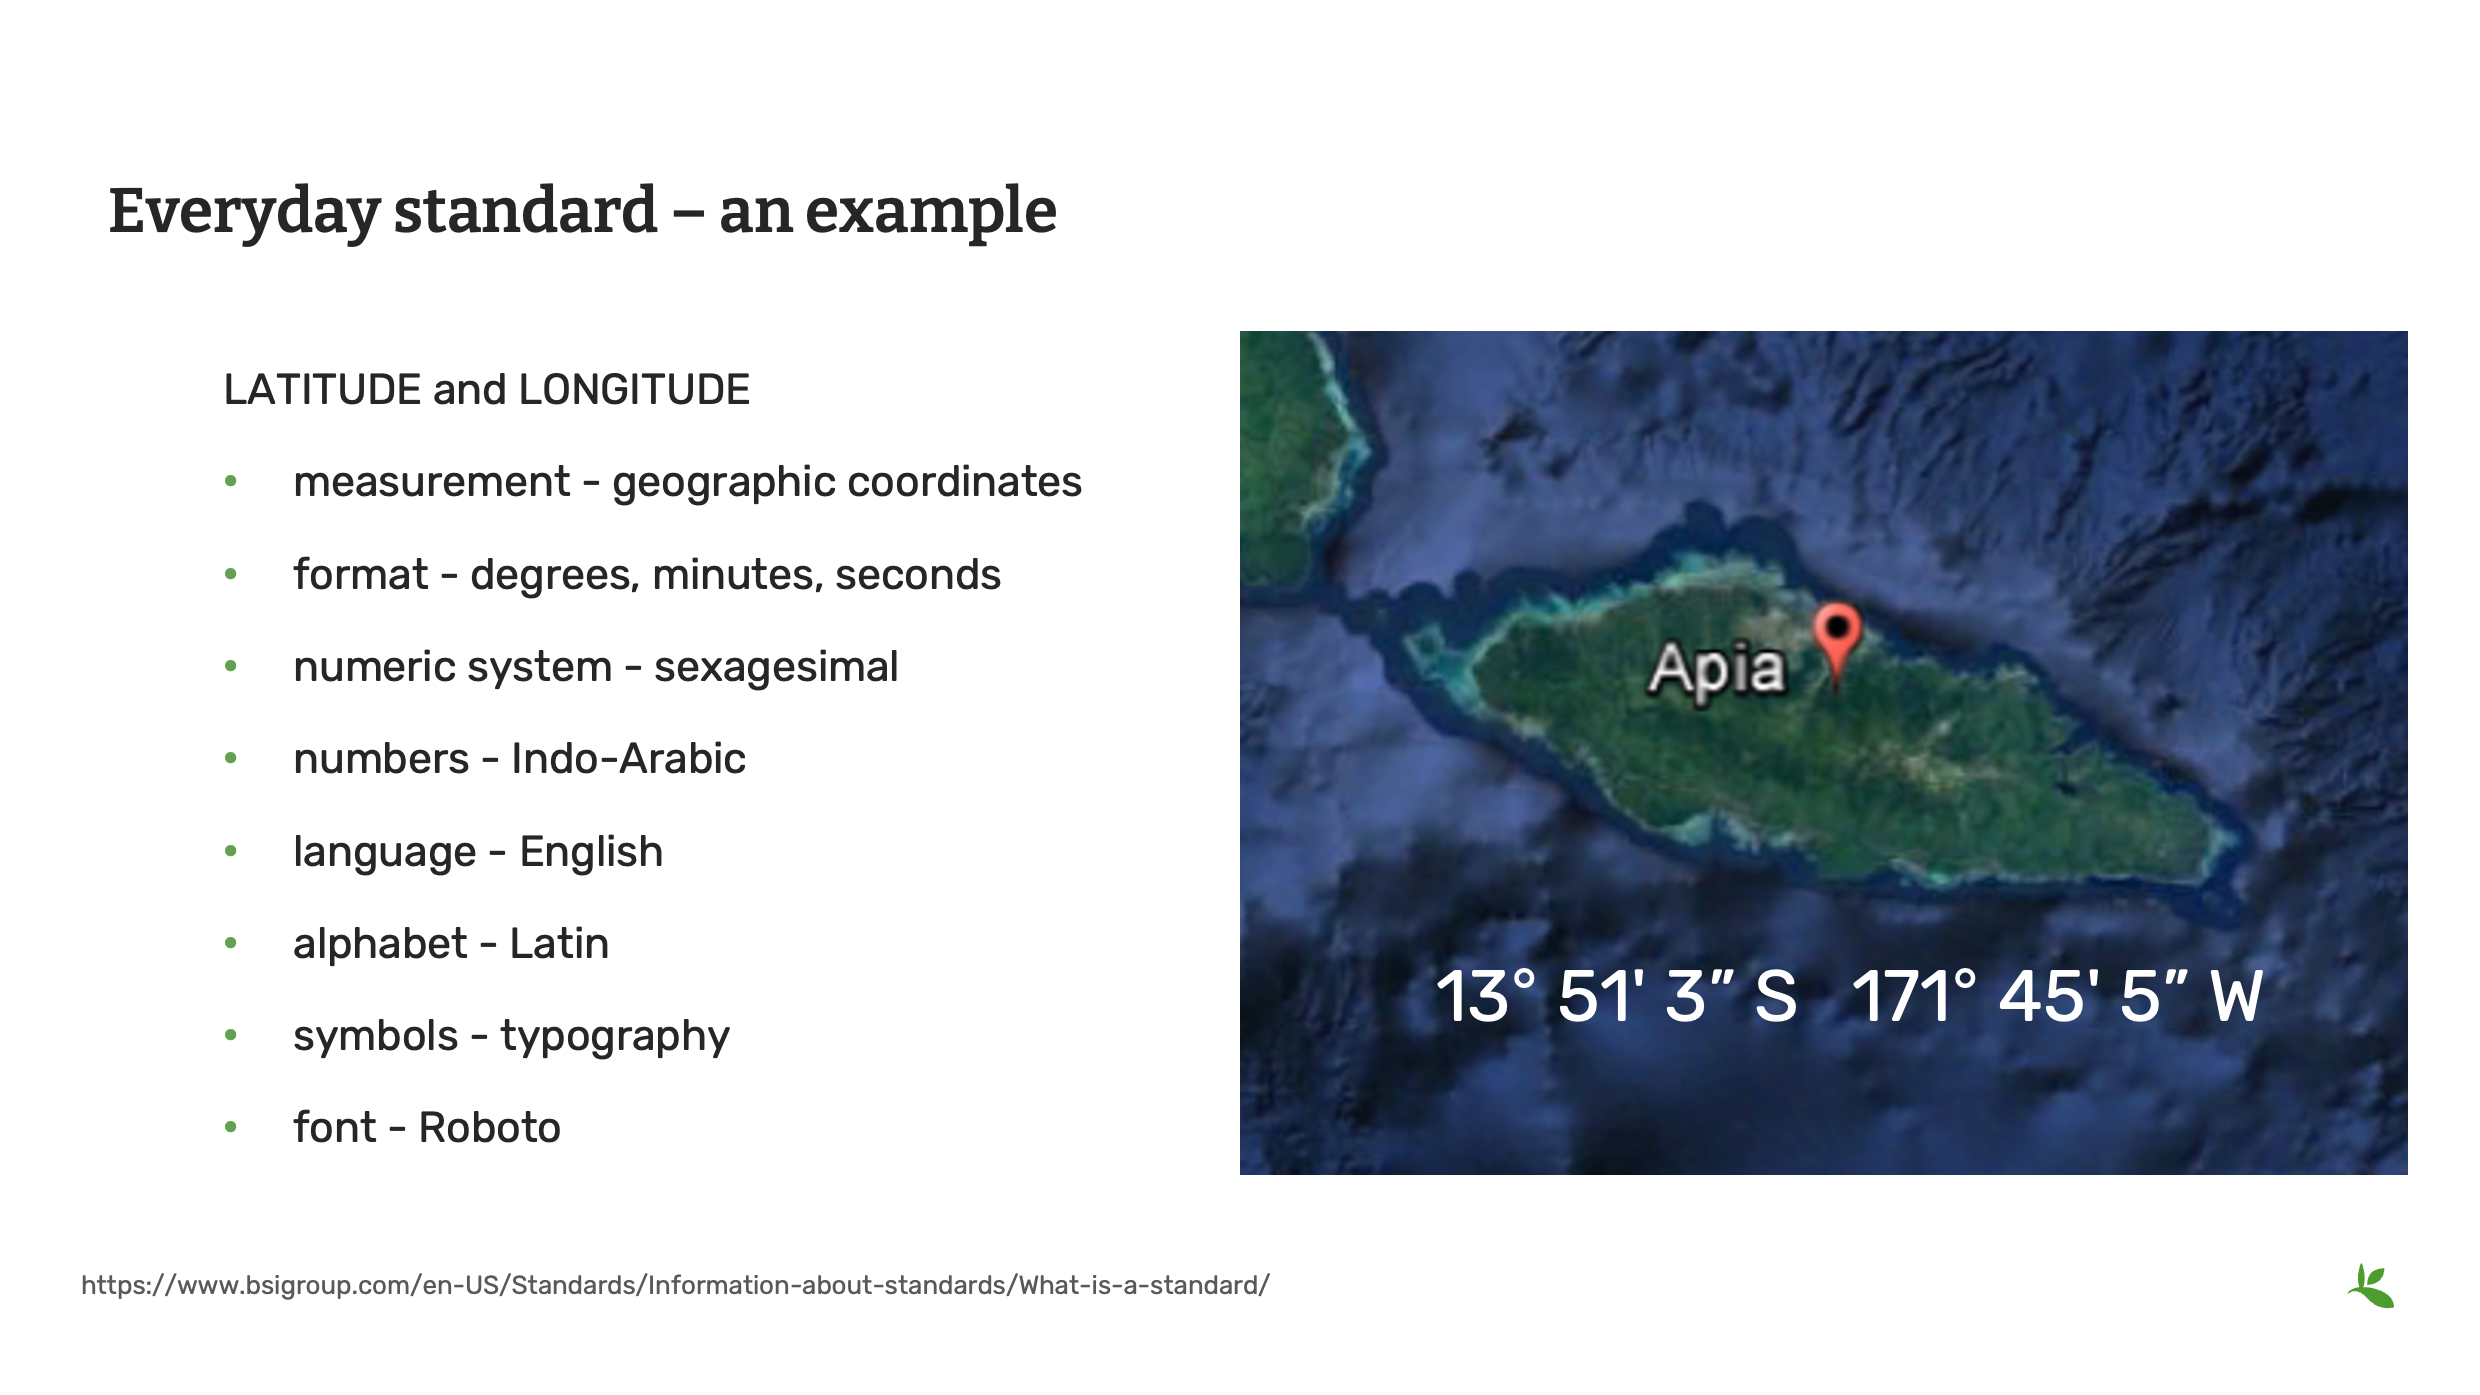
Рассмотрим один конкретный пример и разберём его подробнее. Для того чтобы точно и однозначно передавать информацию о местоположении на Земле — широту и долготу, — на самом деле используется сочетание как минимум восьми стандартов.
измерение — формат географических координат — градусы, минуты, секунды; система счисления — шестидесятеричная; язык — индо-арабский; алфавит — английский; символы — латинские; шрифт — Roboto
Слайд 6 — Правила и ограничения
Стандарты позволяют ограничить множество возможных вариантов. В предыдущих материалах курса «Основы» вы познакомились с типами данных, схемами, форматами и кодировками символов. Каждый из этих элементов может использоваться для ограничения множества возможных вариантов в рамках стандарта.
Типы данных могут ограничивать допустимые значения поля. Например, текстовые поля содержат буквенно-цифровые данные, поля с плавающей запятой — десятичные числа, а логические поля (Boolean) — значения «Да» или «Нет».
Схема кодирования может ограничивать диапазон допустимых значений поля. Например, допустимые значения широты находятся в диапазоне от −90 до 90.
Формат может определять способ представления данных в поле. Например, дата может записываться в формате «год–месяц–день», «день–месяц–год» или «месяц–день–год».
Кроме того, кодировка символов определяет правила интерпретации байтов данных. В нашем случае мы будем использовать UTF-8.
Фото: Eurema blanda (Boisduval, 1836) Наблюдался в Непале исследователями-орнитологами (http://creativecommons.org/licenses/by-nc/4.0/)
Слайд 7 — Стандарты передачи данных
В рамках этого курса вы узнаете, как обмениваться данными. В связи с этим вы познакомитесь со стандартами передачи данных.
Схема приложения позволяет объединять стандарты данных для решения конкретной задачи. Например, использование терминов Darwin Core в архивах Darwin Core. Мы более подробно рассмотрим оба этих аспекта чуть позже.
И снова вы будете использовать формат, но на этот раз он определяет допустимую структуру набора данных. Набор данных может быть представлен в форматах csv, xml, json и rdf.
И наконец, используется протокол передачи данных, который определяет, как и куда передавать информацию. К ним могут относиться http (протокол передачи гипертекста), ftp (протокол передачи файлов) и smtp (простой протокол передачи почты или, проще говоря, протокол для отправки электронной почты).
Изображение: Gerd Altmannн с сайта Pixabay https://pixabay.com/illustrations/web-network-computer-digital-5371553/
Слайд 8 — Стандарты в области информации о биоразнообразии
В области информатики биоразнообразия уже существует множество стандартов, которые могут помочь вам в работе с данными. Геологическая служба США (USGS) дает им следующее четкое определение:
«Стандарты данных — это правила, по которым описываются и фиксируются данные. Чтобы обеспечить совместное использование, обмен и понимание данных, необходимо стандартизировать как их формат, так и их значение».
Применение этих стандартов там, где это уместно, позволяет повысить целостность, точность и согласованность данных благодаря устранению неоднозначности и минимизации избыточности данных.
К стандартам, с которыми вы, скорее всего, будете регулярно сталкиваться или которые будете использовать в своей работе, относятся:
Стандарт языка экологических метаданных (EML) Экологический кадастр Гумбольдта (расширение Humboldt) Глобальная сеть по биоразнообразию геномов (GGBN) Проект по стандартам и передовым практикам в области океанических данных (ODSBP)
И, наконец, что не менее важно, оставшуюся часть этого раздела мы посвятим стандарту Darwin Core. Стандарт Darwin Core позволяет публиковать данные о находках организмов, таксономические данные и данные о событиях отбора проб.
Ссылки: EML — https://knb.ecoinformatics.org/#external//emlparser/docs/index.html Audubon — https://terms.tdwg.org/wiki/Audubon_Core GGBN — http://wiki.ggbn.org/ggbn/GGBN_Data_Standard ODSBP — https://www.iode.org/index.php?option=com_content&view=article&id=369&Itemid=100083 DwC — http://rs.tdwg.org/dwc/
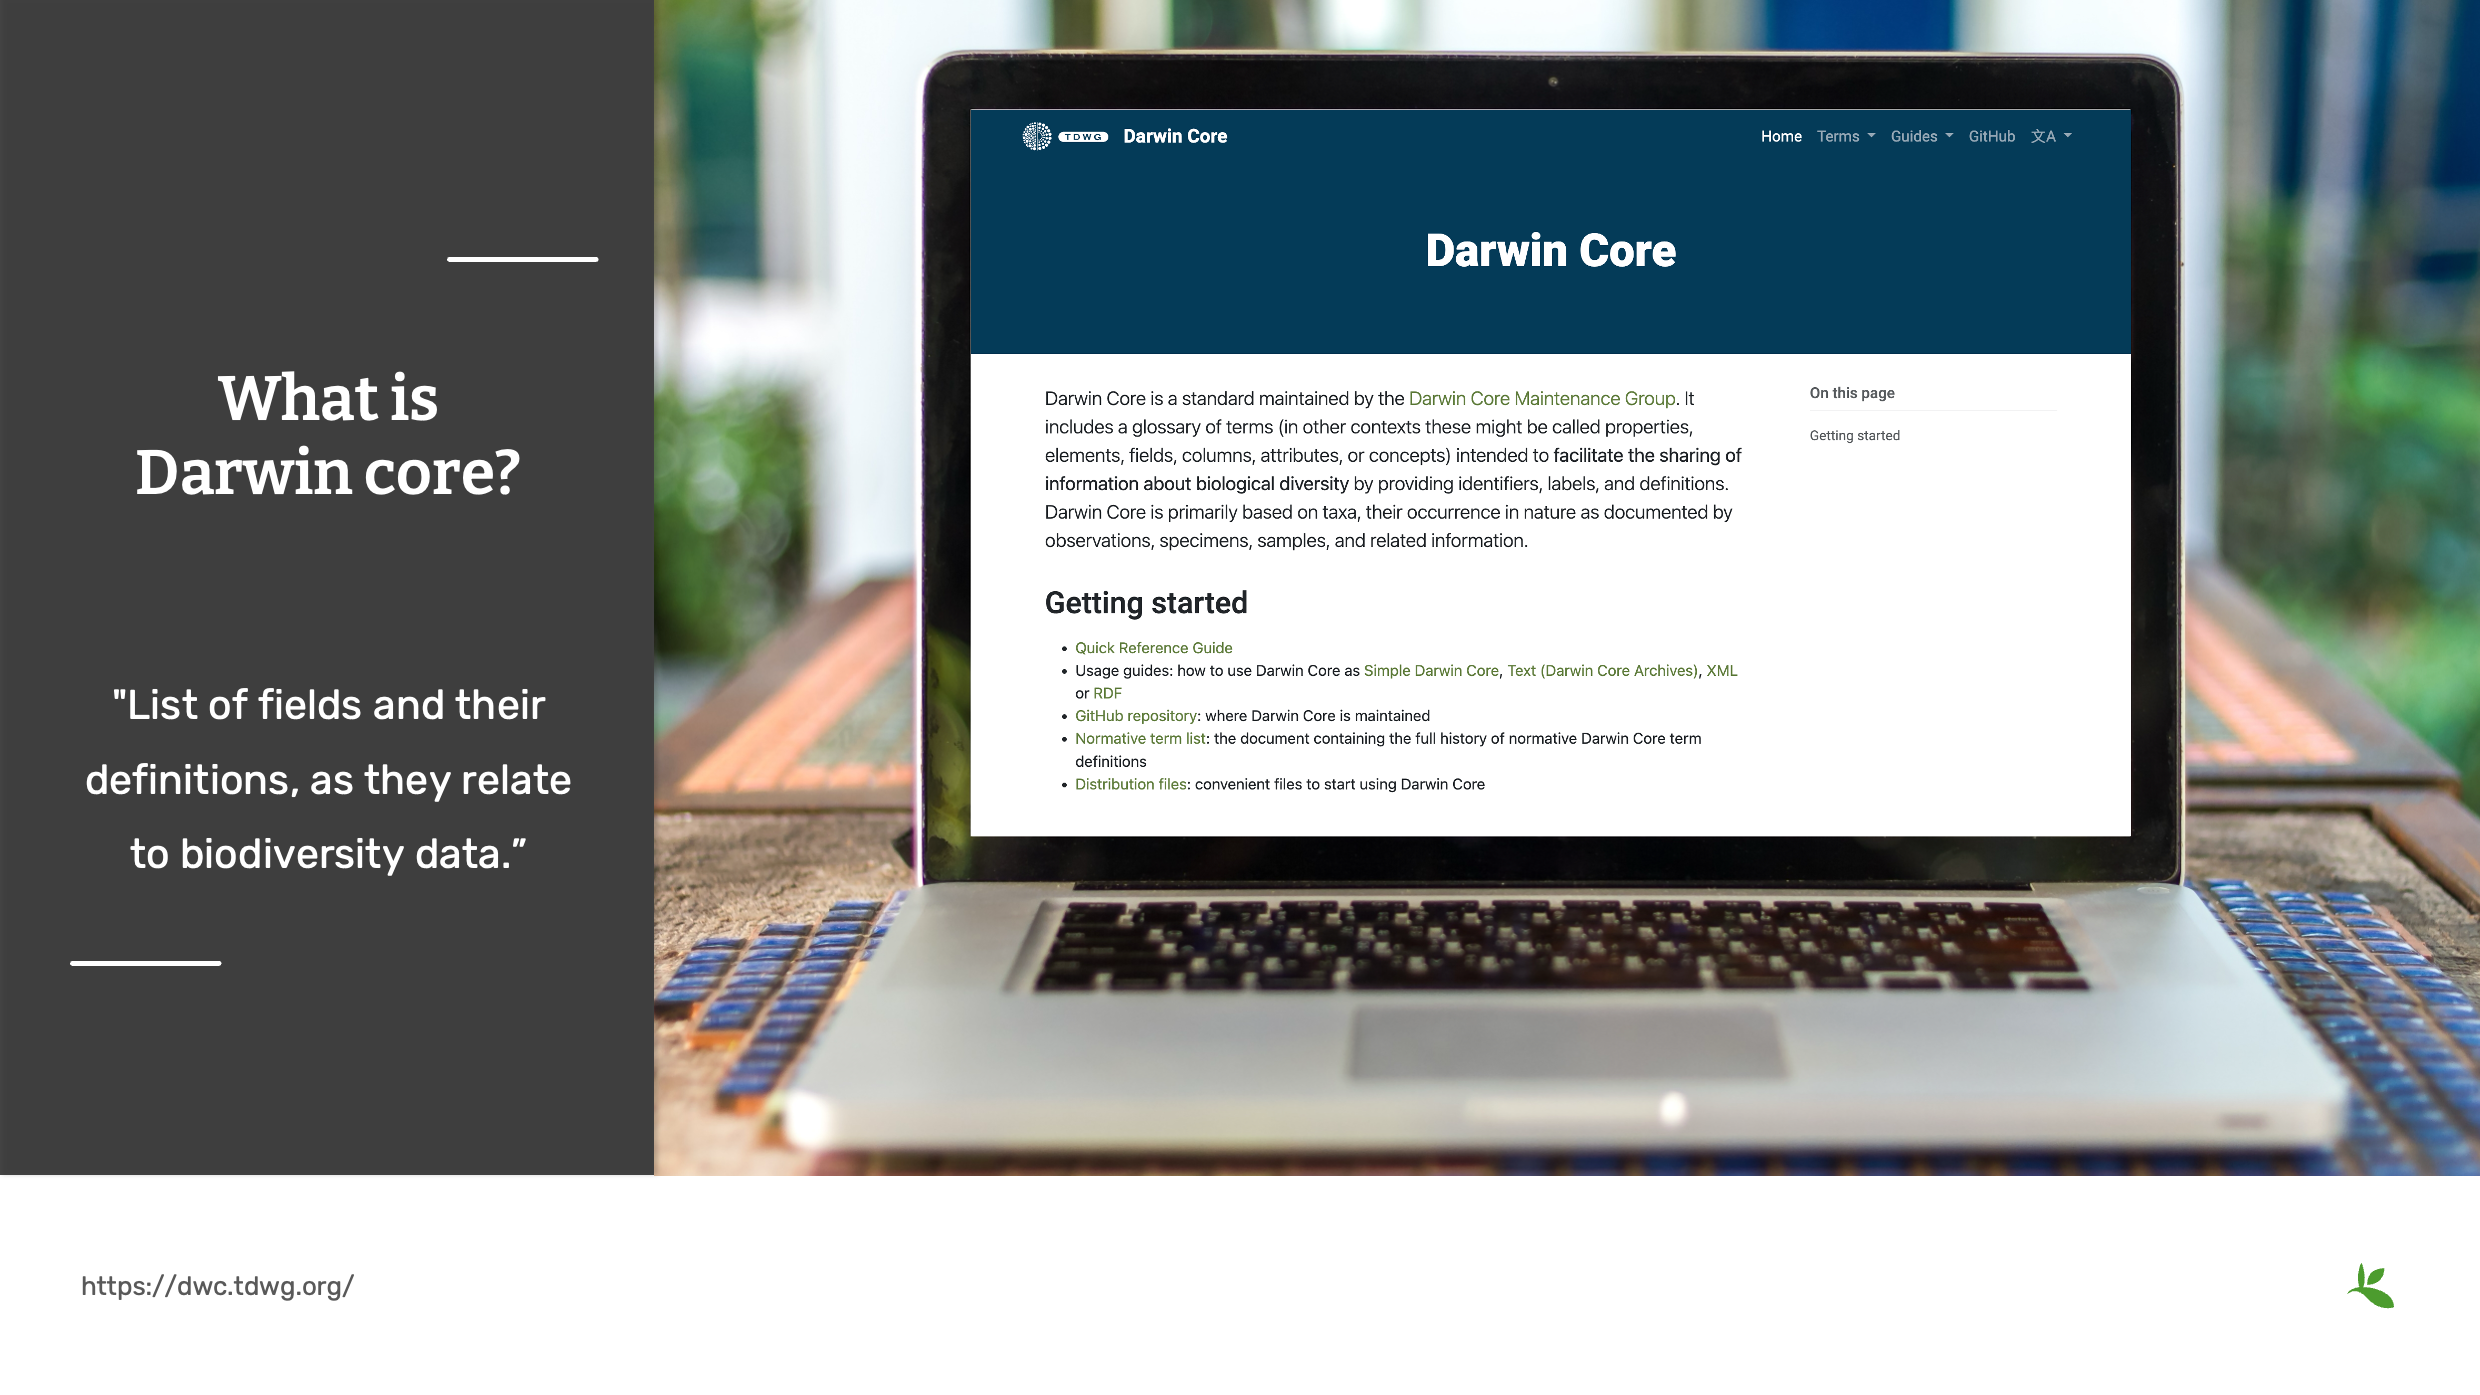
Слайд 9 — Что такое Darwin Core
Darwin Core — это стандарт в области биоразнообразия, разработанный сообществом специалистов по информатике в сфере биоразнообразия. Первоначально он был разработан в рамках Рабочей группы по таксономическим базам данных (Taxonomic Databases Working Group, T D W G), произносимой как TDWG. В последние годы группа была переименована в «Стандарты информации о биоразнообразии» (Biodiversity Information Standards). Однако аббревиатура TDWG сохранилась, поскольку это название прочно закрепилось в сообществе.
«Стандарт включает глоссарий терминов (которые в других контекстах могут называться свойствами, элементами, полями, столбцами, атрибутами или понятиями), предназначенных для облегчения обмена информацией о биологическом разнообразии посредством предоставления идентификаторов, названий и определений. Darwin Core прежде всего ориентирован на таксоны, их нахождение в природе, документированное наблюдениями, экземплярами, пробами, а также на связанную с ними информацию».
Короче говоря, Darwin Core — это
«Перечень полей и их определений, относящихся к данным о биоразнообразии».
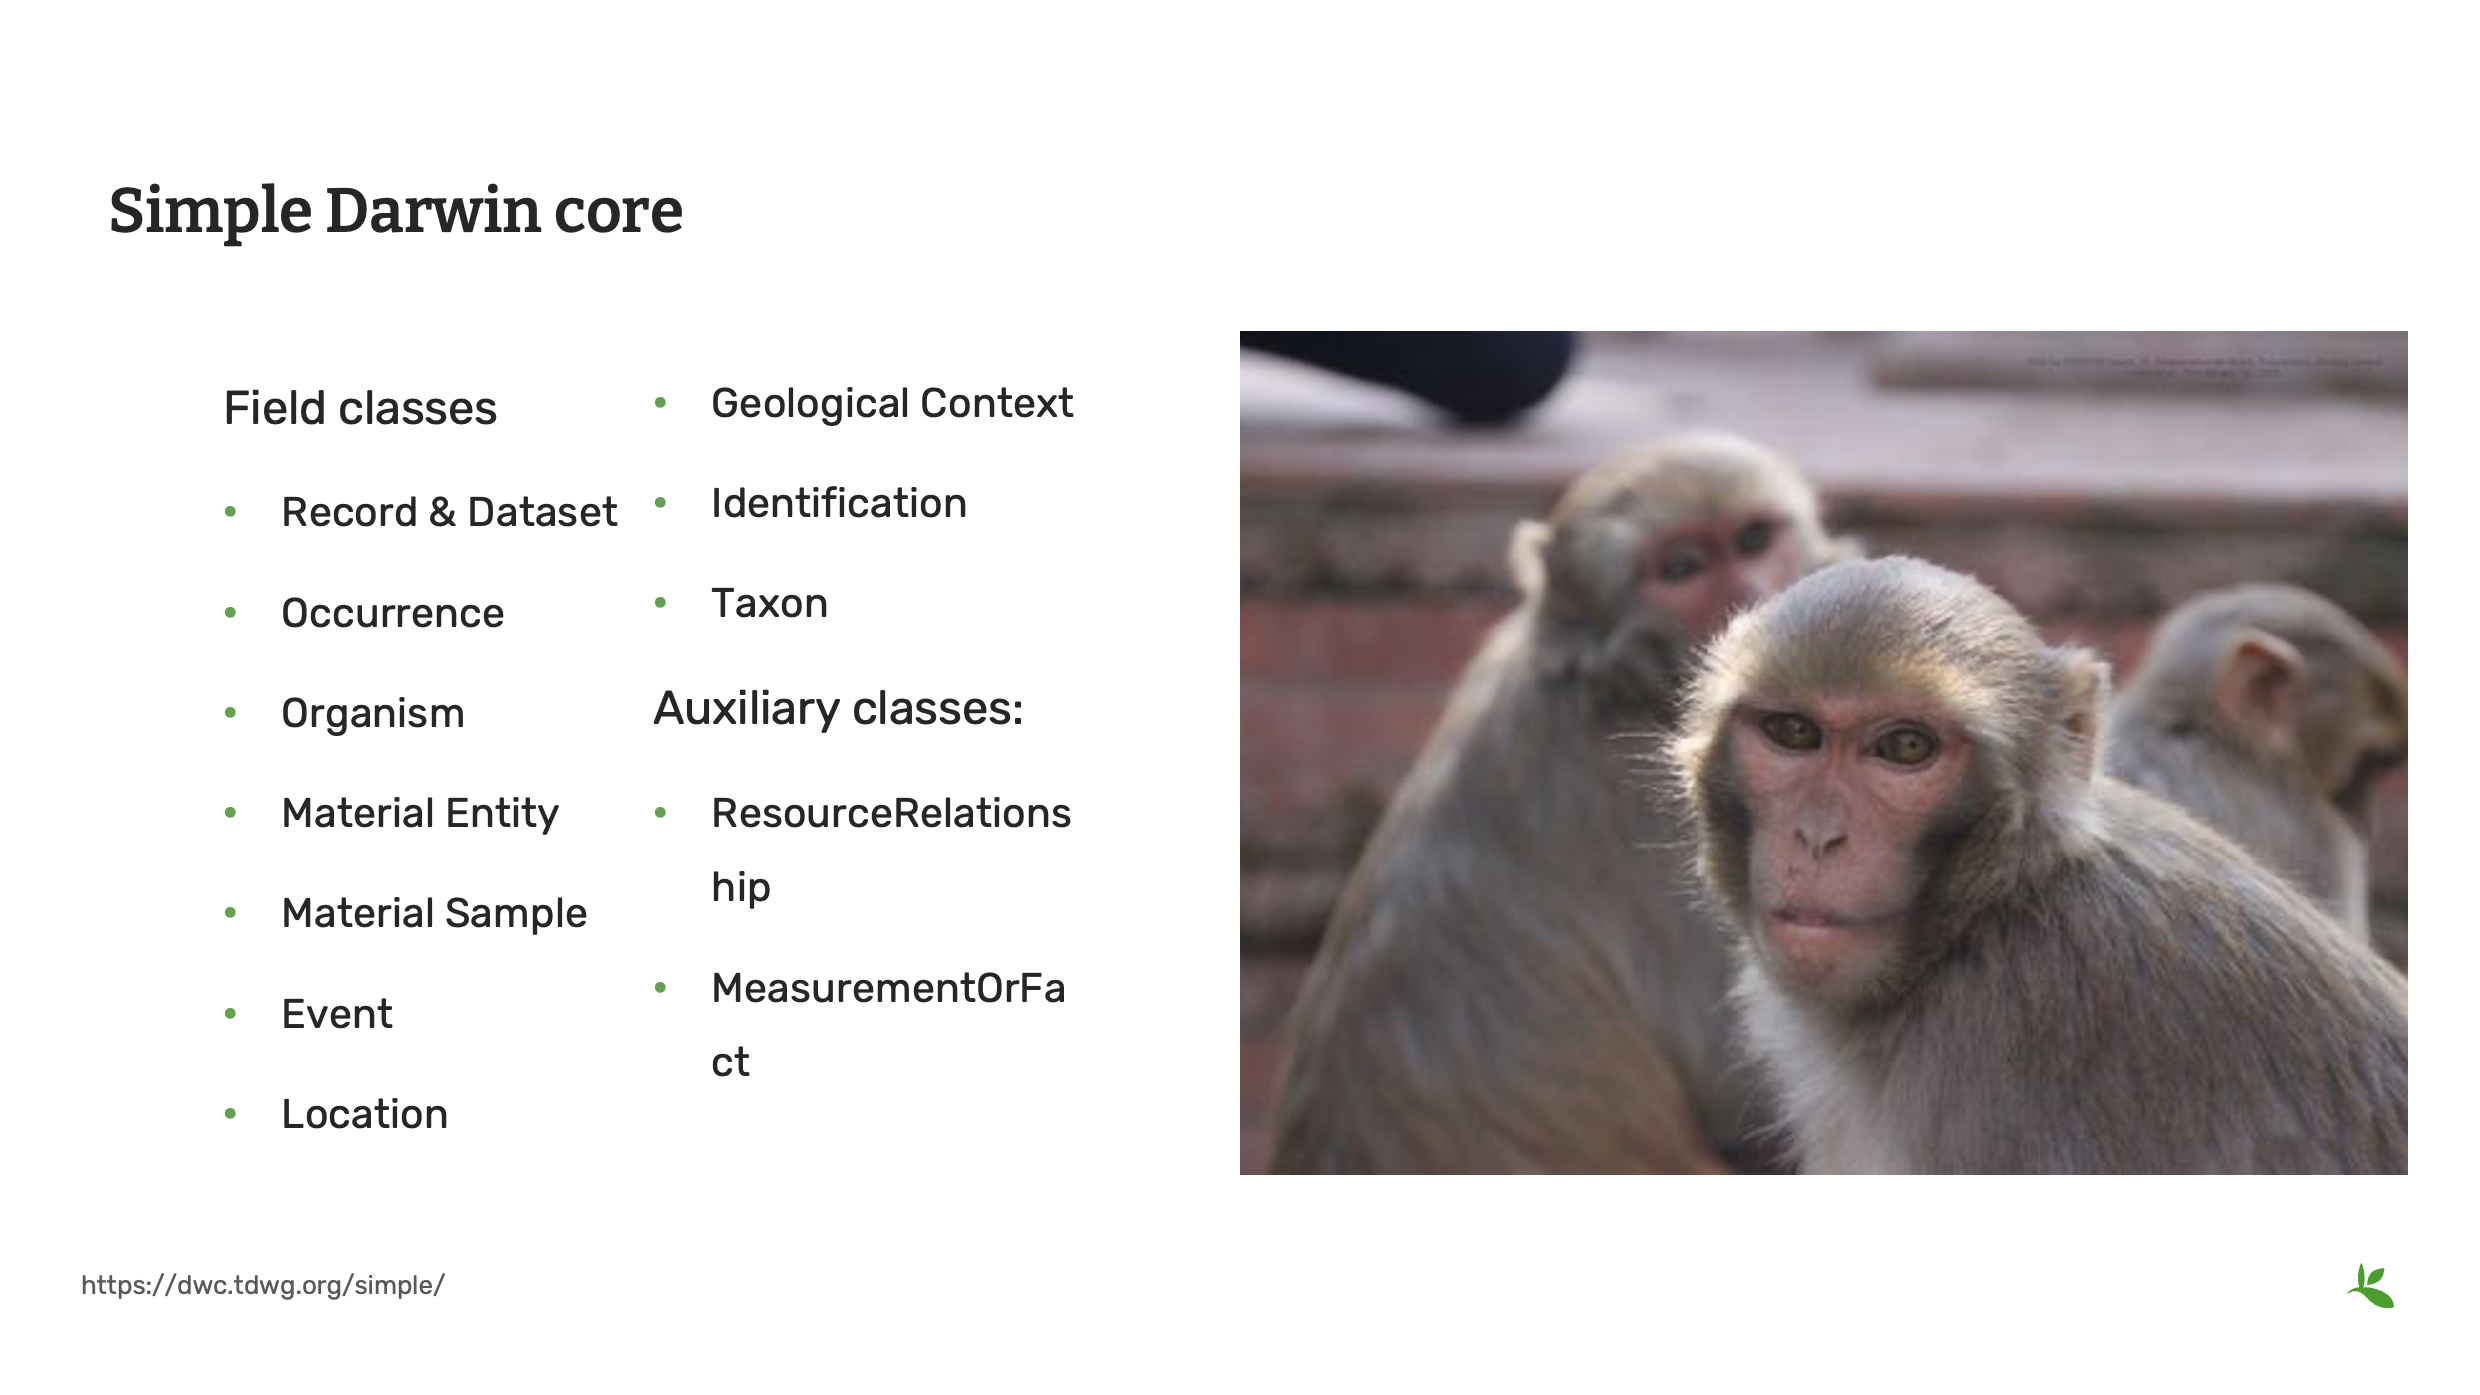
Слайд 10 — Простой формат Darwin Core
По мере более подробного знакомства с Darwin Core, или сокращенно DwC, вы увидите, что это не ПРОСТО список полей. Мы будем использовать Simple Darwin Core — заранее определённый набор терминов, широко применяемых в самых разных областях работы с данными о биоразнообразии.
Данное подмножество включает более 150 полей, объединённых в следующие классы:
Запись и набор данных; Встречаемость; Организм; Материал; Объект; Образец; Событие; Местонахождение; Геологический контекст; Идентификация; Таксон
Кроме того, существуют два вспомогательных класса с названиями:
ResourceRelationship MeasurementOrFact
Из руководства пользователя «Simple Darwin Core считается „простым“, поскольку не предполагает (и не допускает) никакой структуры, кроме строк и столбцов, которые можно рассматривать как атрибуты и их значения либо как поля и записи».
Фото: Macaca mulatta (Zimmermann, 1780) Снято в Непале Vladimir Tkalčić (http://creativecommons.org/licenses/by-nc/4.0/)
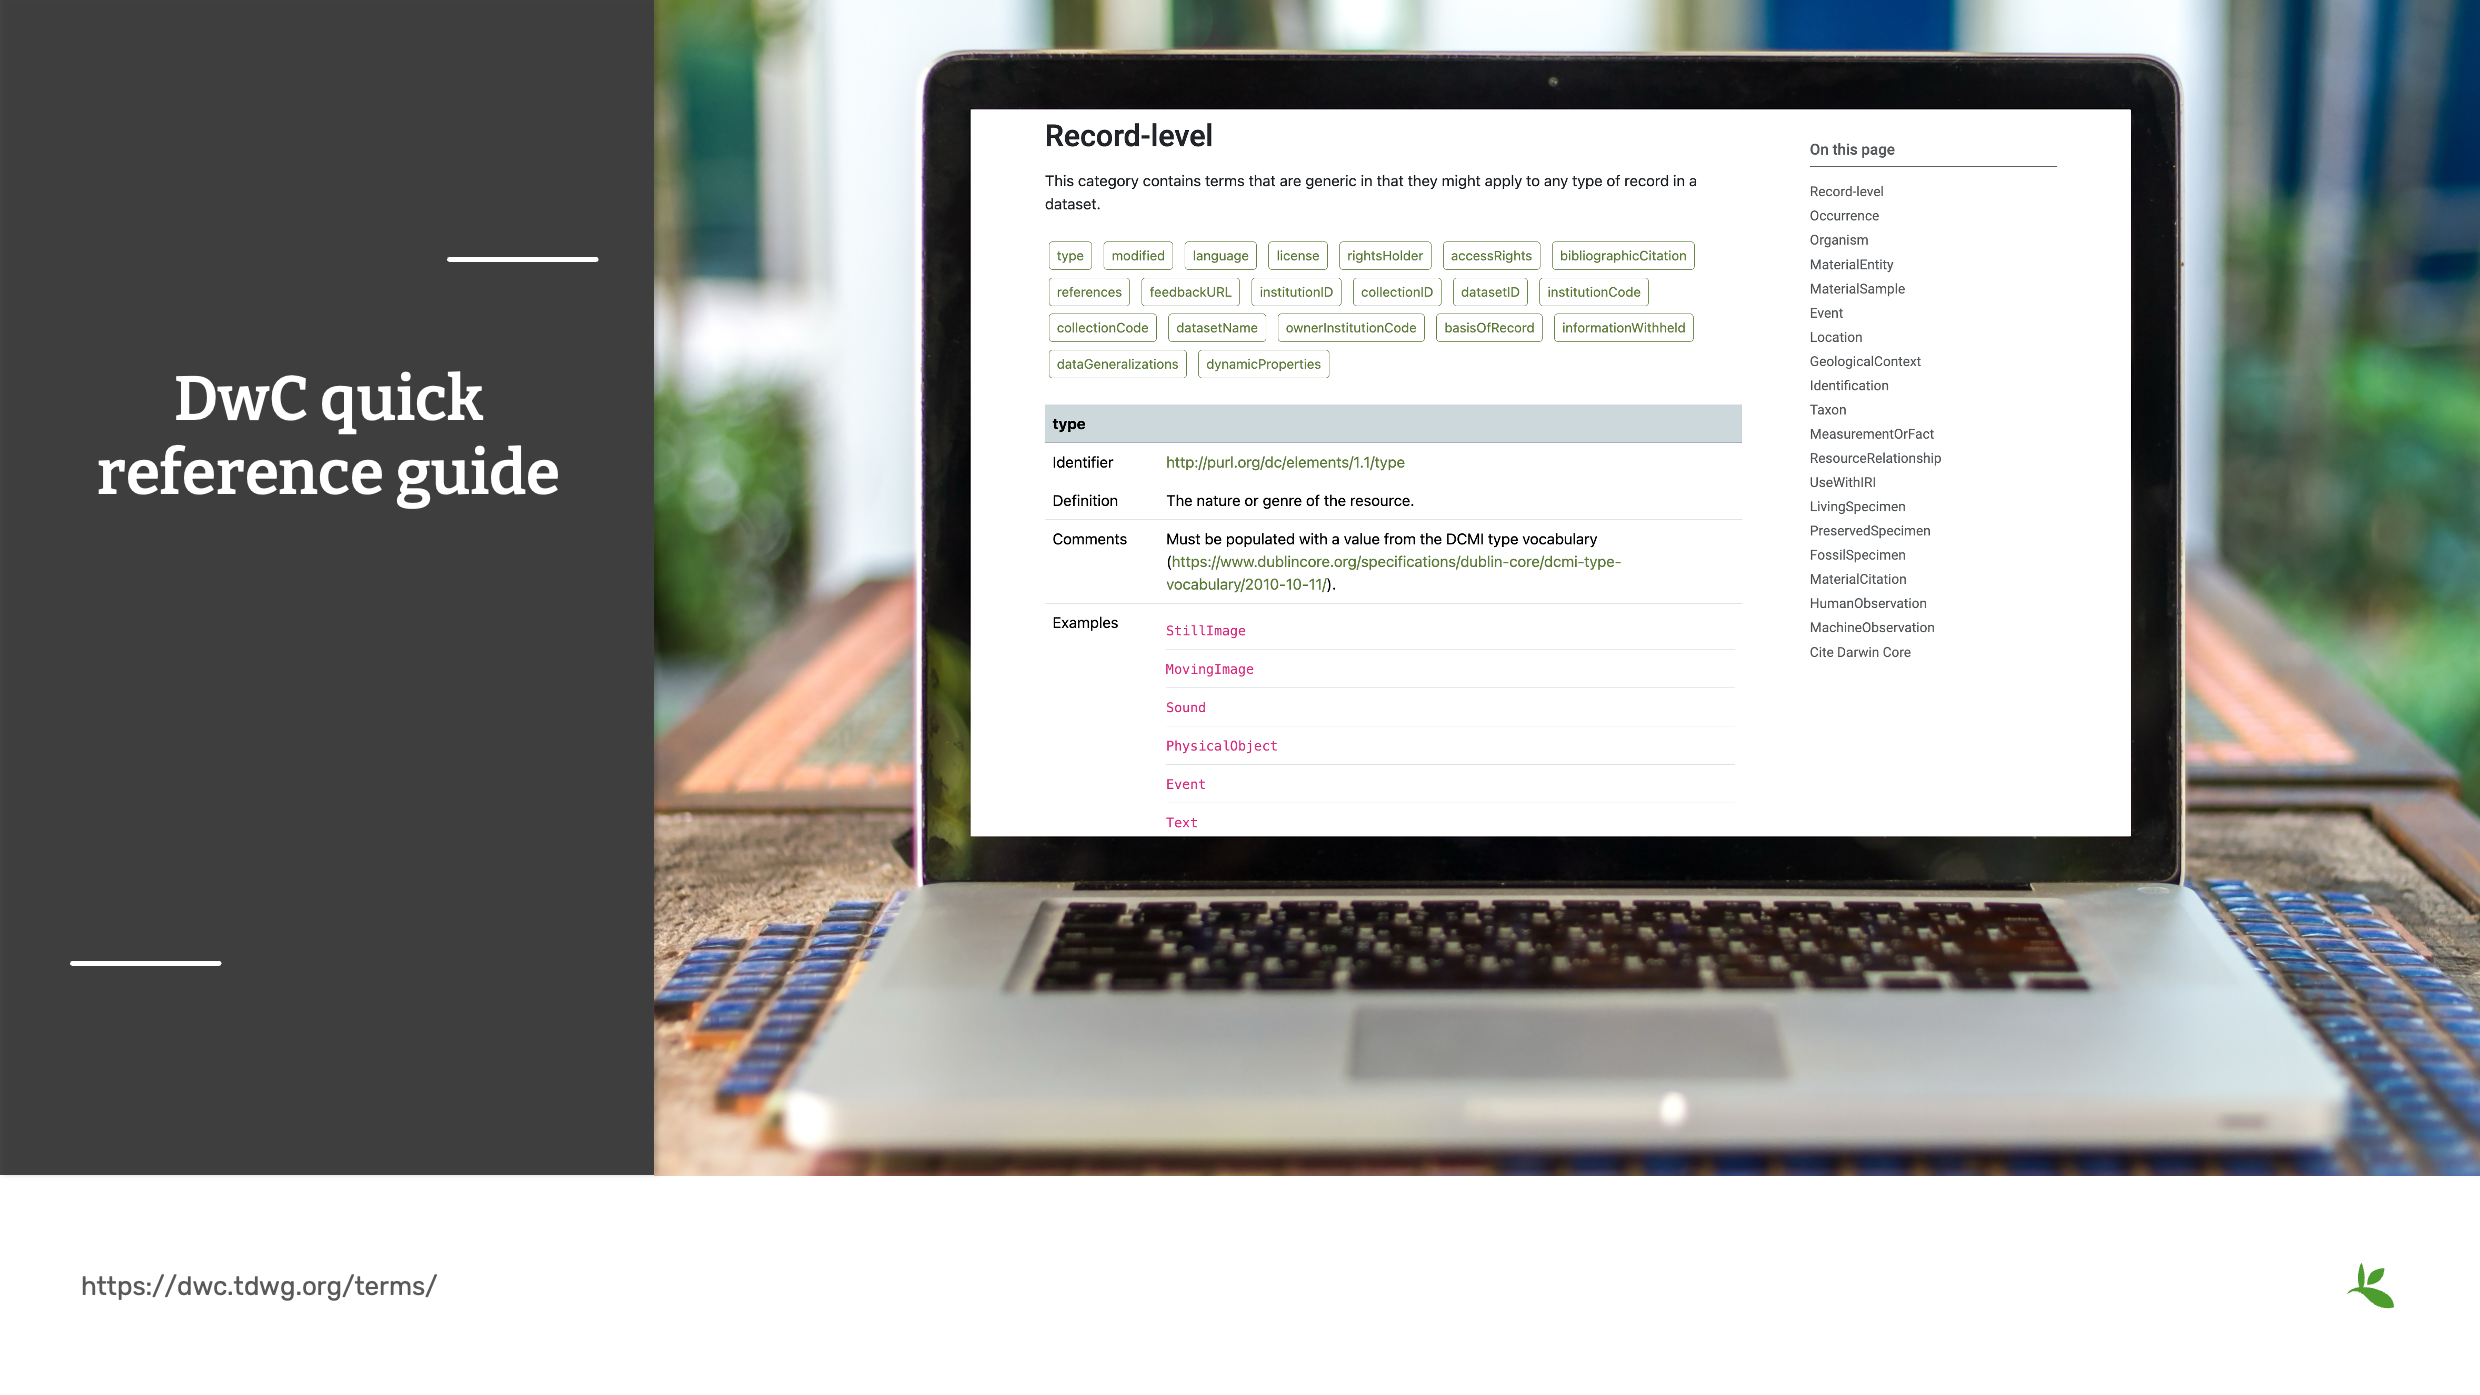
Слайд 11 — Краткое руководство по Darwin Core
Краткий справочник по DwC вскоре станет одним из ваших основных рабочих ресурсов. На этой странице представлен перечень всех рекомендуемых в настоящее время терминов стандарта Darwin Core. Такие категории, как Occurrence (находка) или Event (событие), соответствуют классам Darwin Core, объединяющим связанные с ними термины.
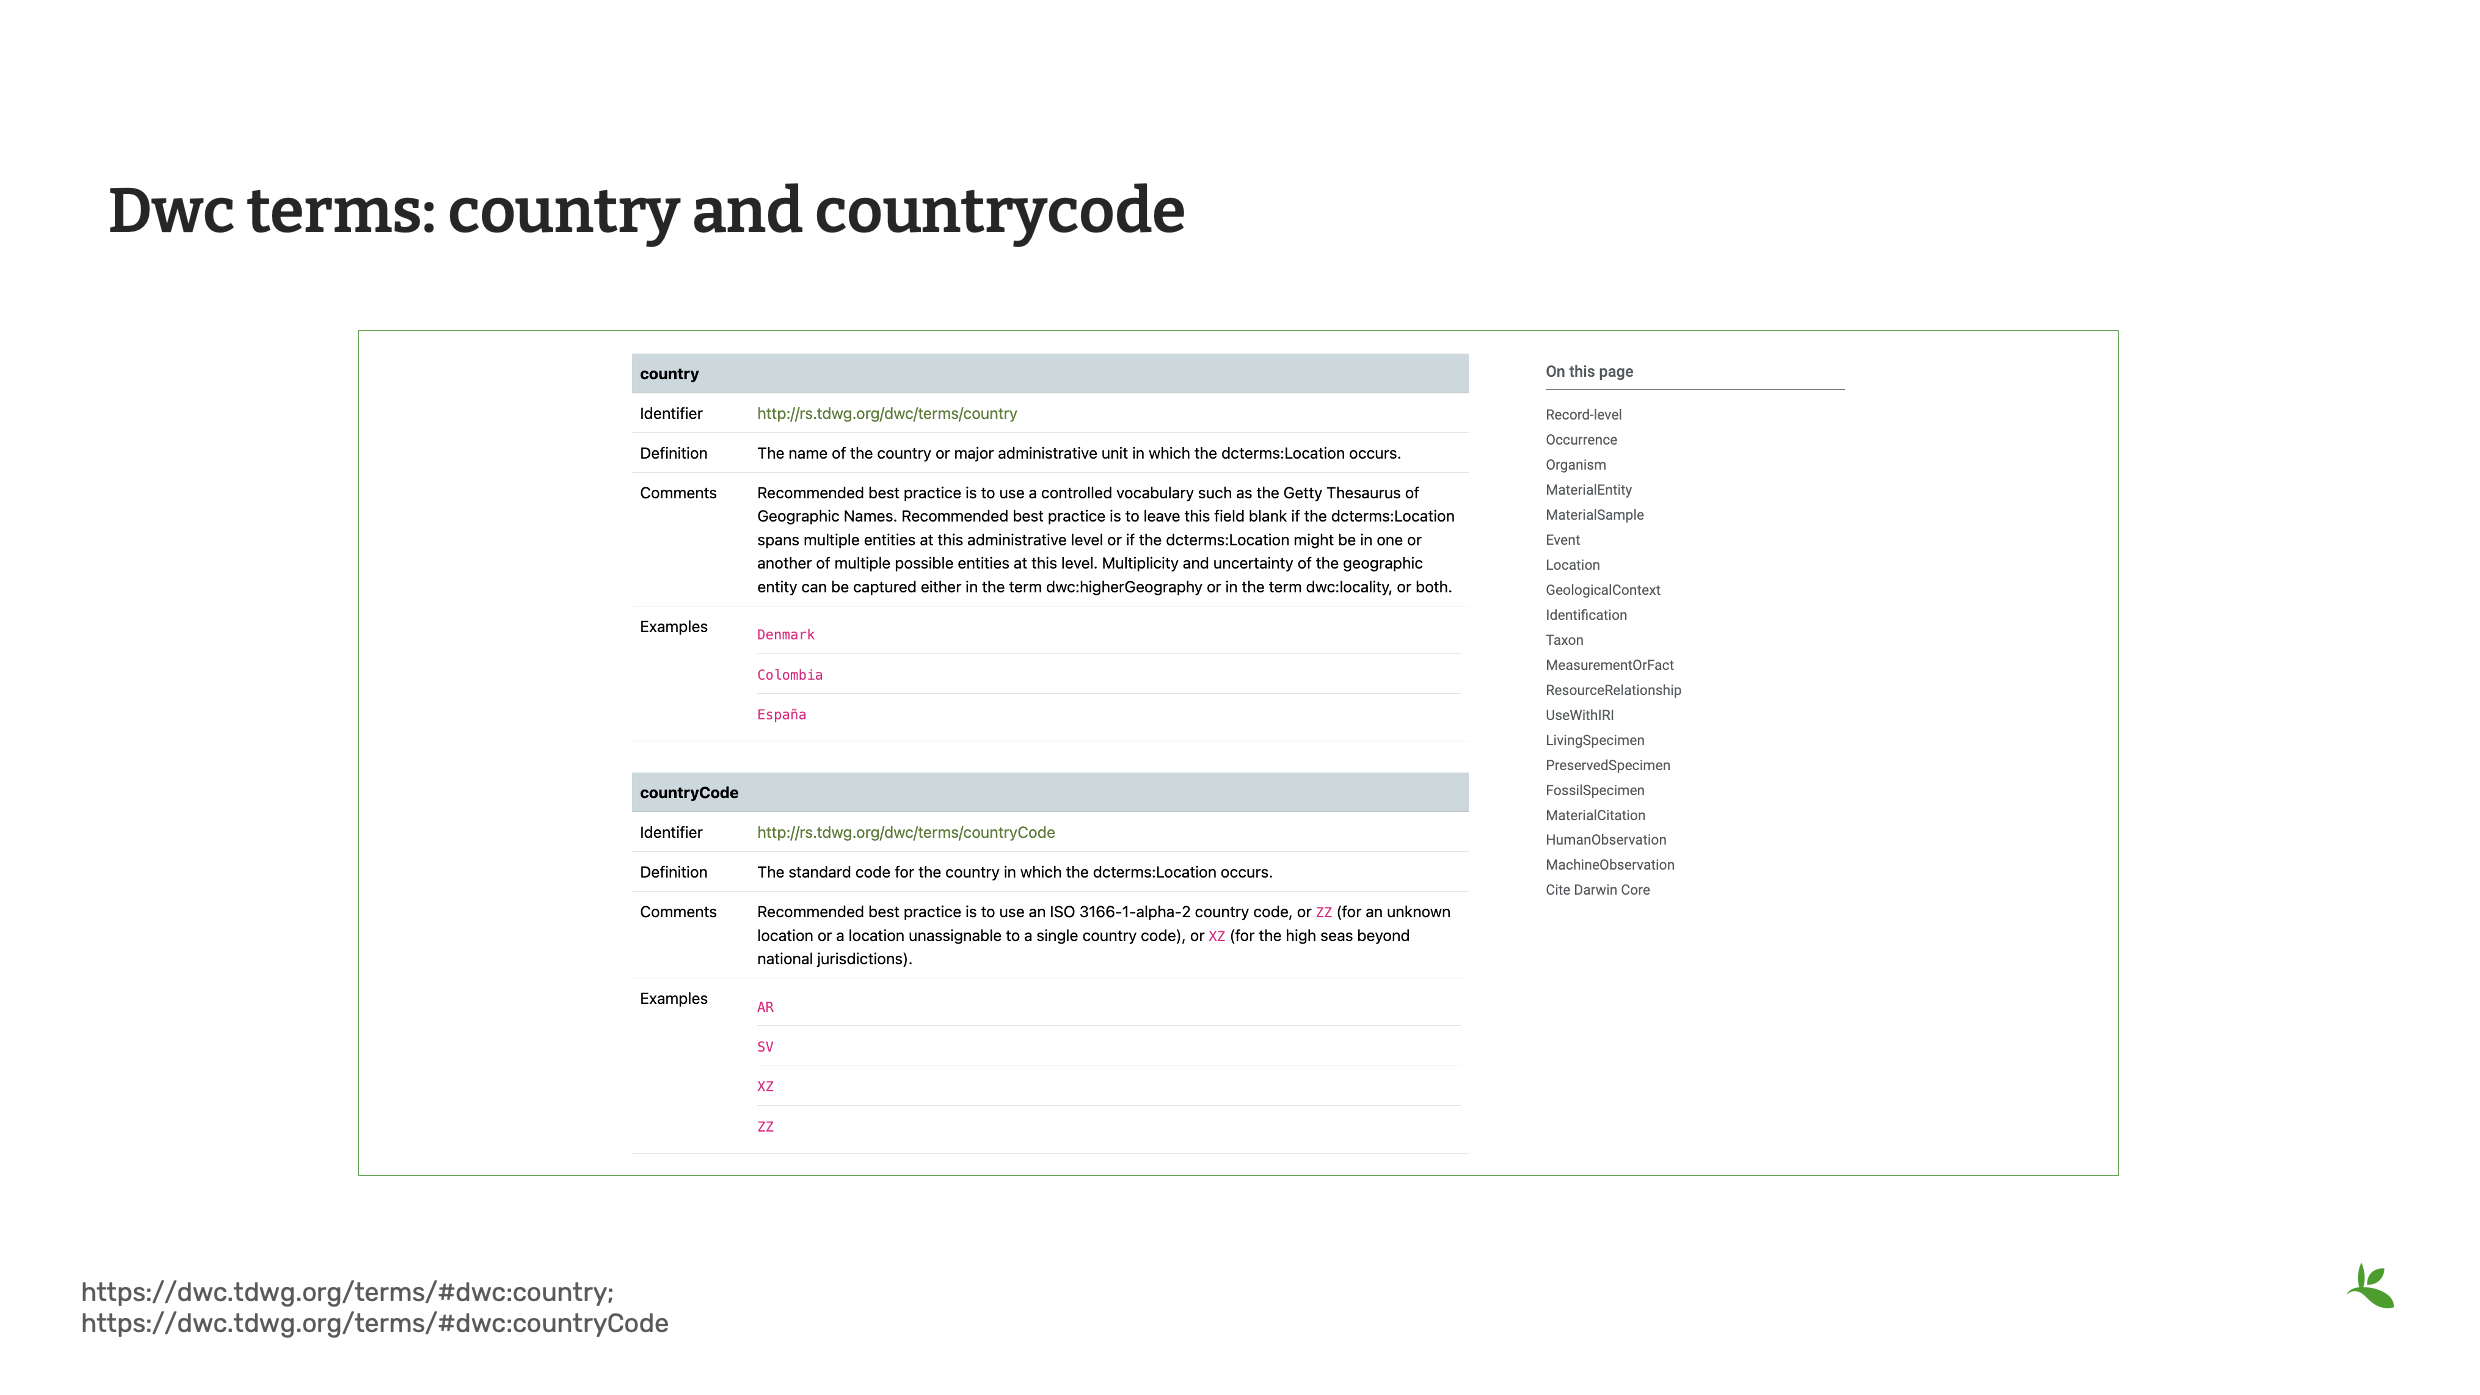
Слайд 12 — Термины DwC: «country» и «countryCode»
Теперь рассмотрим несколько примеров терминов Darwin Core. В кратком справочнике для каждого термина приводятся его идентификатор, определение, комментарии и примеры. Сначала мы рассмотрим термины Country и CountryCode из категории Location.
Как правило, исходные данные содержат поле с названием страны. Однако значения в этом поле нередко бывают неоднородными: встречаются опечатки, сокращения и исторические названия. В то же время это один из элементов данных, который проще всего стандартизировать. Как указано в комментариях, рекомендуется использовать контролируемый словарь, например Getty Thesaurus of Geographic Names. Контролируемый словарь ограничивает набор значений, допустимых для данного термина.
Поле CountryCode, как правило, отсутствует в исходных данных владельца. Однако его также легко заполнить, поскольку в комментариях рекомендуется использовать двухбуквенный код страны в соответствии со стандартом ISO 3166-1 alpha-2.
GBIF настоятельно рекомендует указывать код страны (CountryCode) в наборах данных о находках организмов. Также рекомендуется указывать страну.
Подробнее о требованиях и рекомендациях GBIF вы узнаете в следующих разделах курса.
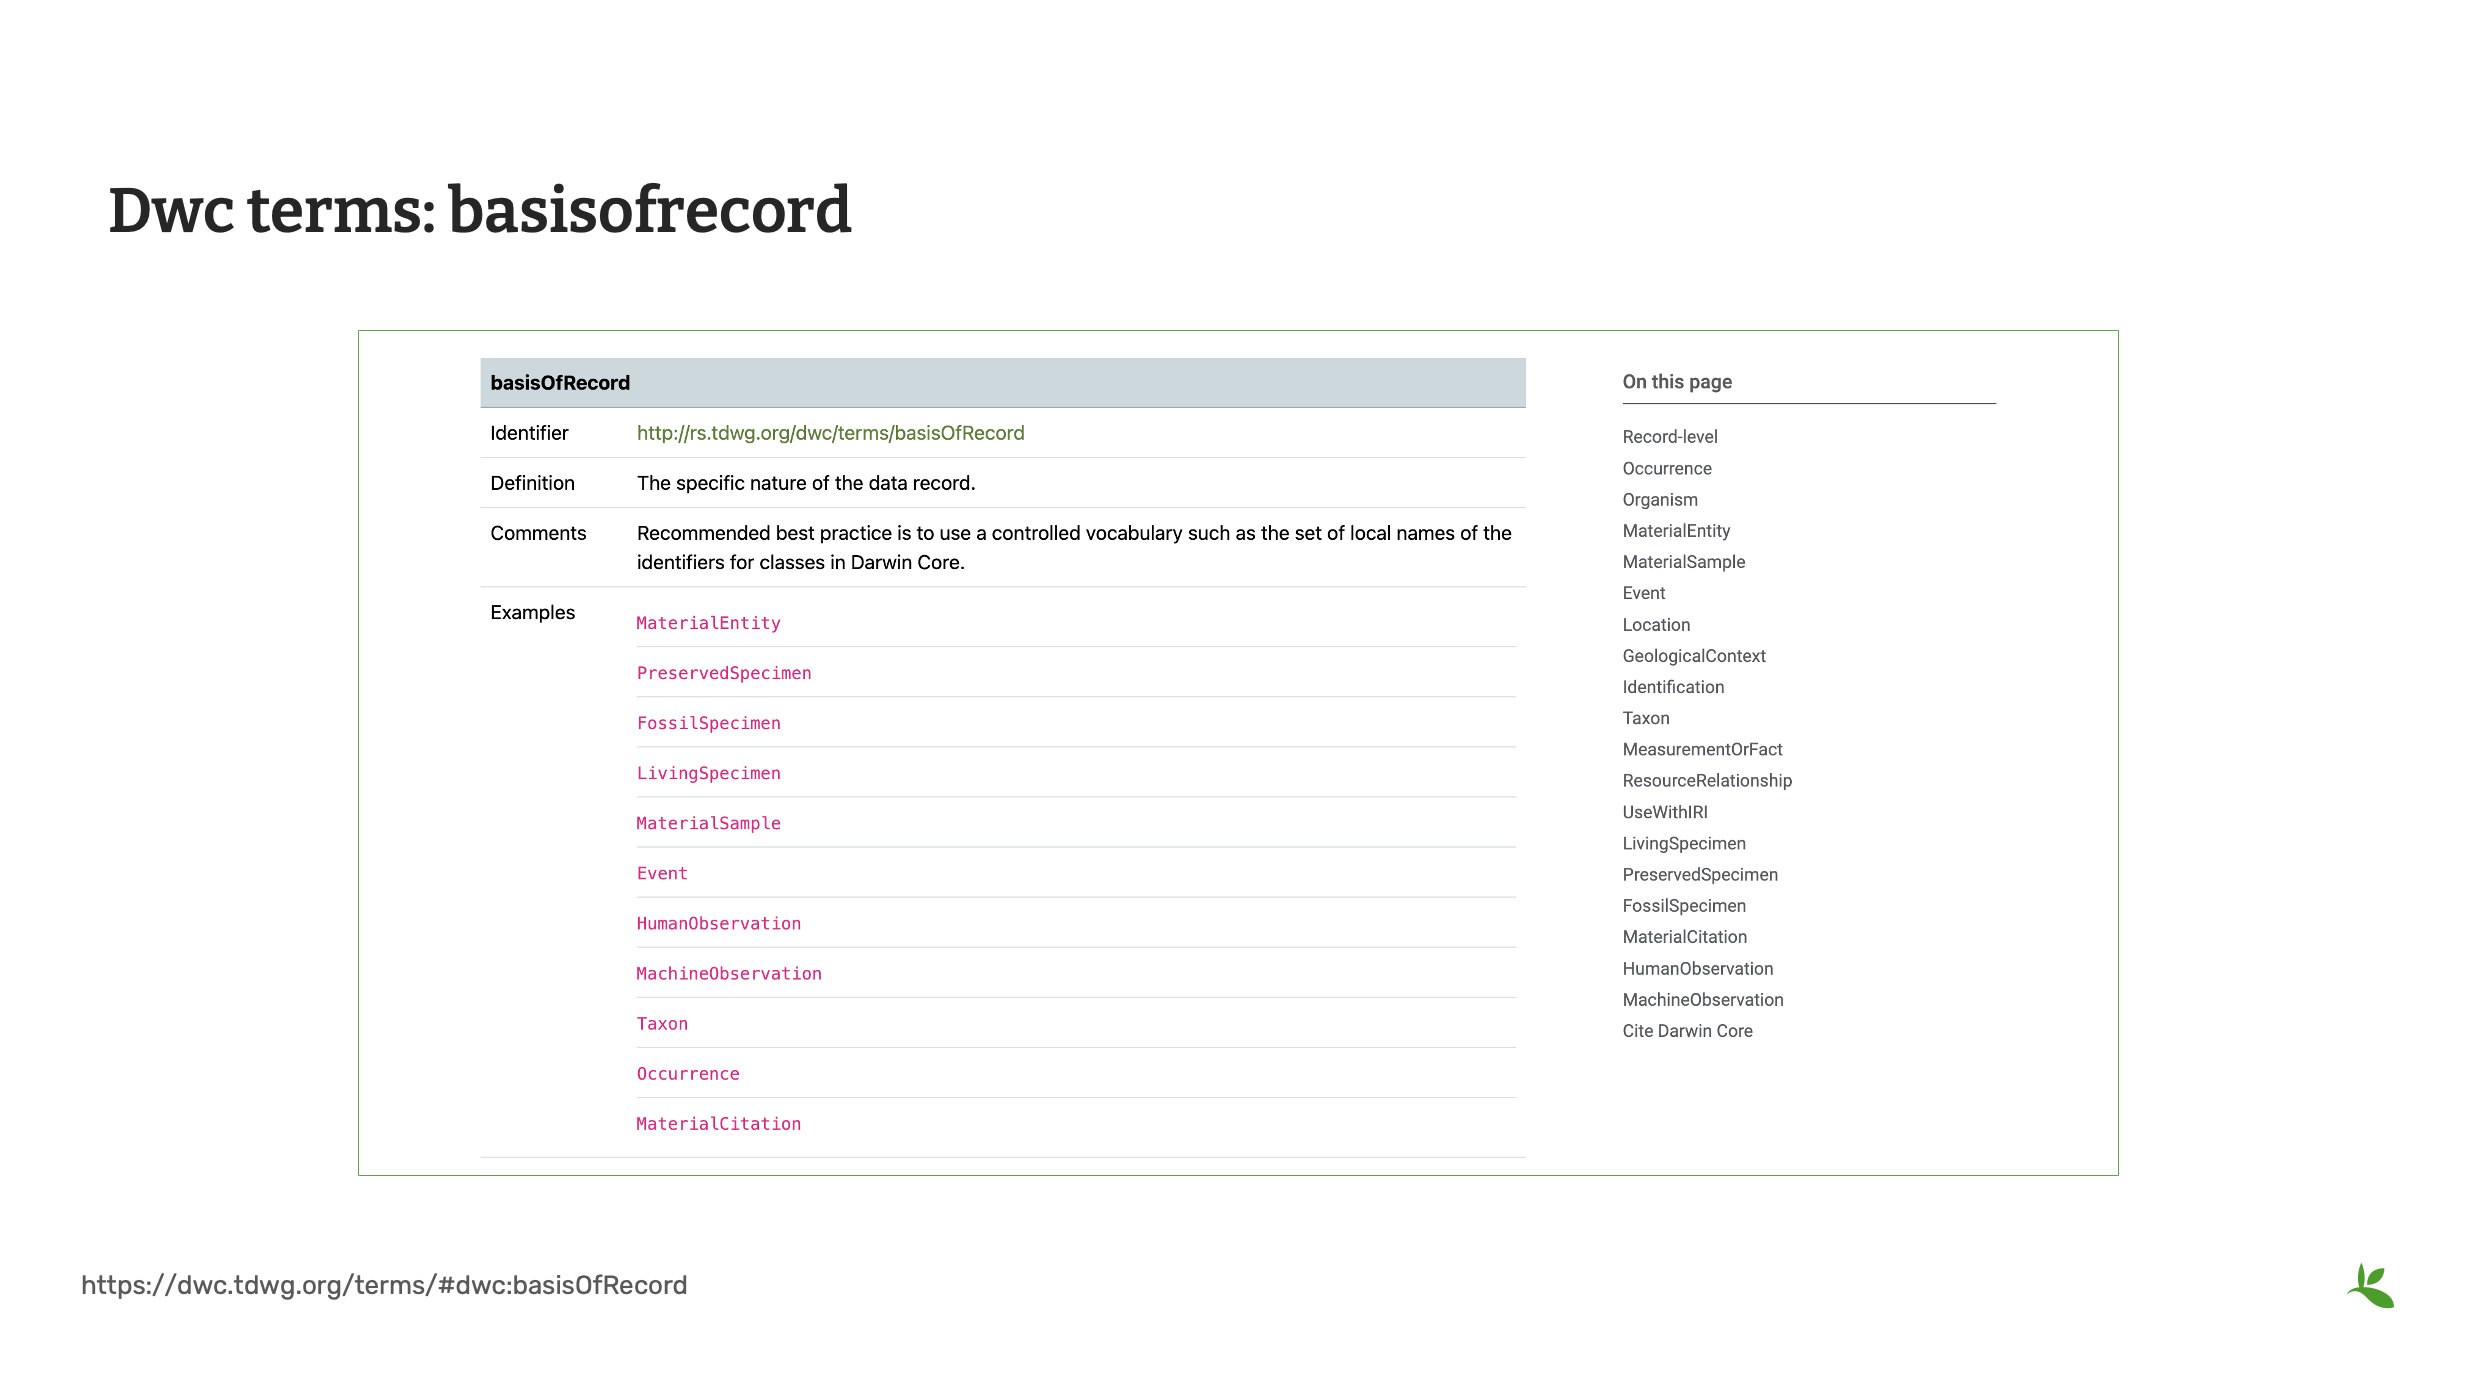
Слайд 13 — Термины DwC: basisOfRecord
Он определяет характер каждой записи в наборе данных. Для basisOfRecord используется контролируемый словарь. Допустимые значения: PreservedSpecimen, FossilSpecimen, LivingSpecimen, MaterialSample, Event, HumanObservation, MachineObservation, Taxon или Occurrence. GBIF требует обязательного указания basisOfRecord при публикации наборов данных о находках организмов.
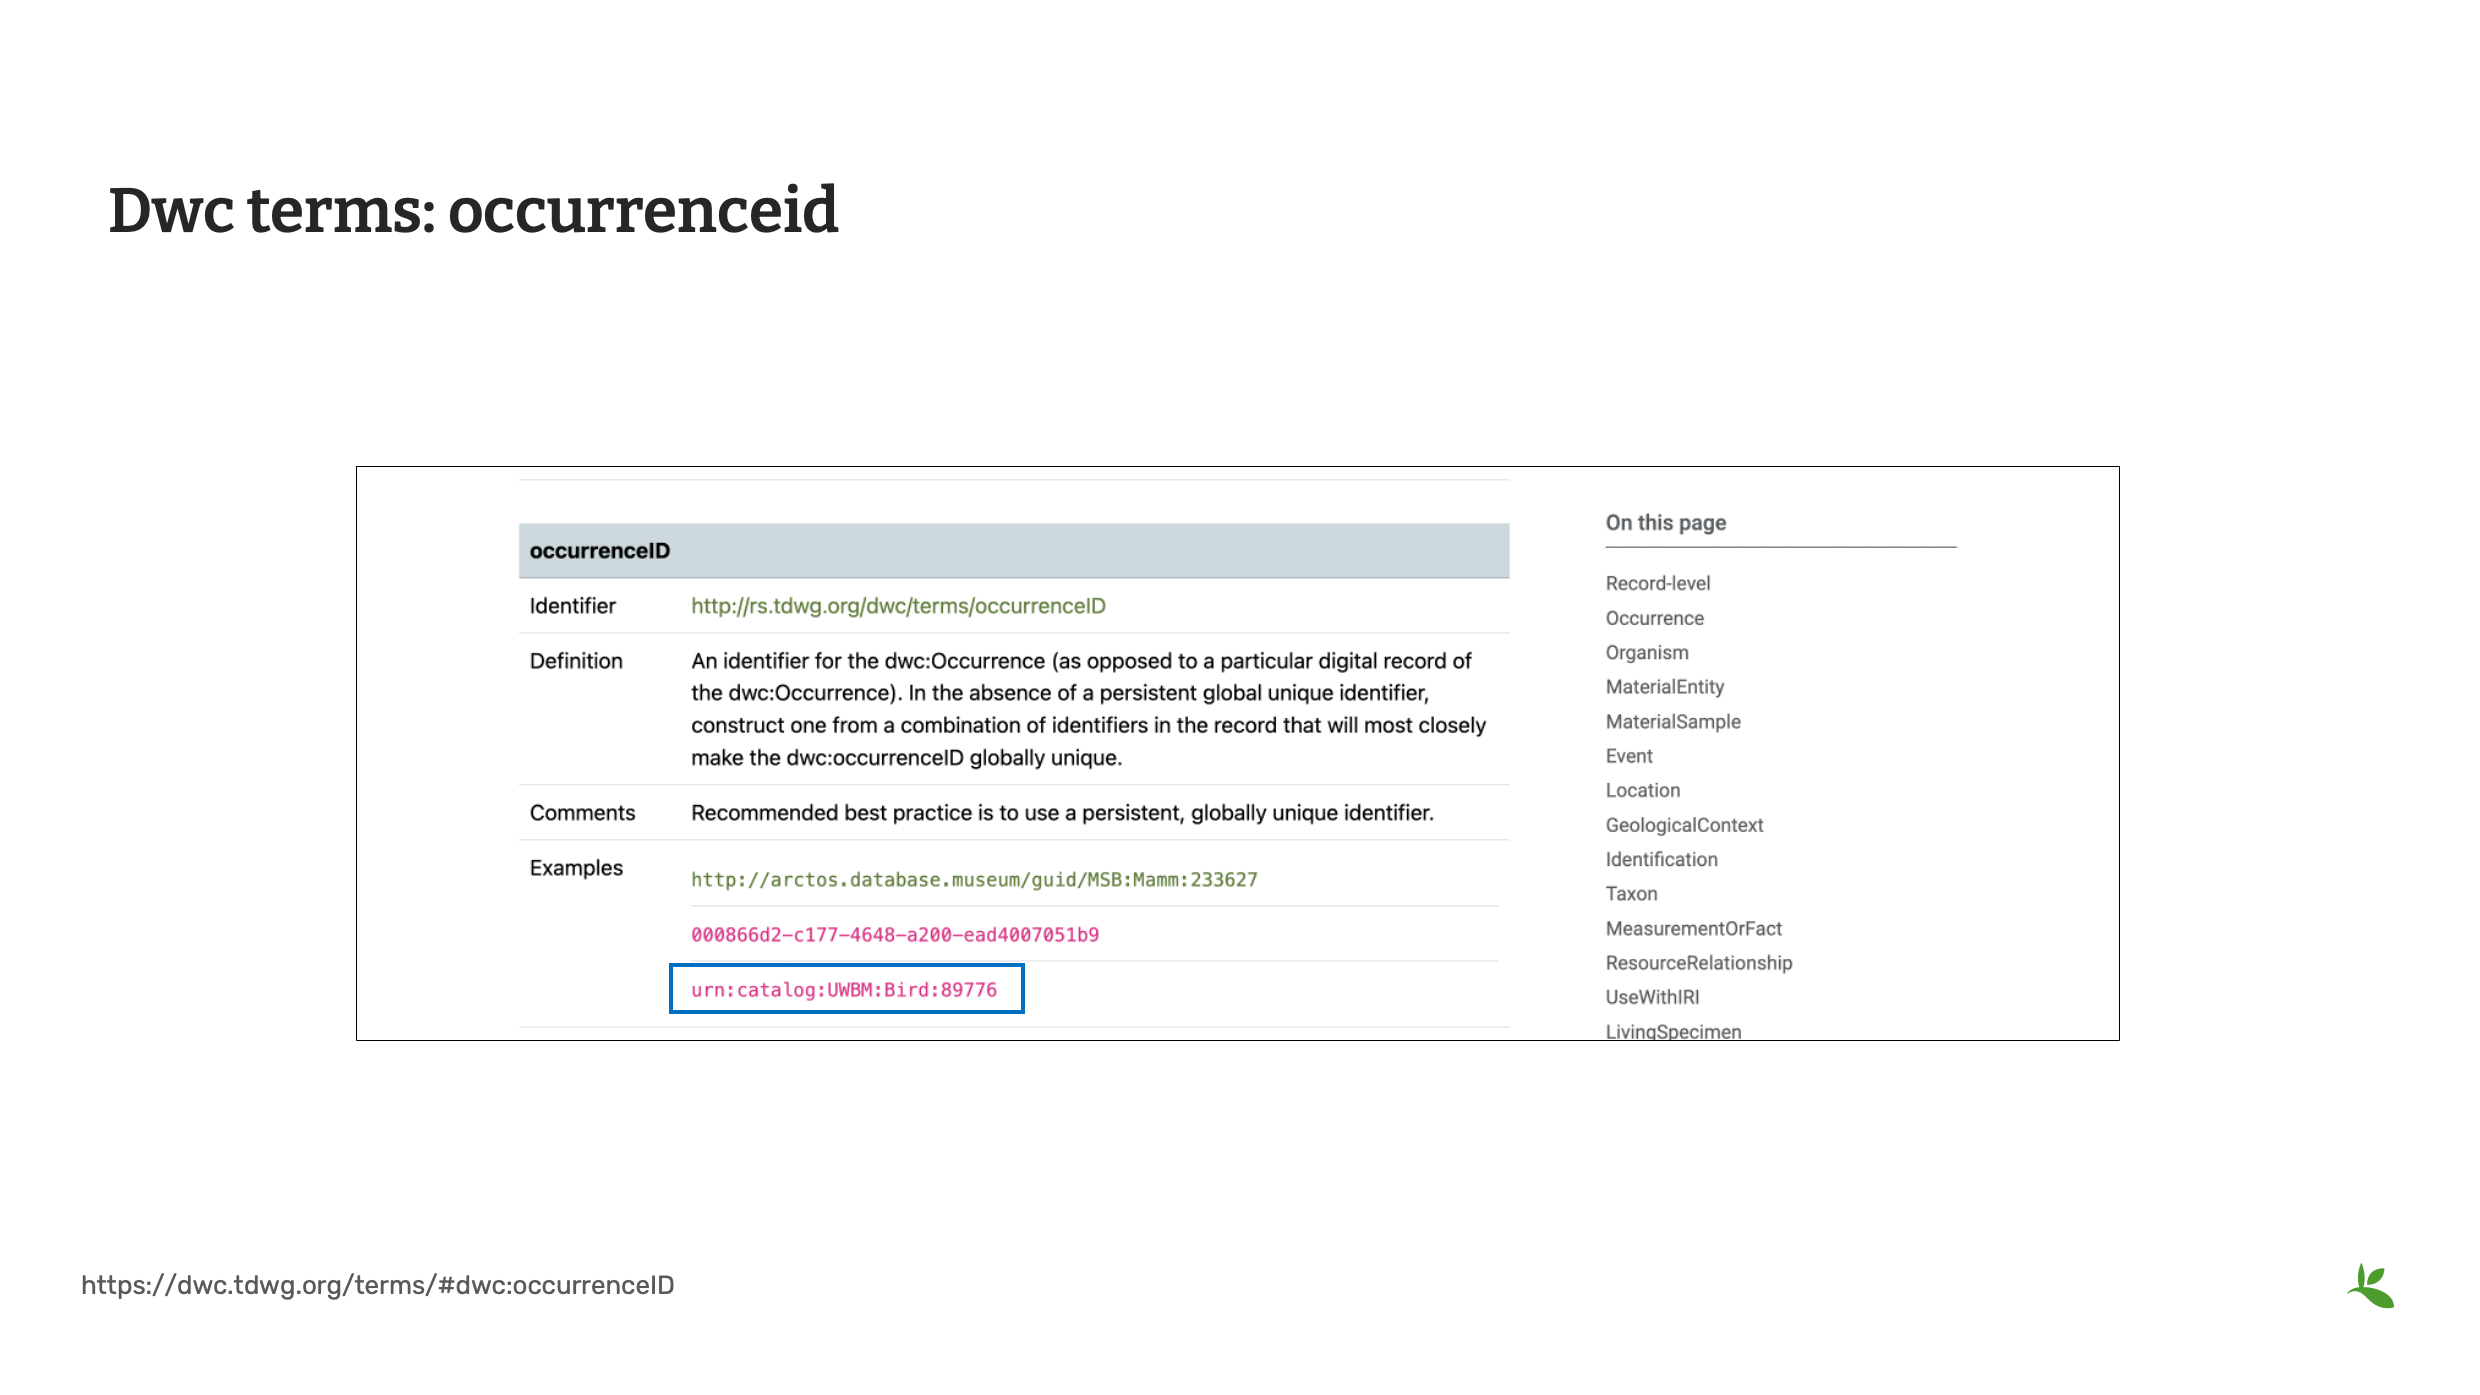
Слайд 14 — Термин DwC: occurrenceID
Последним термином, который мы рассмотрим, является occurrenceID. При публикации записей о находках GBIF требует указания occurrenceID. OccurrenceID — это идентификатор самой находки, а не цифровой записи о ней. Рекомендуется использовать глобально уникальный идентификатор, также известный как GUID. При отсутствии GUID уникальный идентификатор может быть сформирован из других идентификаторов, содержащихся в наборе данных. В Интернете существуют инструменты, позволяющие генерировать GUID для ваших записей. Если вы используете этот способ, сгенерированные GUID следует добавить в исходные данные в качестве постоянного поля, однозначно идентифицирующего каждую запись. В практической части этого курса вы создадите occurrenceID в формате, аналогичном третьему примеру в синем поле.
Слайд 15 — Расширения Darwin Core
При использовании Simple Darwin Core вы можете обнаружить, что у вас есть дополнительные данные, которыми вы хотели бы поделиться, но не можете найти для них соответствующих терминов в DwC. Это могут быть изображения или звуковые файлы. Возможно, вы работаете с коллекцией позвоночных и располагаете подробными данными о массе и размерах экземпляров. Или у вас имеется детальная историческая информация об определении таксона. В таких случаях используются расширения Darwin Core, которые позволяют дополнить основные данные, добавив связанные с ними файлы с дополнительной информацией. Для трёх приведённых примеров подойдут следующие расширения:
Simple Multimedia Measurements или Facts Identification History
Существует множество других расширений. GBIF поддерживает актуальный перечень всех утверждённых расширений и их проектов в разделе инструментов на своём сайте.
Фото: Aleuria aurantia (Pers.) Fuckel Сфотографировано в Непале Elizabeth Byers http://creativecommons.org/licenses/by-nc/4.0/
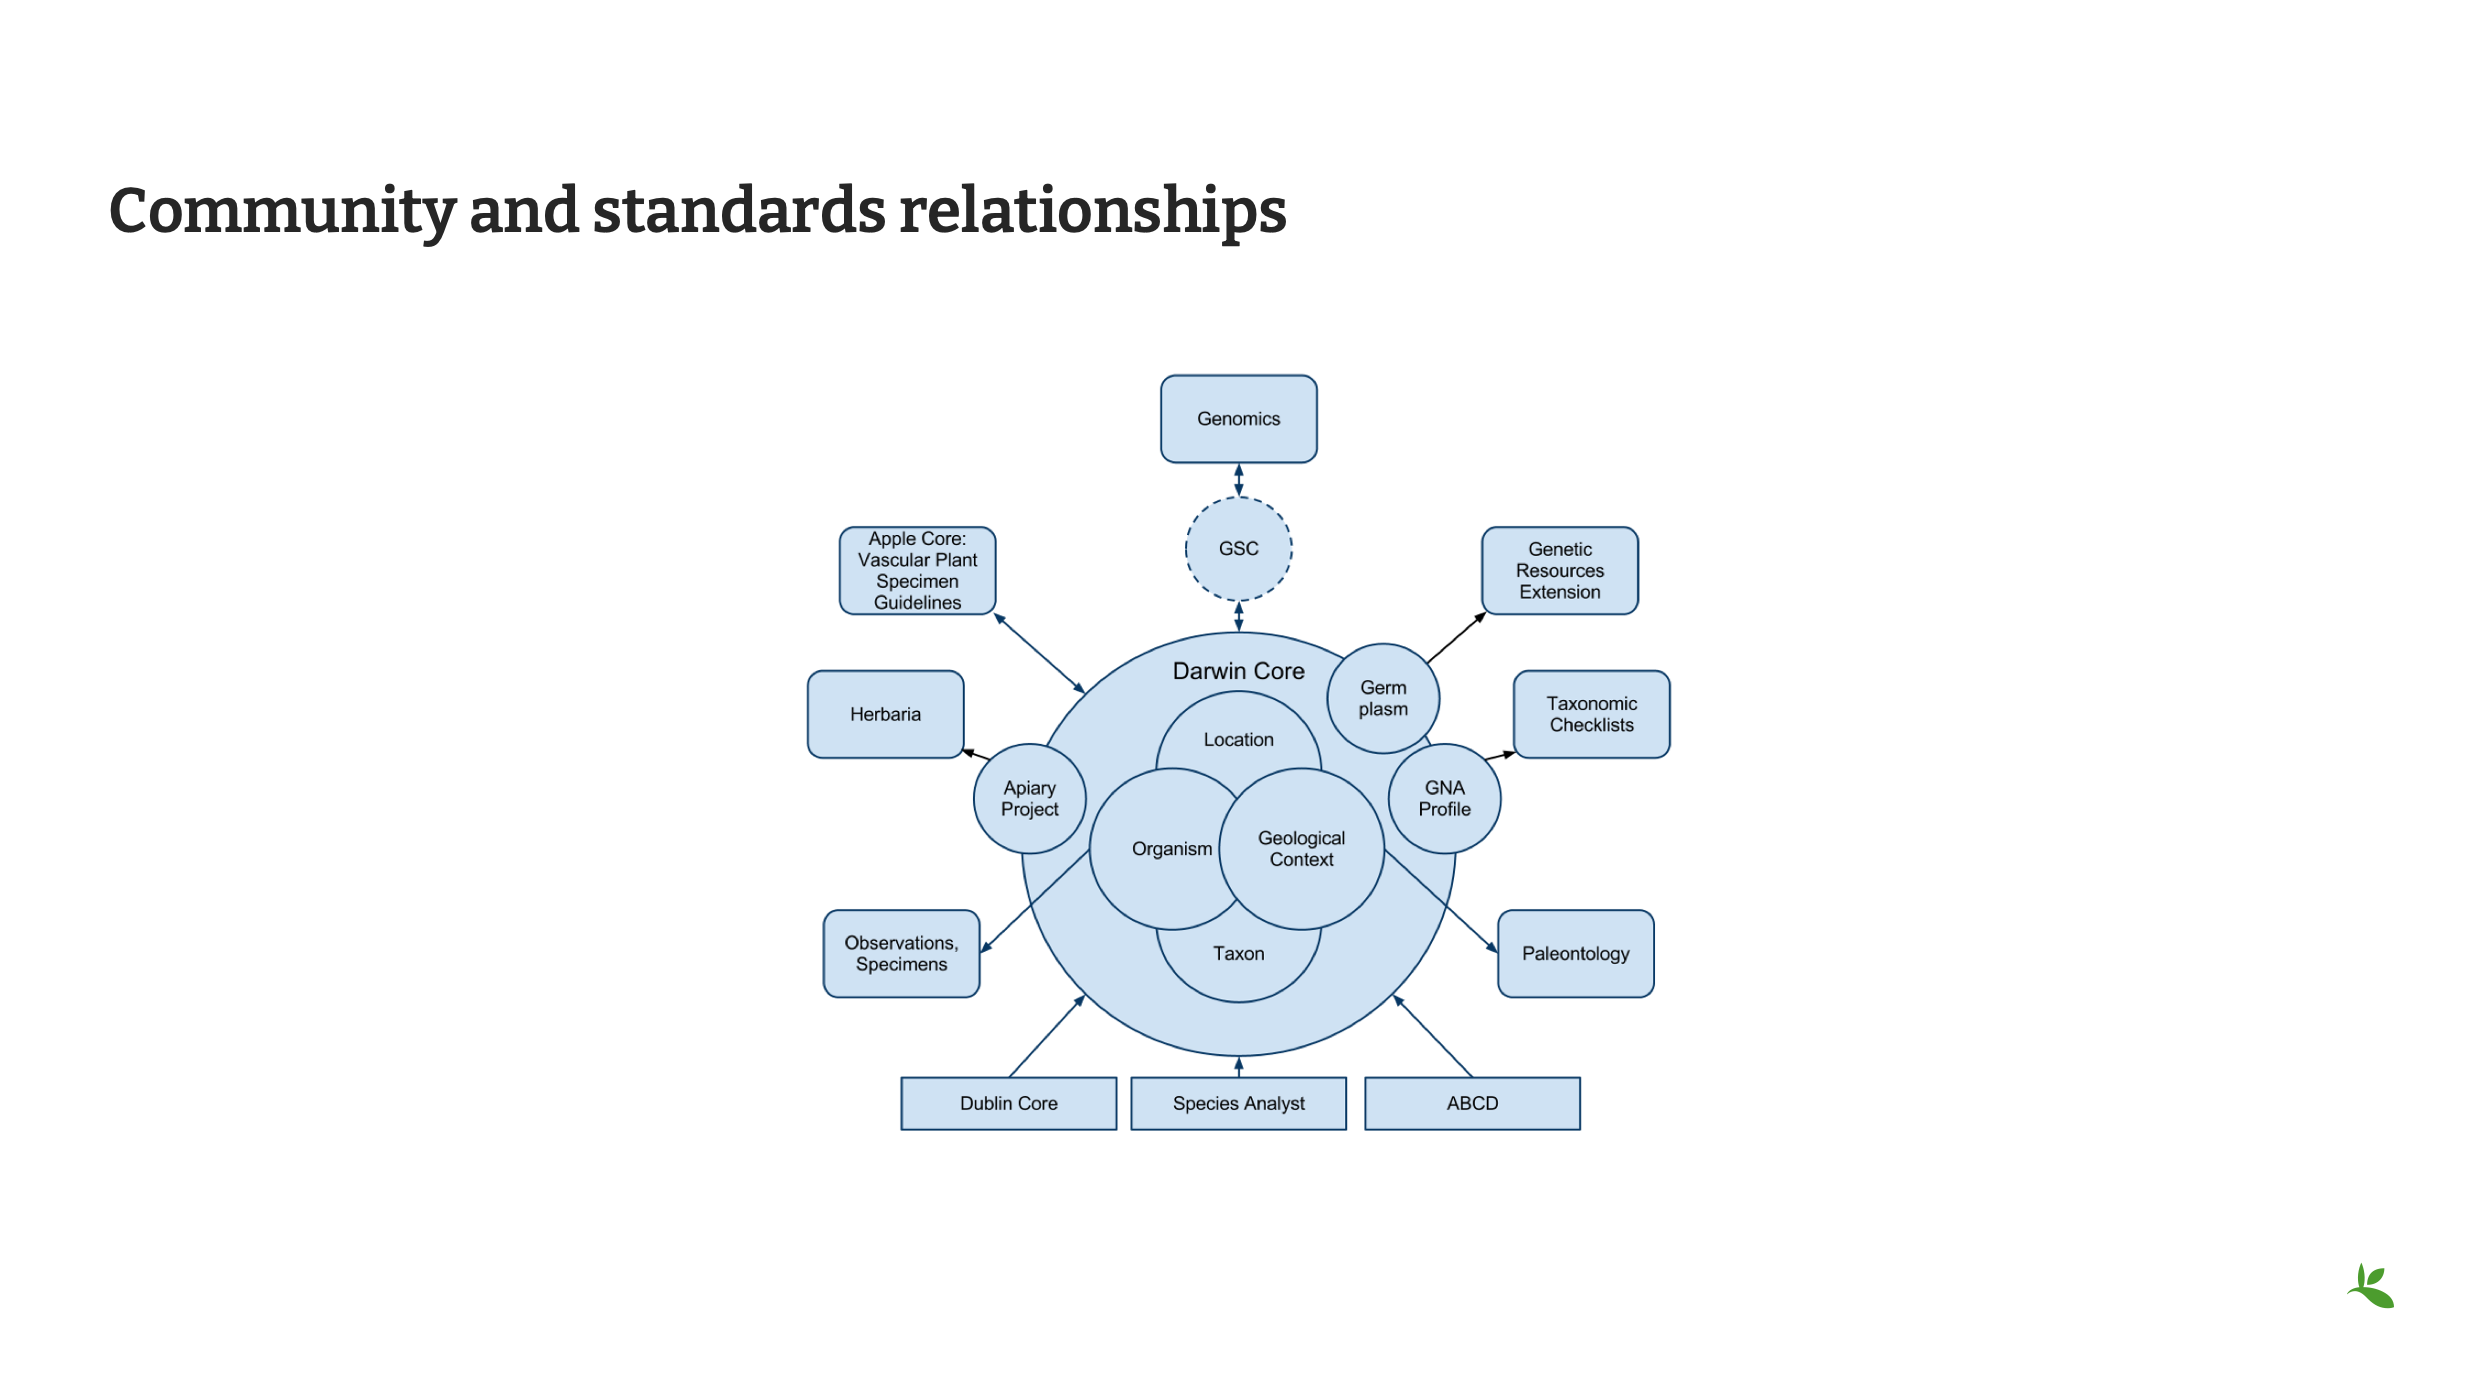
Слайд 16. Взаимосвязь сообщества и стандартов
Сообщество специалистов по информатике биоразнообразия включает множество уровней. На этой схеме показаны взаимосвязи между ними, а также то, как они соотносятся со стандартом Darwin Core и в каких случаях для полноценной публикации данных может потребоваться использование расширений.
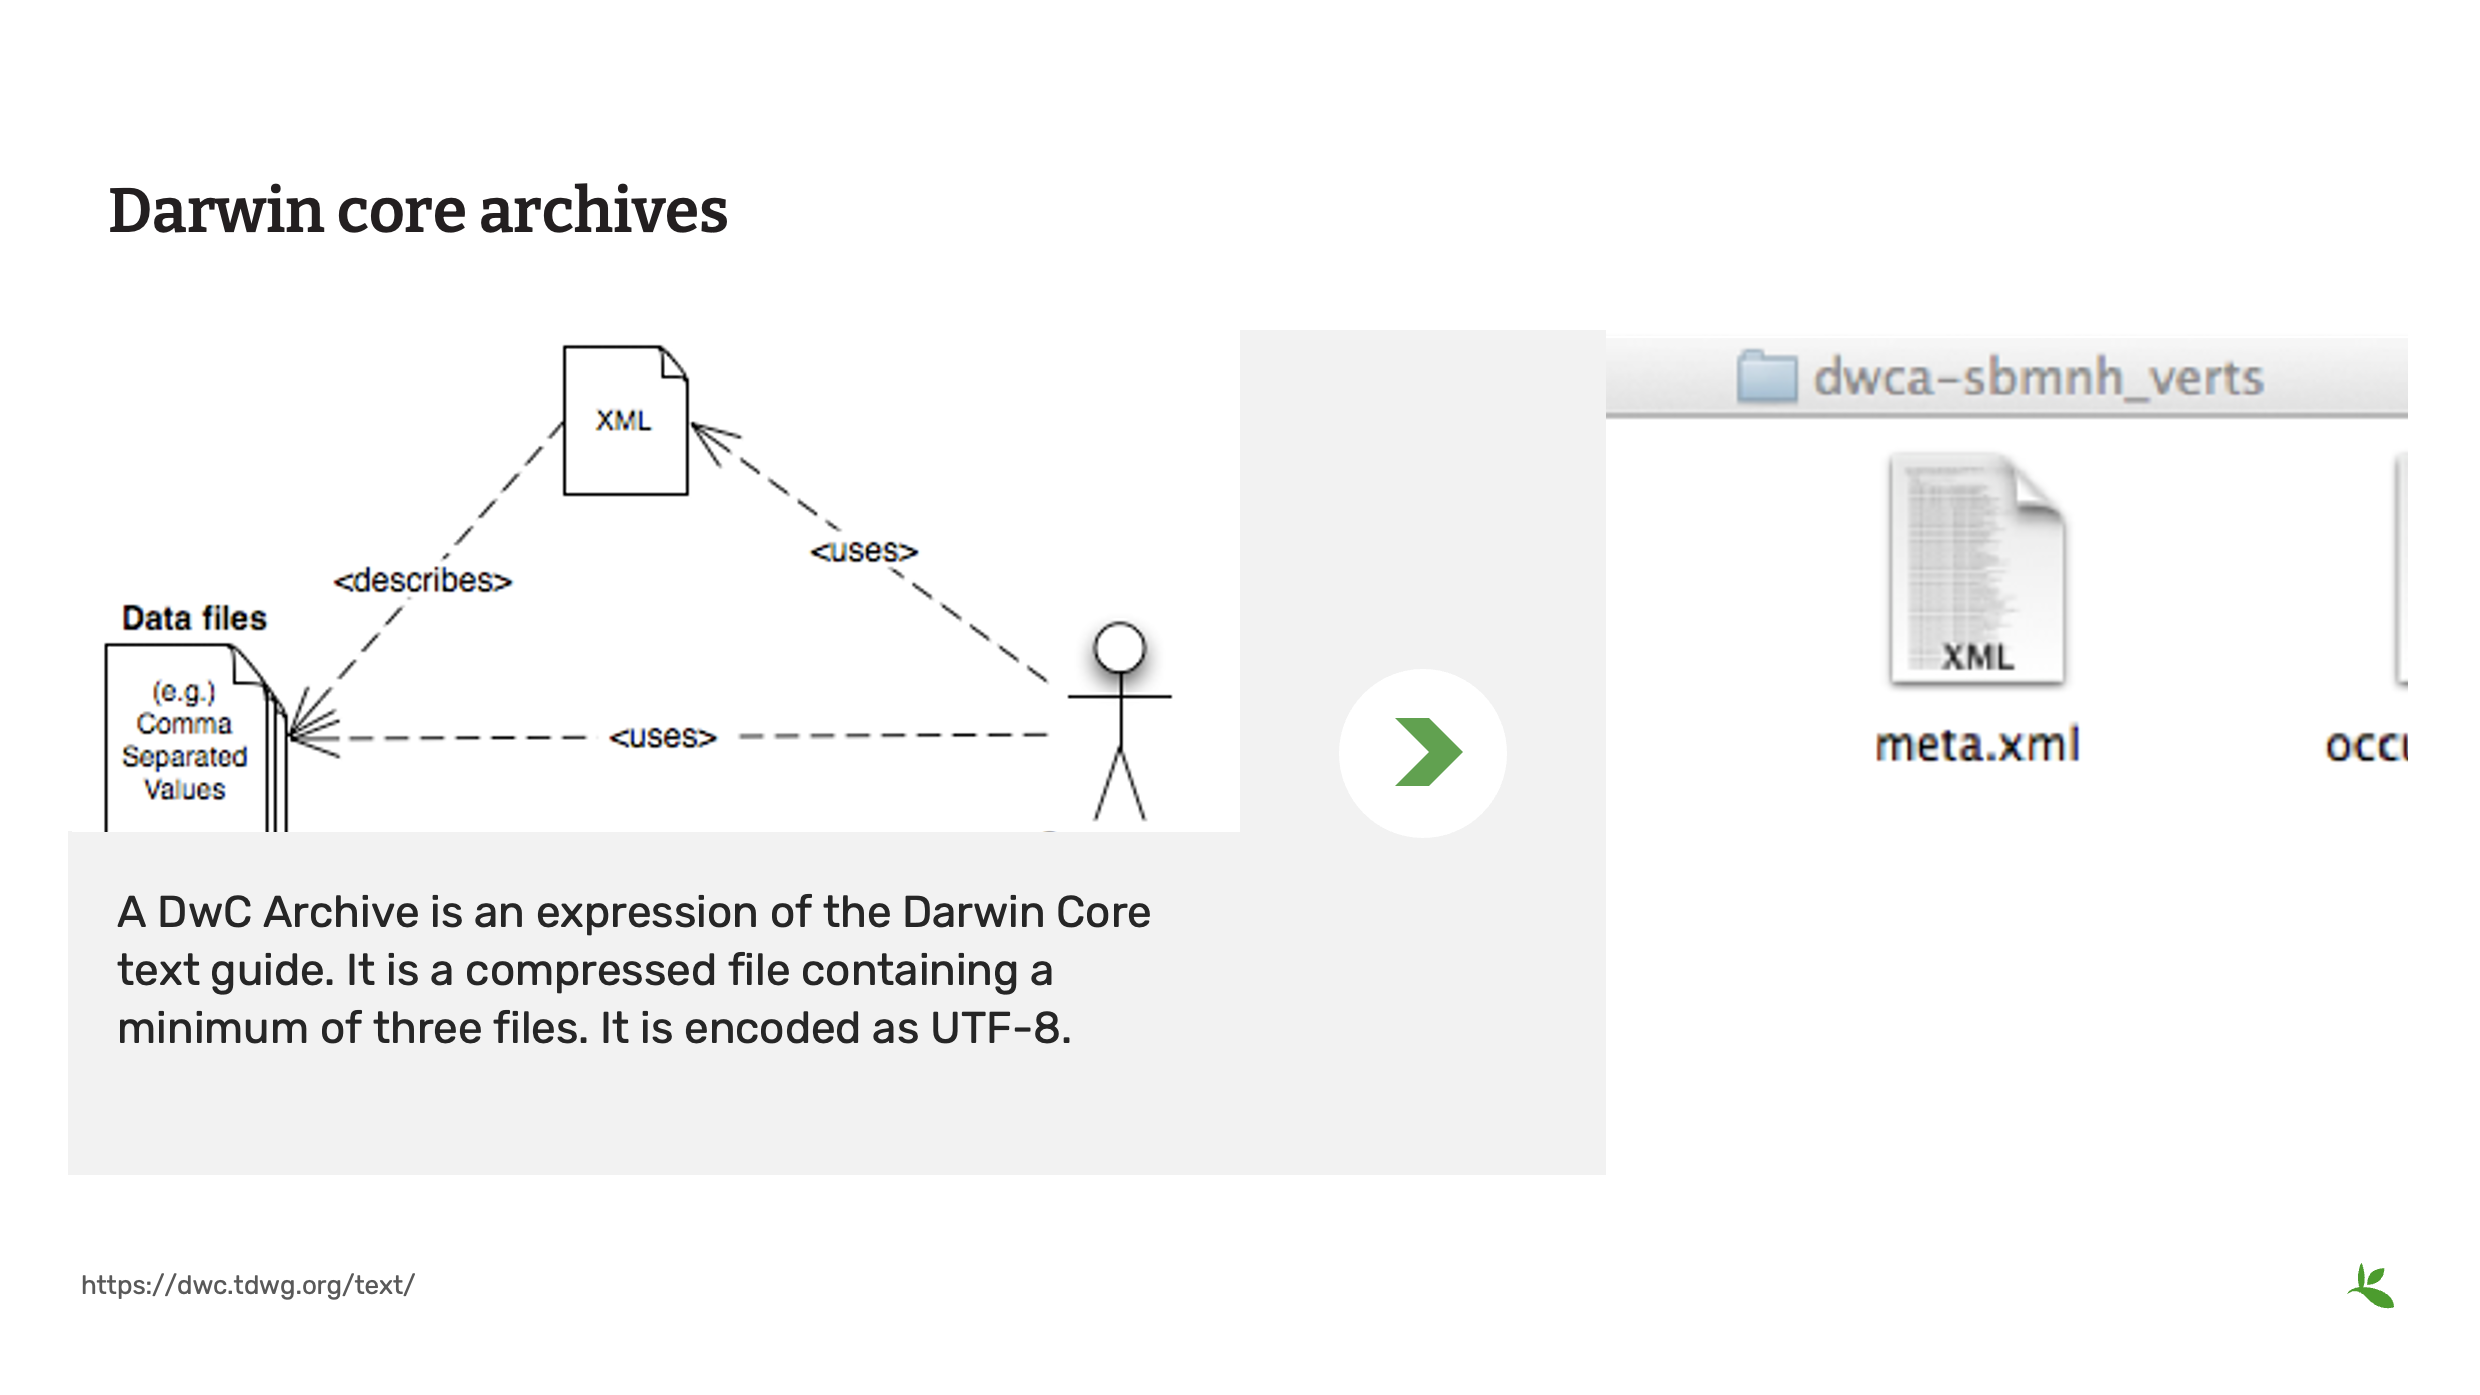
Слайд 17 — Архивы Darwin Core (DwC-A)
В настоящее время данные публикуются в GBIF в формате архива Darwin Core (Darwin Core Archive, DwCA).
DwCA представляет собой реализацию текстового руководства Darwin Core. Для кодирования символов используется UTF-8.
В данном примере архив включает следующие три файла:
Файл данных (occurrence.txt), соответствующий стандарту SIMPLEDWC и представленный в формате CSV. Первая строка файла содержит названия терминов стандарта Darwin Core. Файл метаданных (meta.xml) в формате XML, содержащий техническую информацию, необходимую для того, чтобы компьютер мог правильно обработать файл данных. Файл метаданных (eml.xml) в формате XML, содержащий описание набора данных и поясняющую информацию о записях, включённых в файл данных. Эта информация помогает пользователям определить, подходят ли данные для их задач.
Более сложная структура данных может быть создана за счёт использования нескольких связанных CSV-файлов, расширяющих содержание основного файла. Эти файлы связываются с основным файлом с помощью уникального идентификатора. В наборе данных о находках такая связь осуществляется по полю occurrenceID
Слайд 18 — Обновления DwC и переход на пакет данных Darwin Core (DwC-DP)
Таким образом, хотя с 2012 года предпочтительным способом публикации данных являются архивы Darwin Core для публикации, сейчас мы переходим к новой модели — пакету данных Darwin Core (Darwin Core Data Package).
Новая модель призвана «расширить круг научных вопросов, для решения которых могут использоваться данные GBI».
It will allow us to expand our data scope, engage with new data communities, and build tools to enable data flows based on the updated standard.
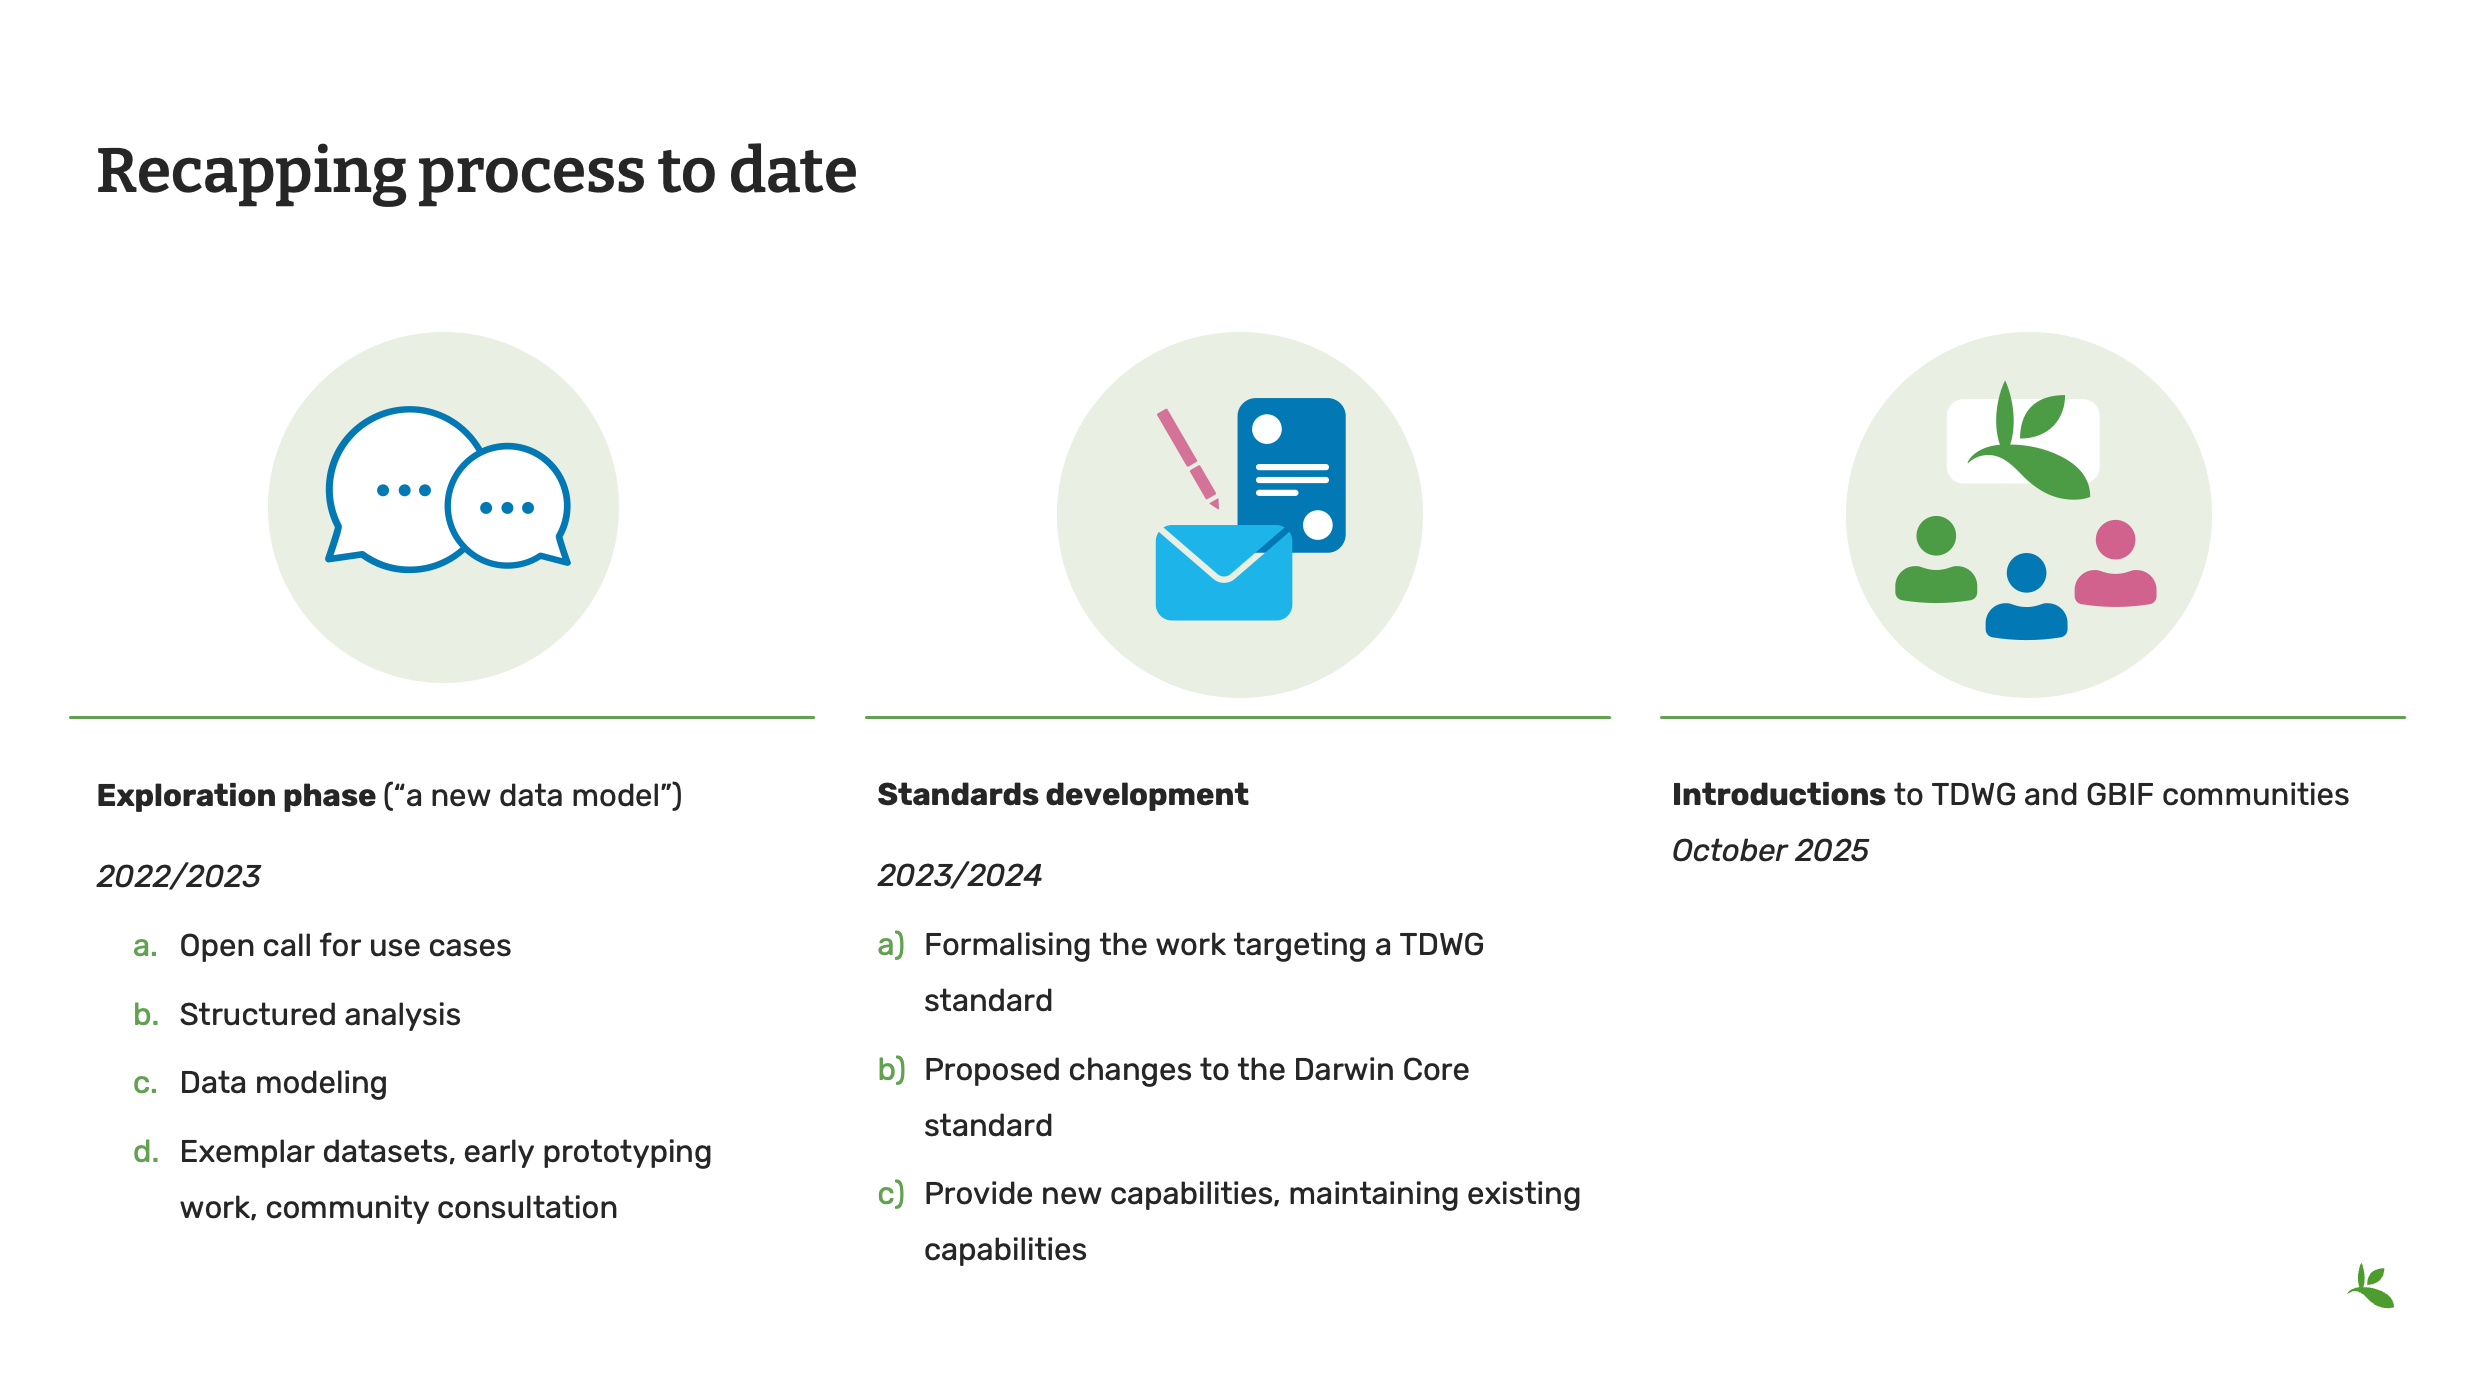
Слайд 19 — Краткий обзор проделанной работы
Сообщество работает над этой моделью с 2022 года, а разработка соответствующих стандартов началась в 2023 году.
We are finally in the community review and ratification phase for the new terms and the new data package which was released in October of 2025. As you can see from this timeline, it takes a long time implement change to an established standard and it takes a dedicated community to see it through.
Слайд 20 — Предлагаемые изменения в стандарте Darwin Core
Изменения, вынесенные на общественное обсуждение, включают:
65 новых терминов, 75 предложений по изменению существующих терминов, документированная концептуальная модель для DwC, руководство по использованию формата Frictionless Data
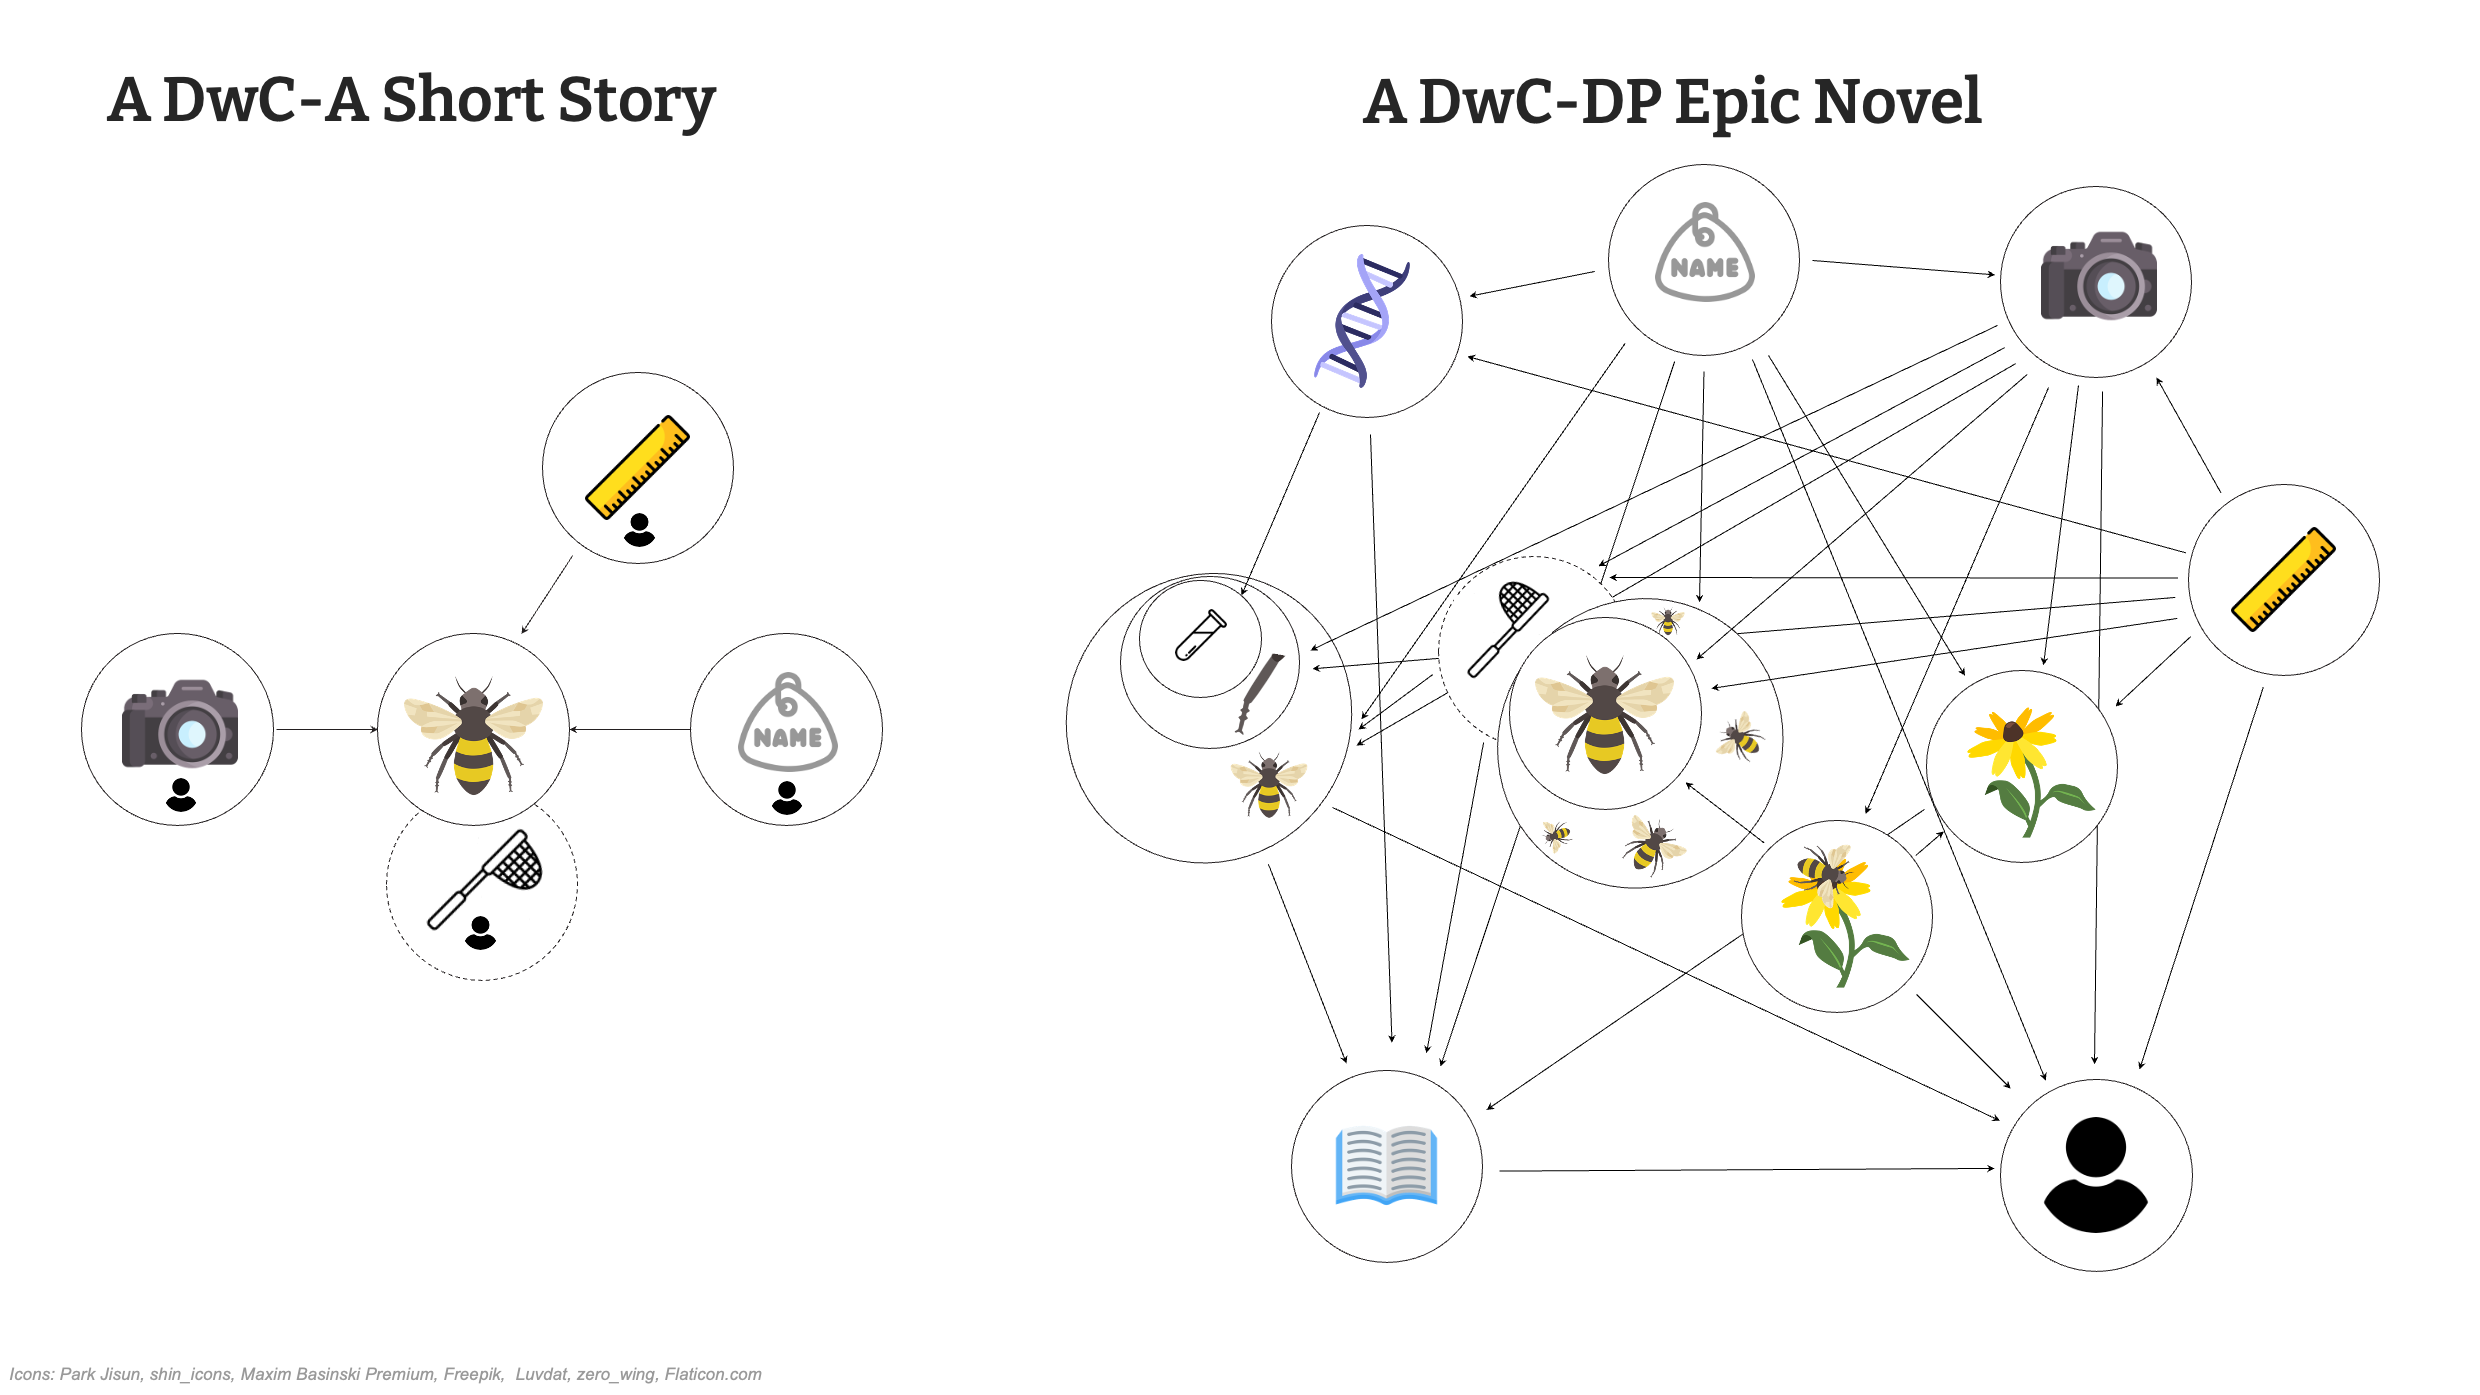
Слайд 21 — Короткий рассказ DwC-A или роман-эпопея DwC-DP?
Пакет данных Darwin Core полностью расширяет возможности обмена данными, превращая «короткий рассказ» Darwin Core Archive в «роман-эпопею» Darwin Core Data Package.
Для сравнения: истории можно рассказывать как с помощью DwC-A, так и с помощью DwC-DP, однако очевидно, что DwC-DP позволяет достоверно представить гораздо более широкий спектр научных исследований.
Пчела, цветок: Park Jisun DNA: Luvdat Book: zero_wing Net: shin_icons Person: Maxim Basinski Premium Test tube: Freepik Ruler: Freepik Camera: Freepik Identification: Freepik
Слайд 22 — А мне обязательно всё это делать?
Все это может показаться сложным, когда вы только начинаете знакомиться с мобилизацией данных, но мы хотим, чтобы вы знали о предстоящих изменениях, которые, в зависимости от ваших данных, могут оказаться для вас очень интересными.
Мы также понимаем, что далеко не всем потребуется использовать все эти возможности, особенно в рамках одного набора данных. Издатели данных смогут использовать только то, что им необходимо.
В рамках этого курса пока мы сосредоточимся на работе с ядром Event, о котором вы подробнее узнаете в следующих разделах.
Когда процесс утверждения будет завершён и всё будет готово к тому, чтобы издатели данных начали использовать Darwin Core Data Package, мы организуем онлайн-мероприятия для сообщества в дополнение к обучению.
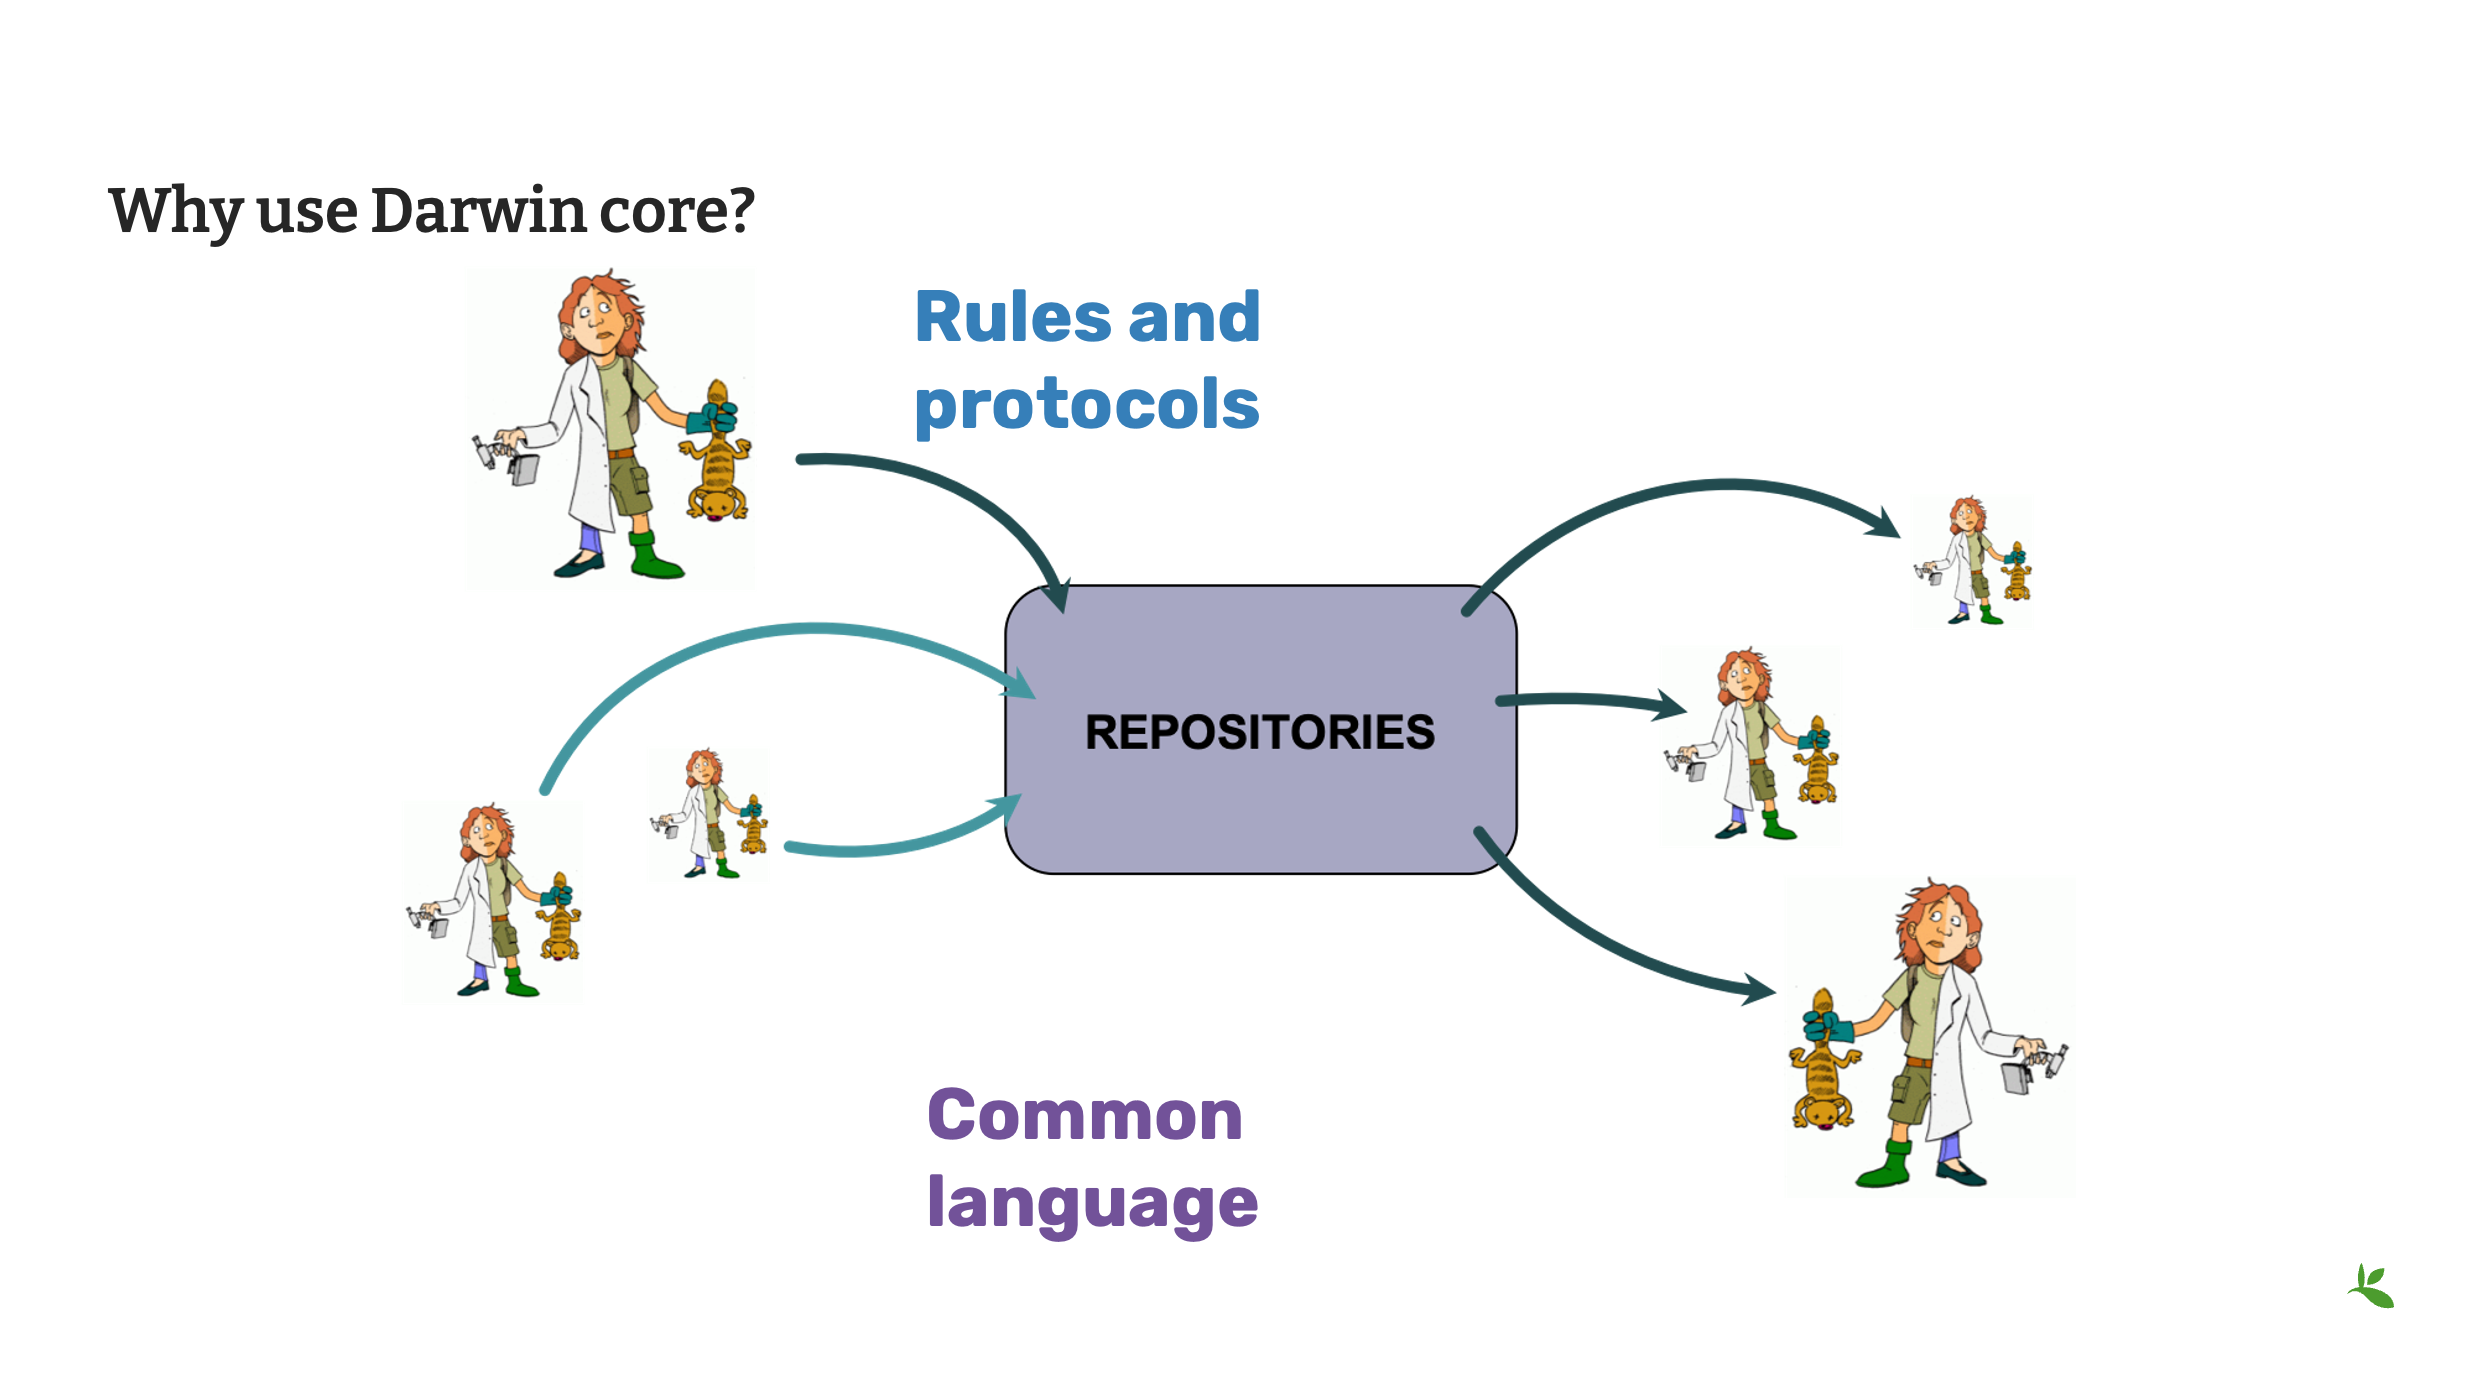
Слайд 23 — Зачем использовать Darwin Core?
Итак, подводя итог, мы рассмотрели, что такое Darwin Core, и, надеемся, вы уже начали понимать, зачем его использовать.
Это стандарт, а стандарты — это хорошо! Стандарты предоставляют правила и протоколы, необходимые для того, чтобы мы могли делиться своими данными с другими.
Darwin Core также предоставляет нам общий язык. Как мы видели в презентации «Основы — Документация», сравнивать наборы исходных данных бывает непросто. Поля в ваших исходных данных могут отличаться от полей в источниках данных других учреждений. Когда мы все используем Darwin Core для обмена данными, мы понимаем, что эти данные представлены на общем языке.
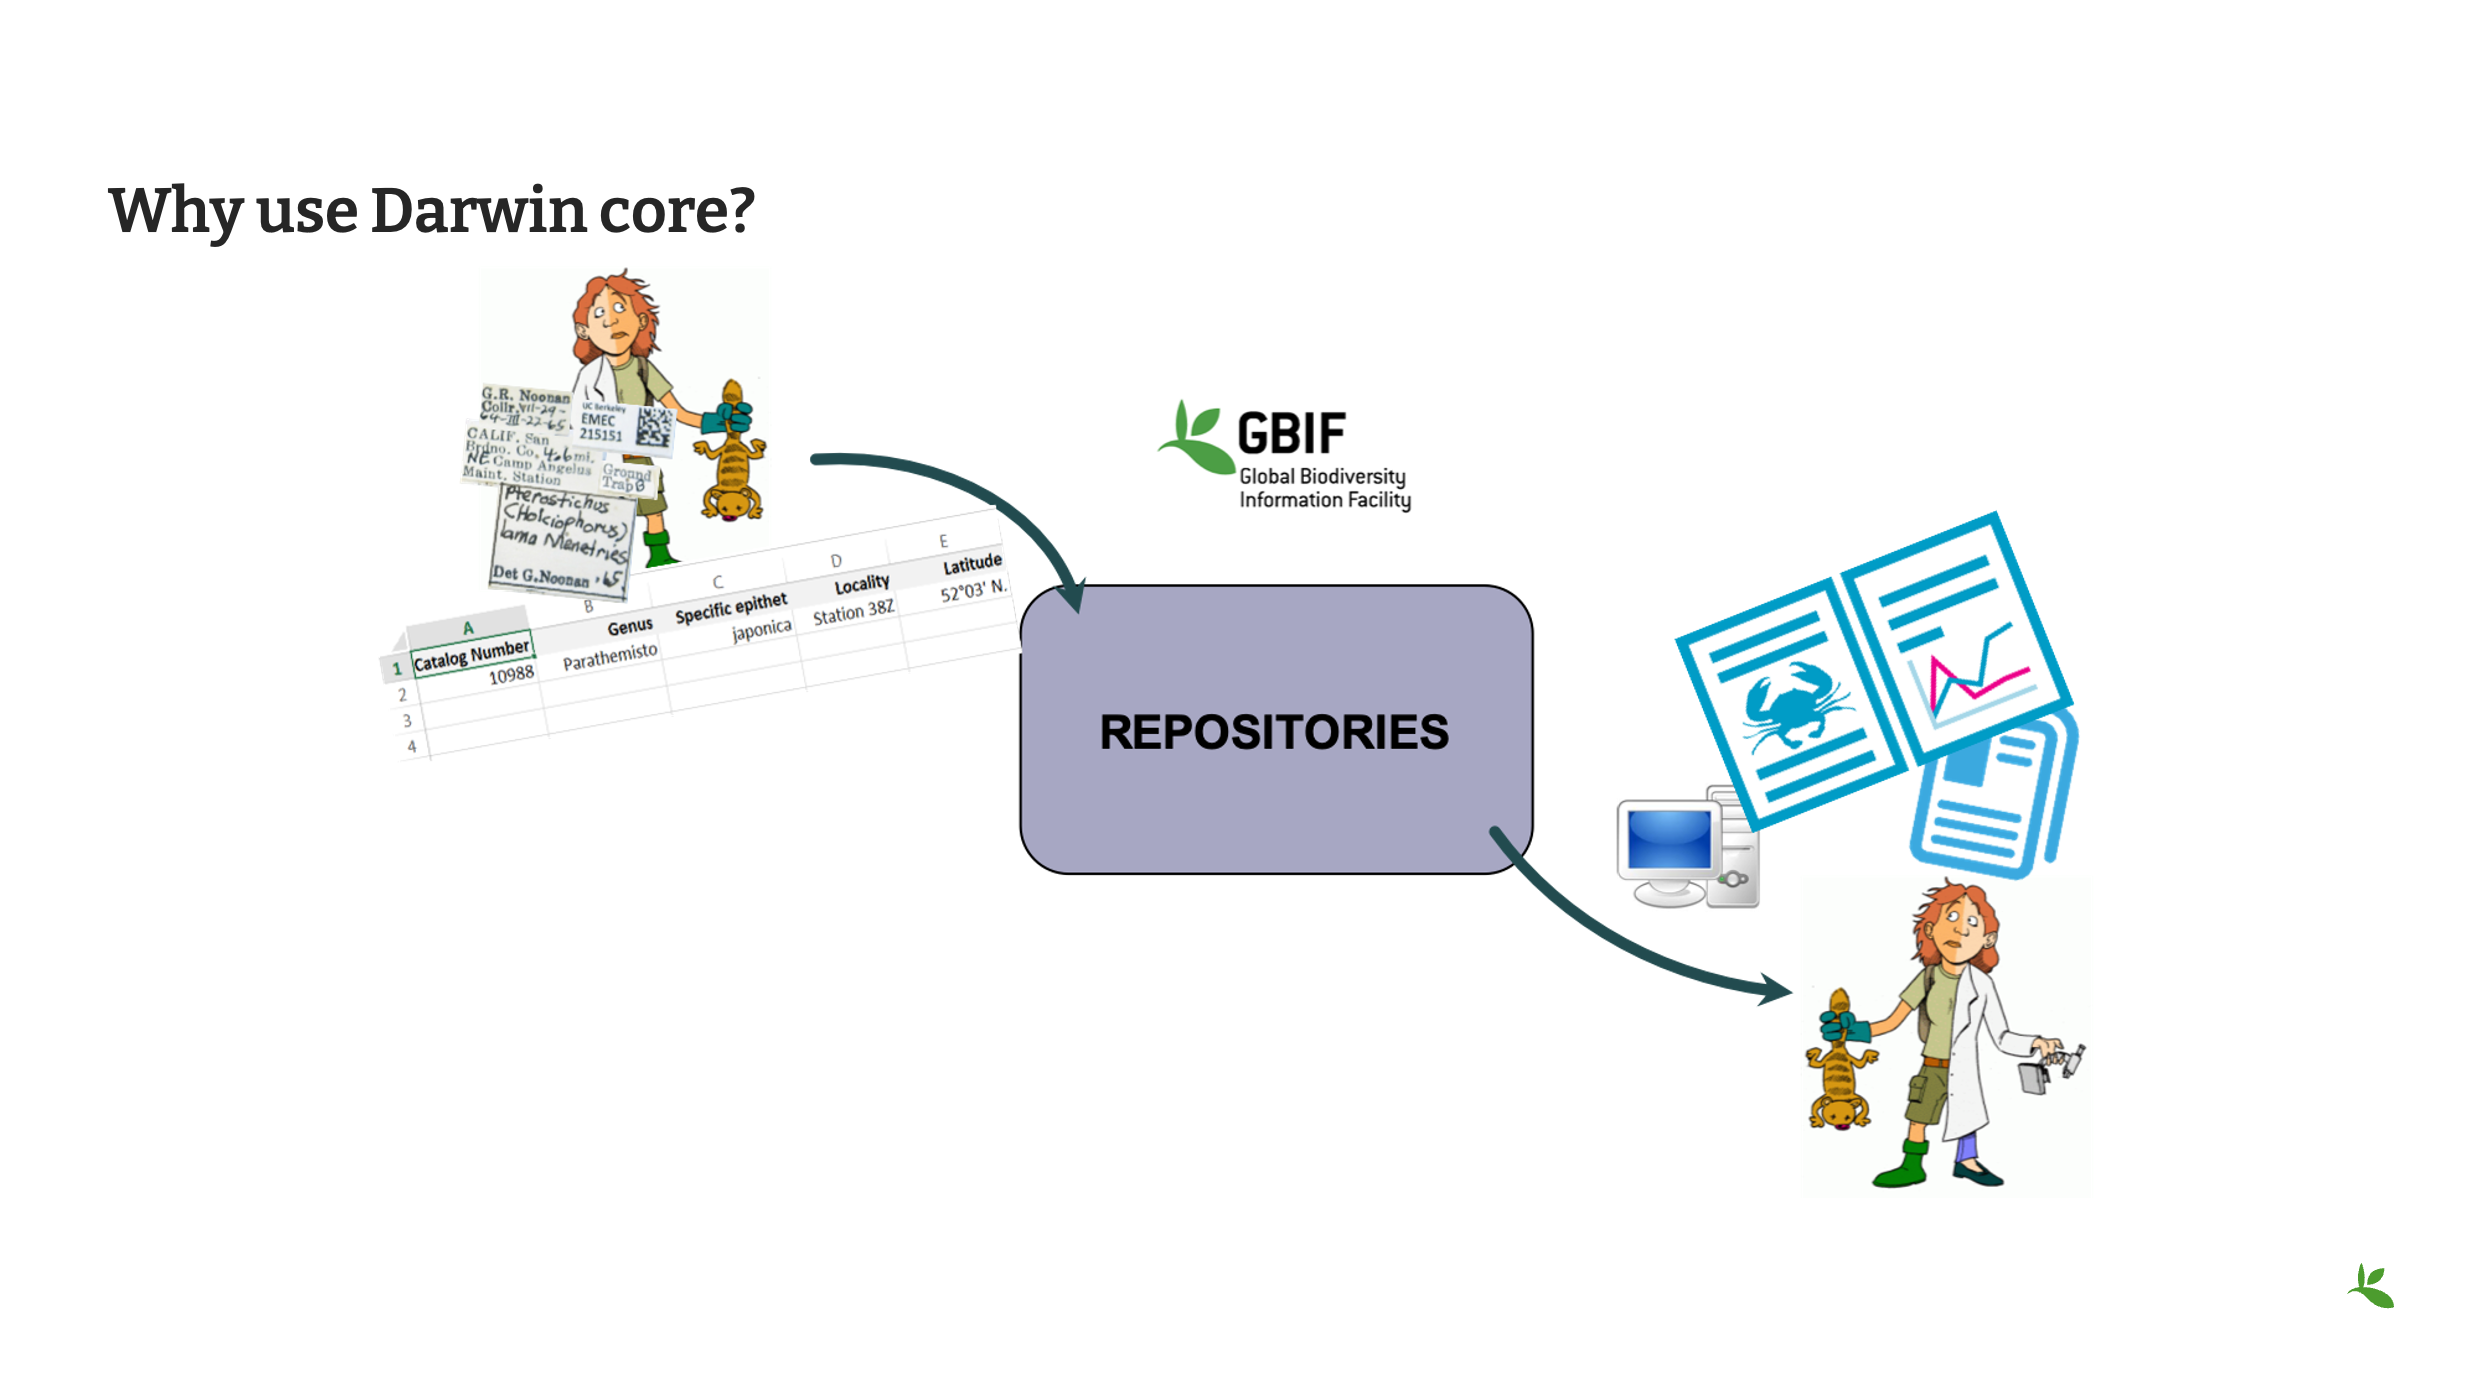
Слайд 24 — Зачем использовать Darwin Core?
И этот общий язык понятен не только владельцам данных, но и их пользователям. В конце концов, что может быть лучше, чем когда пользователь находит подходящий для своих целей набор данных, представленный на общепринятом языке, который помогает ему проводить более качественные научные исследования.
Слайд 25 — Заключение
Эта презентация является частью серии презентаций, используемых в курсе GBIF по мобилизации данных о биоразнообразии. Учебная программа по мобилизации данных о биоразнообразии была первоначально разработана в рамках Программы развития информационных ресурсов по биоразнообразию (Biodiversity Information for Development Programme), финансируемой Европейским союзом. Данная презентация была первоначально создана Paula Zermoglio и John Wieczorek при дополнительном участии Sharon Grant, Sophie Pamerlon, Laura Anne Russell, Cecilie Svenningsen и Dag Endresen. Дикторский текст озвучил я, Vijay Barve.
Упражнение 1а
|
В этом задании вы рассмотрите исходные названия полей и сопоставите их с соответствующими терминами Darwin Core |
-
Найдите термин Darwin Core на сайте https://dwc.tdwg.org/terms/, который наиболее точно соответствует названиям полей.
-
Скачайте файл UC-Practice-exercise-sheet_EN.docx, чтобы вписать свои ответы.
Типы наборов данных GBIF для первичных данных о биоразнообразии
|
В этом видео (08:16) вы ознакомитесь с https://www.gbif.org/dataset-classes [первичными данными о биоразнообразии^], которыми можно обмениваться в рамках GBIF. Субтитры к этому видео пока недоступны. Если вы не можете просмотреть встроенное видео, вы можете скачать его на свой компьютер по ссылке:$gbif_dataset_types_for_primary_biodiversity_data_v3-720p.mp4[download,opts=download]. (MP4 — 28,8 МБ) Если вы предпочитаете ознакомиться с материалом в текстовом виде, транскрипт видеоролика приведён ниже |
Presentation transcript
Нажмите, чтобы раскрыть
Слайд 1 — Типы наборов данных GBIF для первичных данных о биоразнообразии
В этой презентации мы рассмотрим различные типы данных, которые можно отнести к «первичным данным о биоразнообразии» и которыми можно делиться через GBIF. Эти данные могут быть сложными и иметь различное происхождение. Мы рассмотрим, как их можно структурировать в соответствии с одним из типов наборов данных, поддерживаемых GBIF.
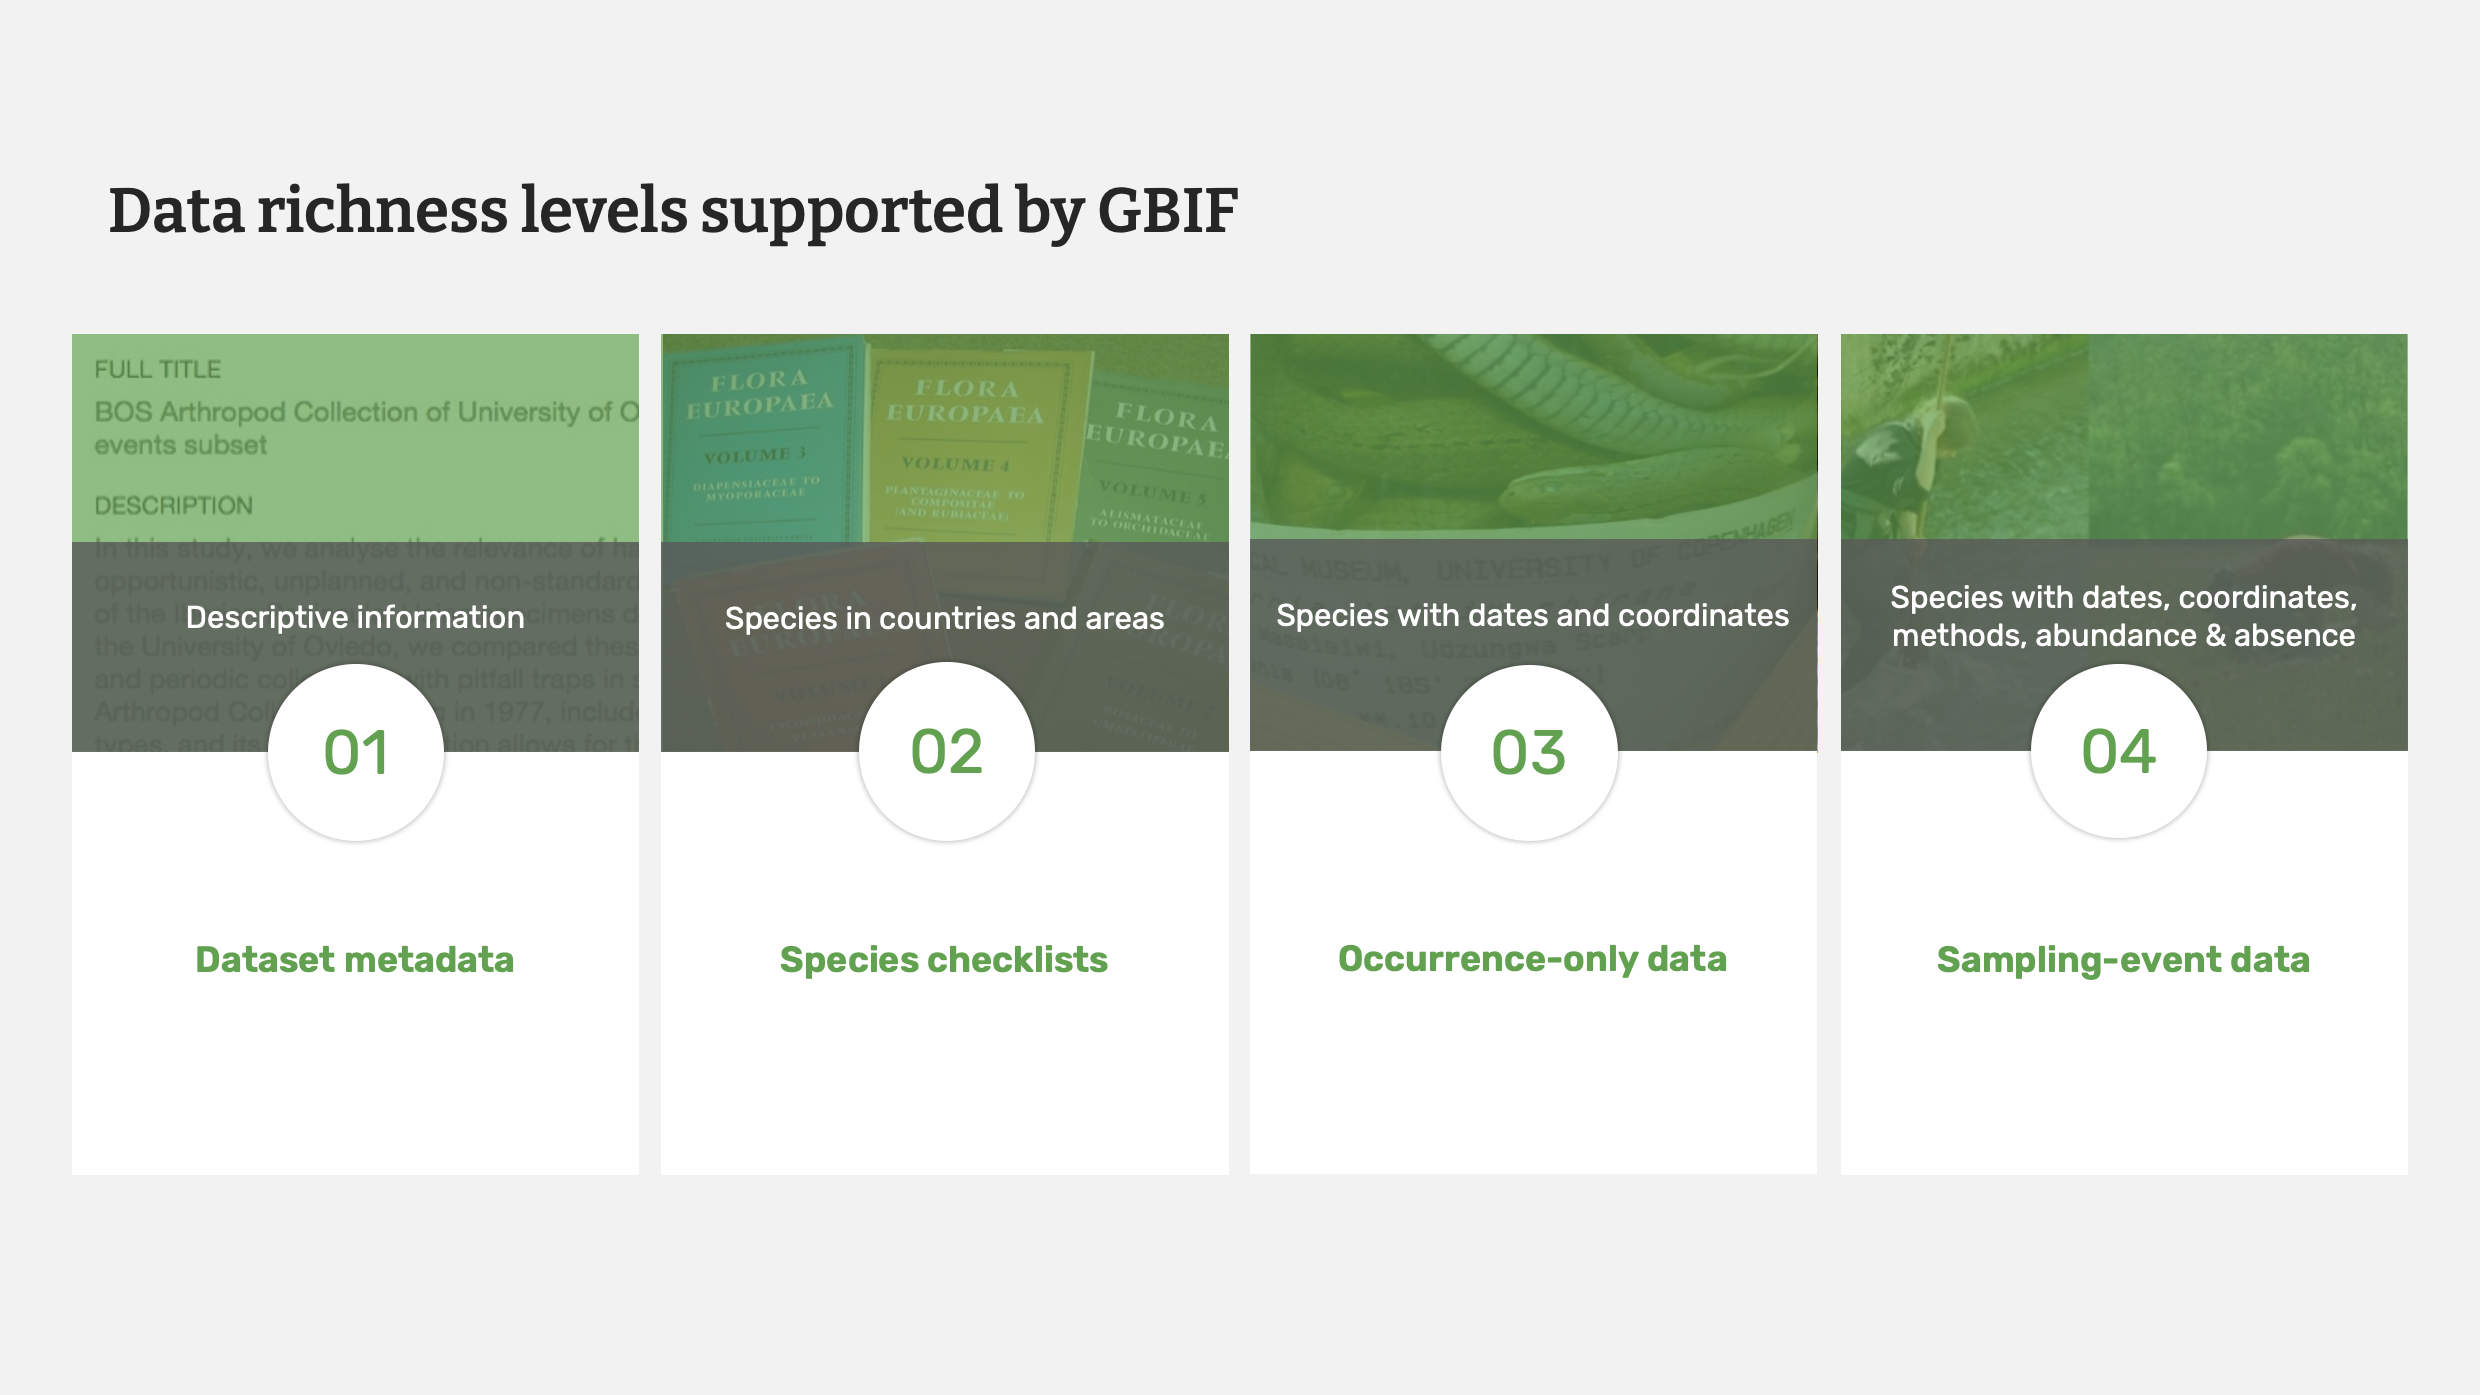
Слайд 2 — Уровни информационной насыщенности данных, поддерживаемые GBIF
В настоящее время GBIF поддерживает четыре типа наборов данных:
Первый уровень — метаданные набора данных.
Это тип набора данных, который позволяет предоставить описательную информацию о наборе данных. Его можно использовать, если ваши данные ещё не оцифрованы. При публикации такого набора сами файлы с данными не публикуются — публикуются только описательные метаданные.
Ко второму типу относятся списки видов.
Этот тип позволяет публиковать информацию о видах, включая страны и территории, где они встречаются.
Третий тип — данные только о находках организмов.
Этот тип набора данных предназначен для данных, включающих названия таксонов, даты и координаты — то есть информацию о том, что, когда и где было зарегистрировано.
Последний тип — данные о событиях отбора проб.
Этот тип позволяет публиковать ещё больше информации. Вы можете предоставлять данные о видах, включая даты, координаты, методы сбора, численность и даже данные об отсутствии видов.
Теперь мы подробнее рассмотрим таксономические списки, наборы данных о находках организмов и наборы данных о событиях отбора проб.
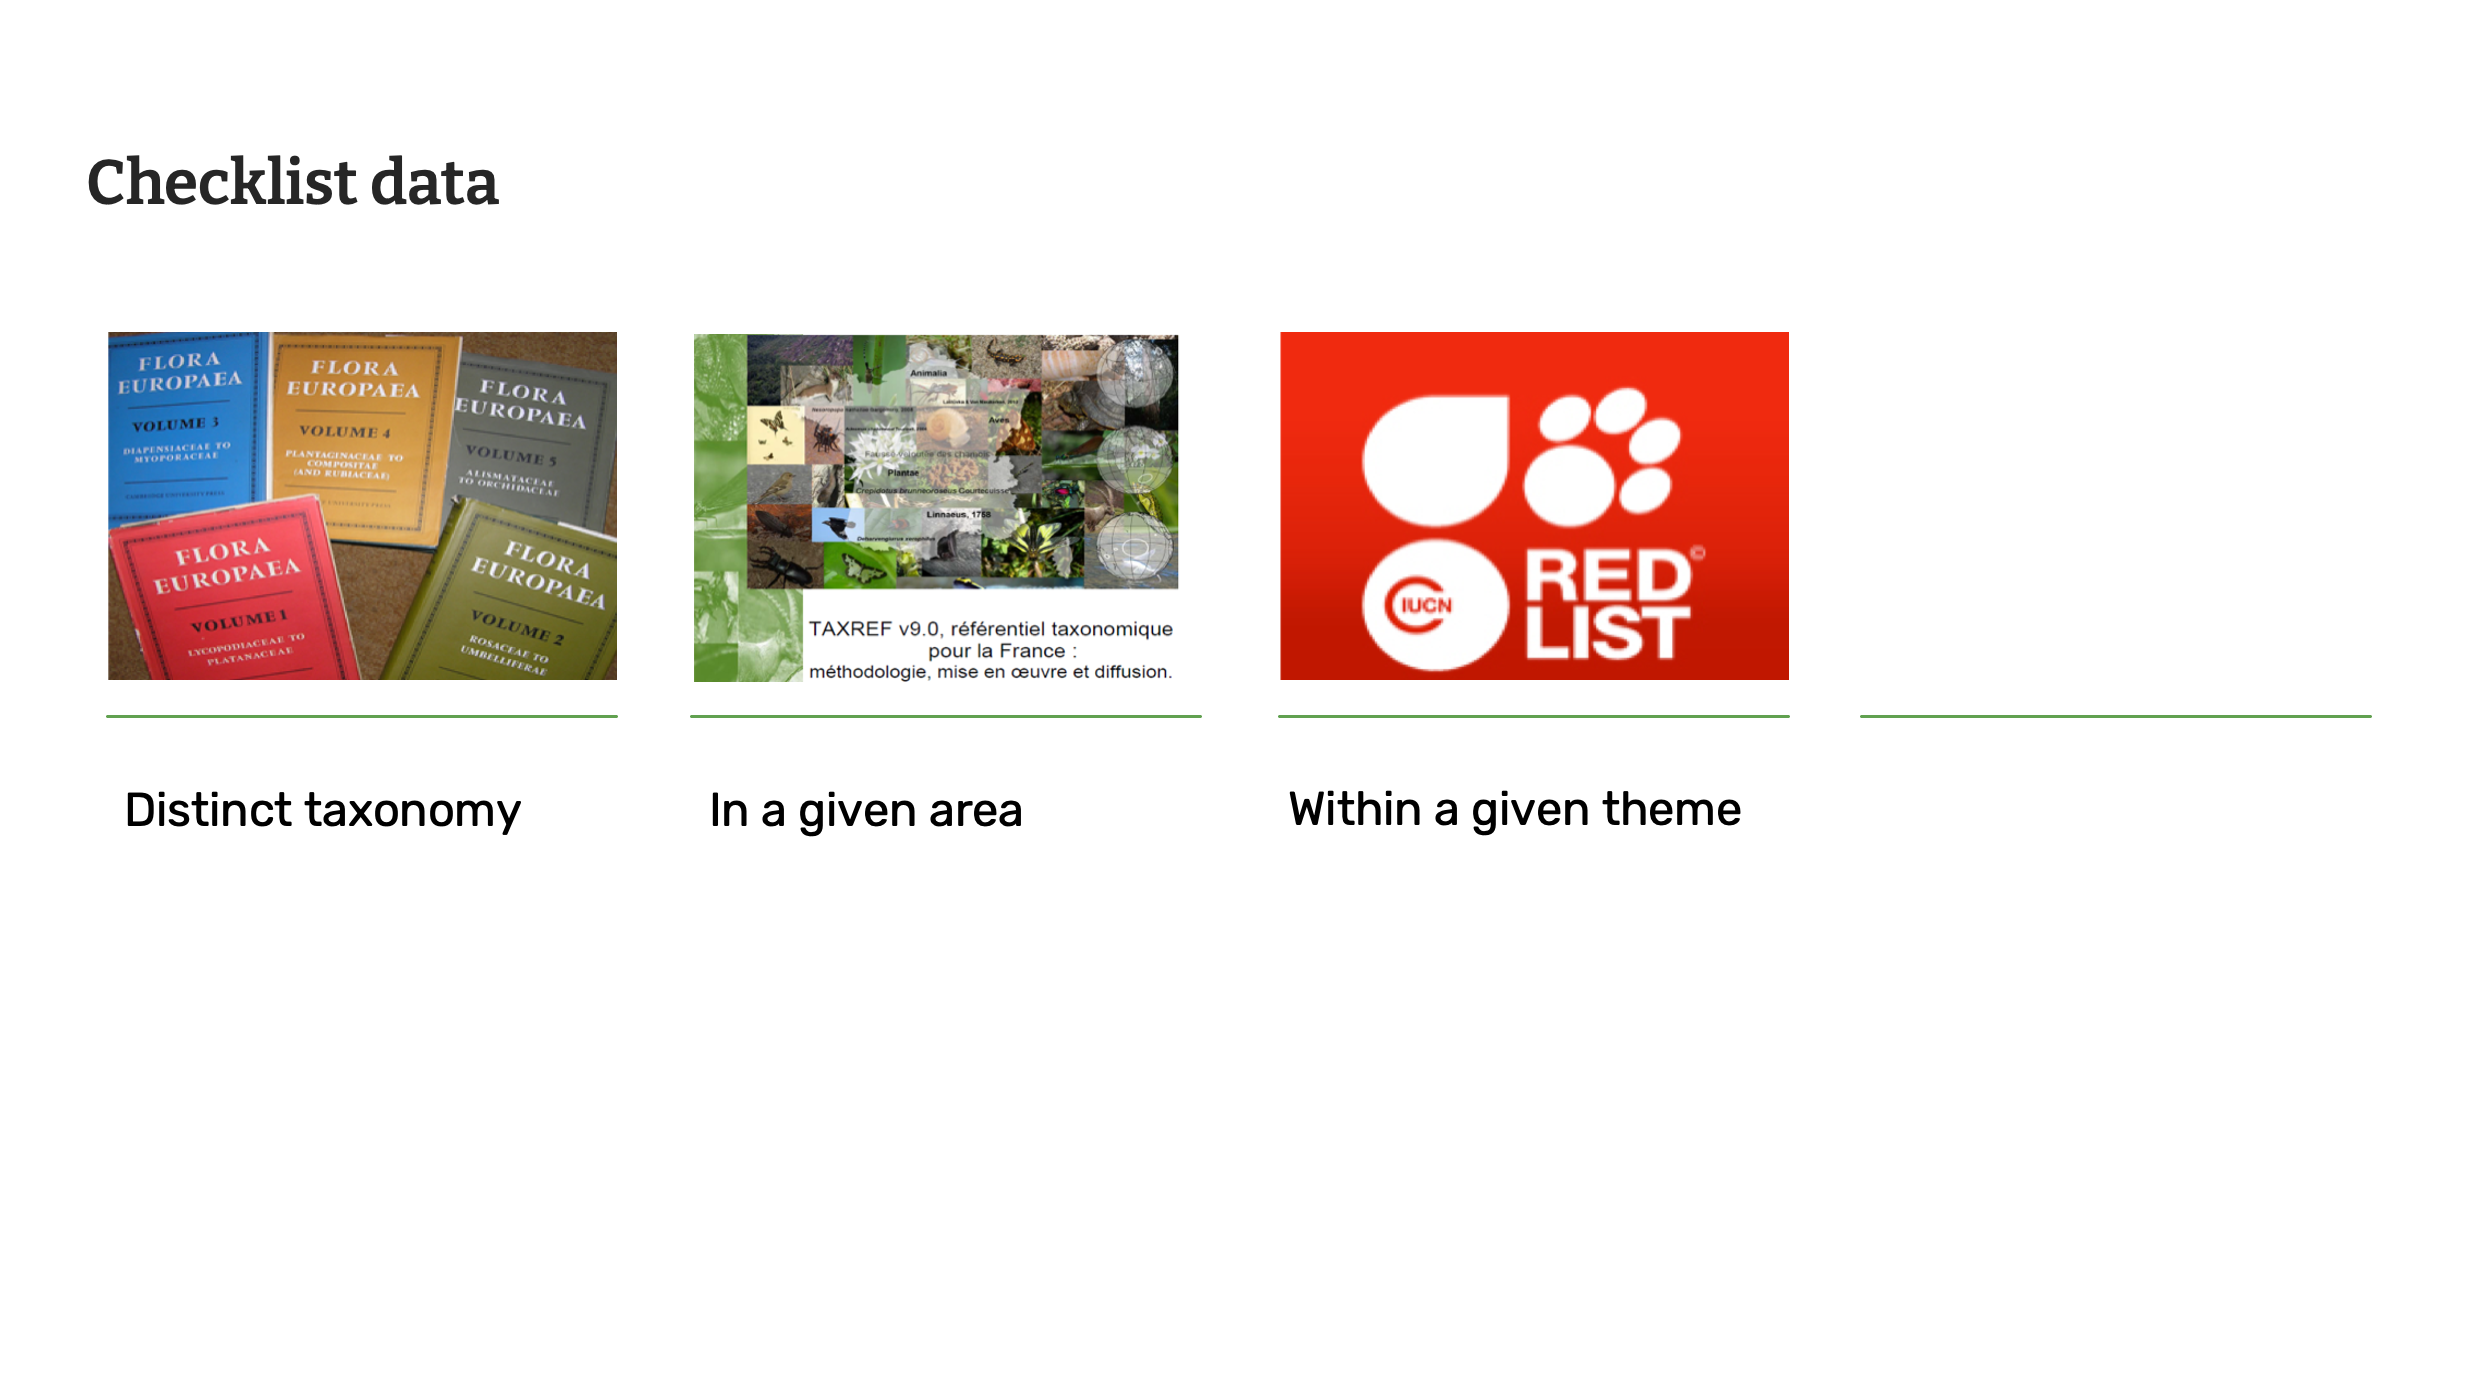
Слайд 3 — Данные таксономических списков
Наборы данных таксономических списков представляют собой каталог или перечень названий организмов или таксонов. Они могут включать дополнительную информацию, например местные названия видов или ссылки на экземпляры, однако такие списки обычно систематизируют информацию по таксономическому, географическому и тематическому признакам или по их сочетанию. Например, набор данных, содержащий перечень моллюсков Сейшельских островов, включённых в Красный список, сочетает в себе отдельные элементы таксономии (тип Mollusca), географии (островное государство Сейшельские Острова) и тематики (виды, которые эксперты IUCN считают находящимися под угрозой). Таксономические списки служат для быстрого обобщения информации или составления базового перечня таксонов в определённом контексте.
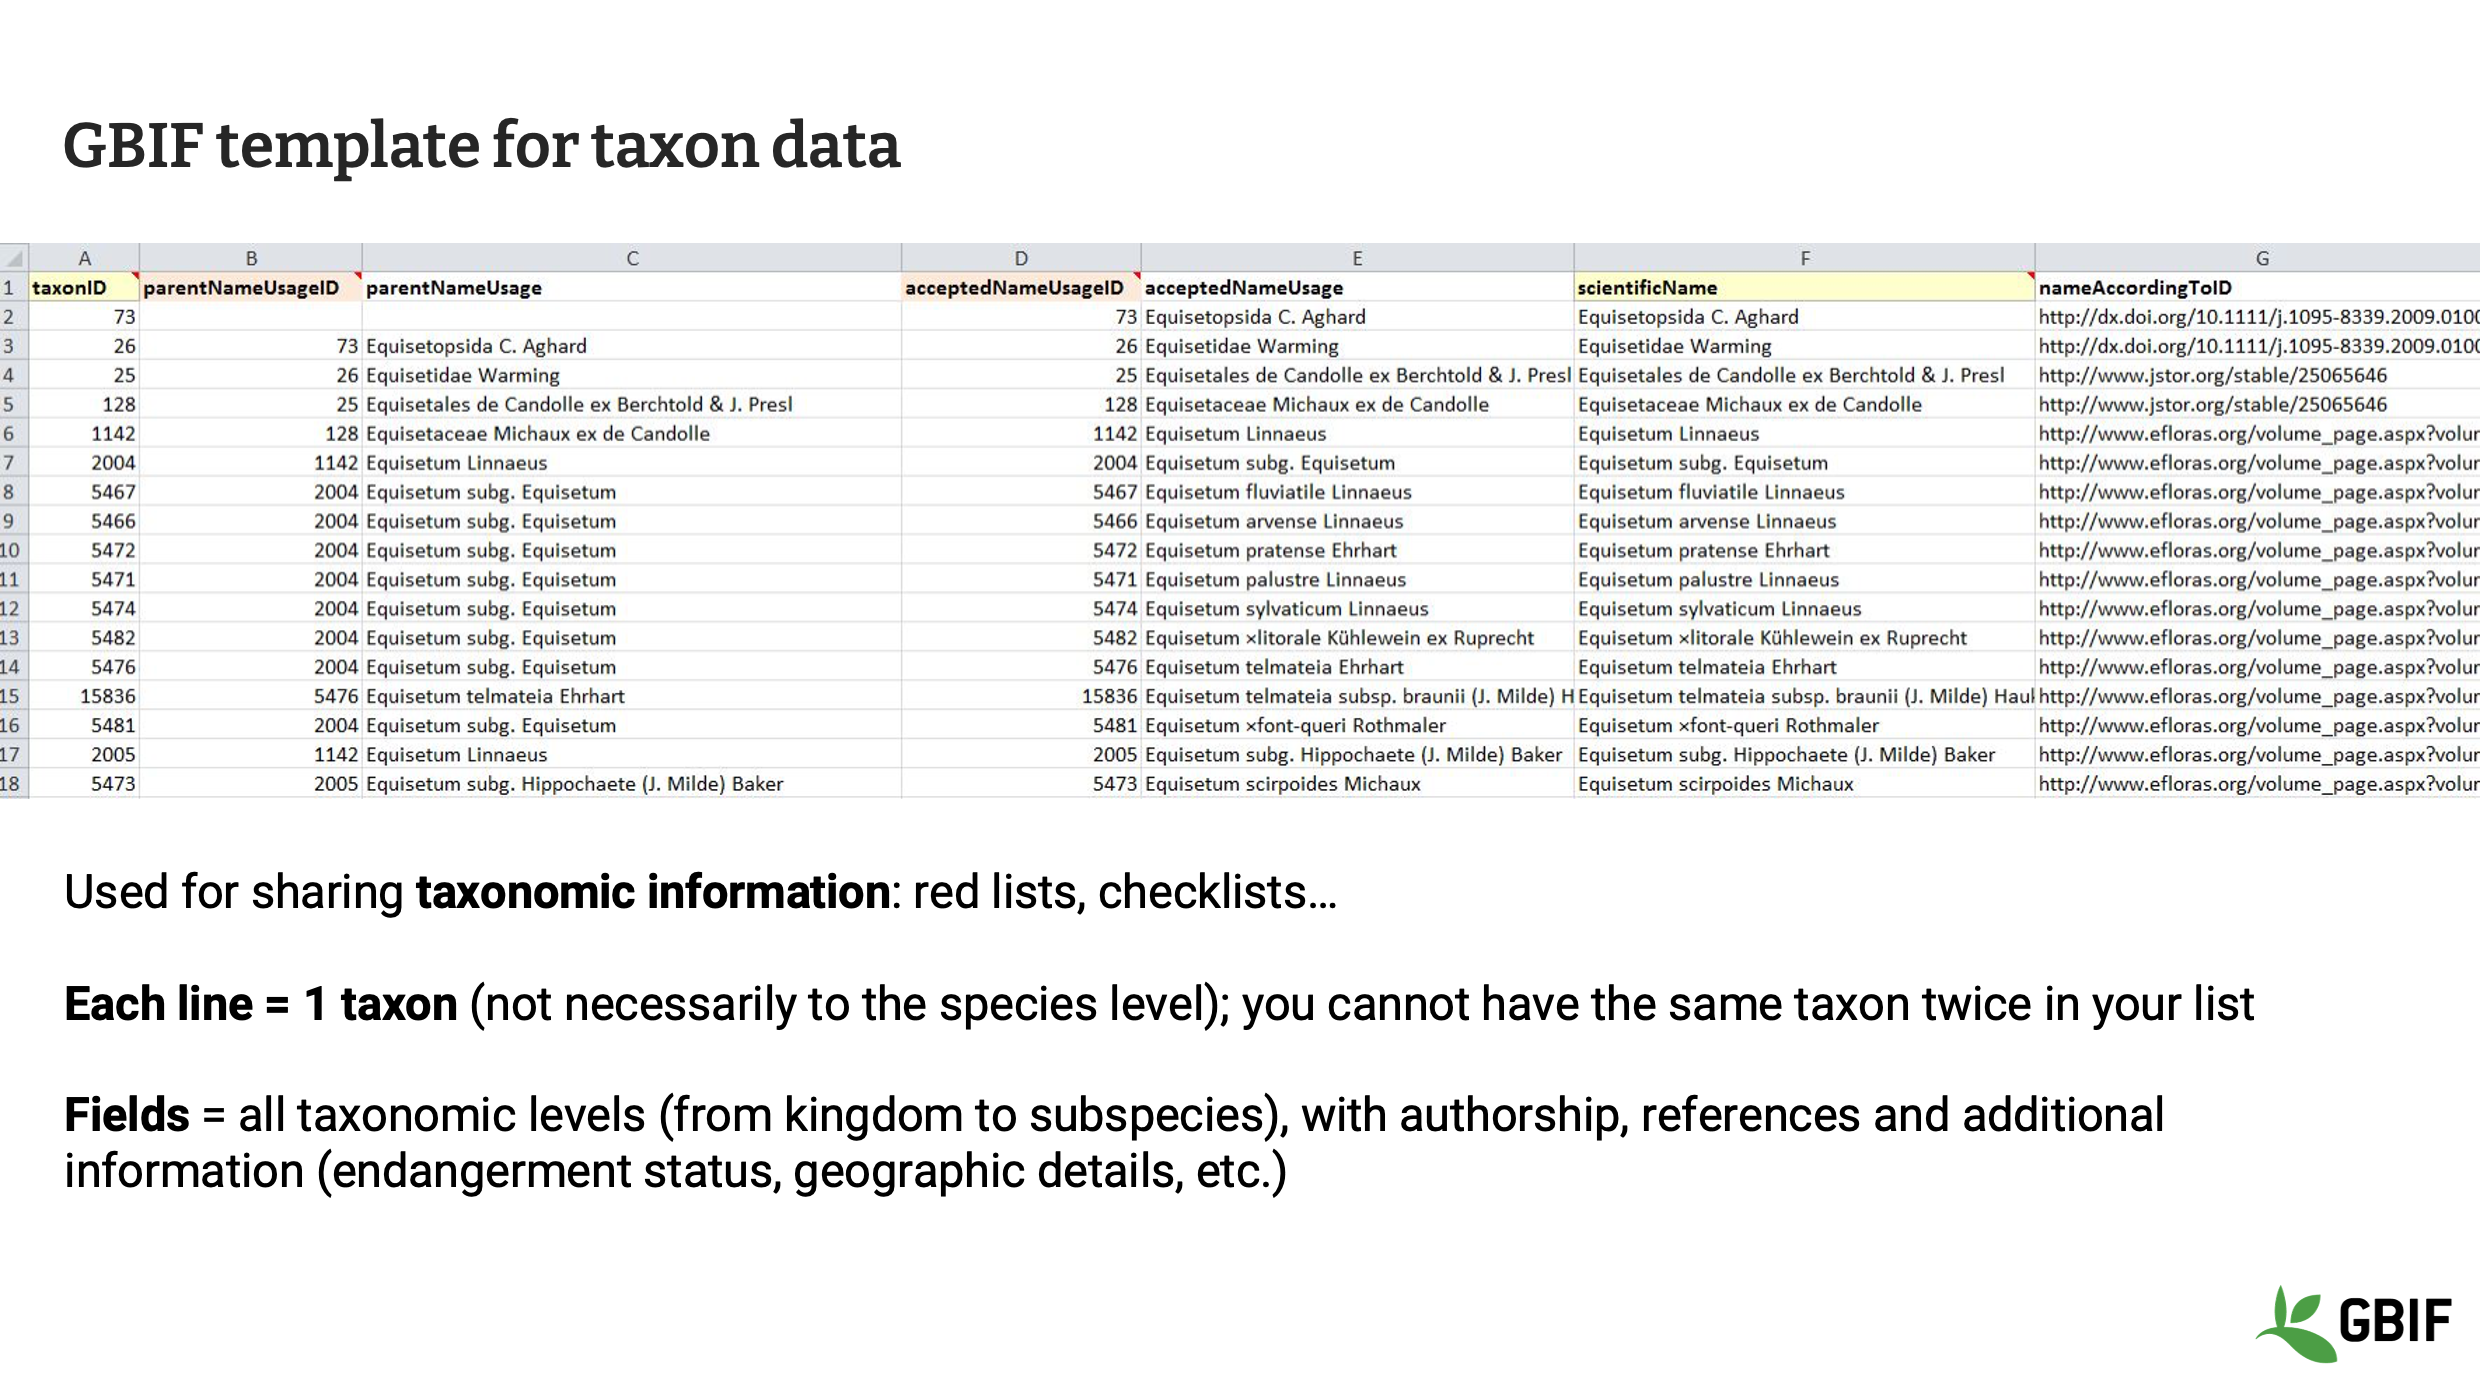
Слайд 4 — Шаблон GBIF для данных о таксонах
GBIF предоставляет издателям данных шаблоны для каждого типа наборов данных. Шаблон GBIF для таксономических данных позволяет публиковать информацию, связанную с каждым видом или таксоном, включая идентификатор таксона, полное название и авторство, связи с другими таксонами, географическую информацию и т. д. В этом шаблоне каждая строка соответствует одному таксону, и каждый таксон может встречаться в наборе данных только один раз.
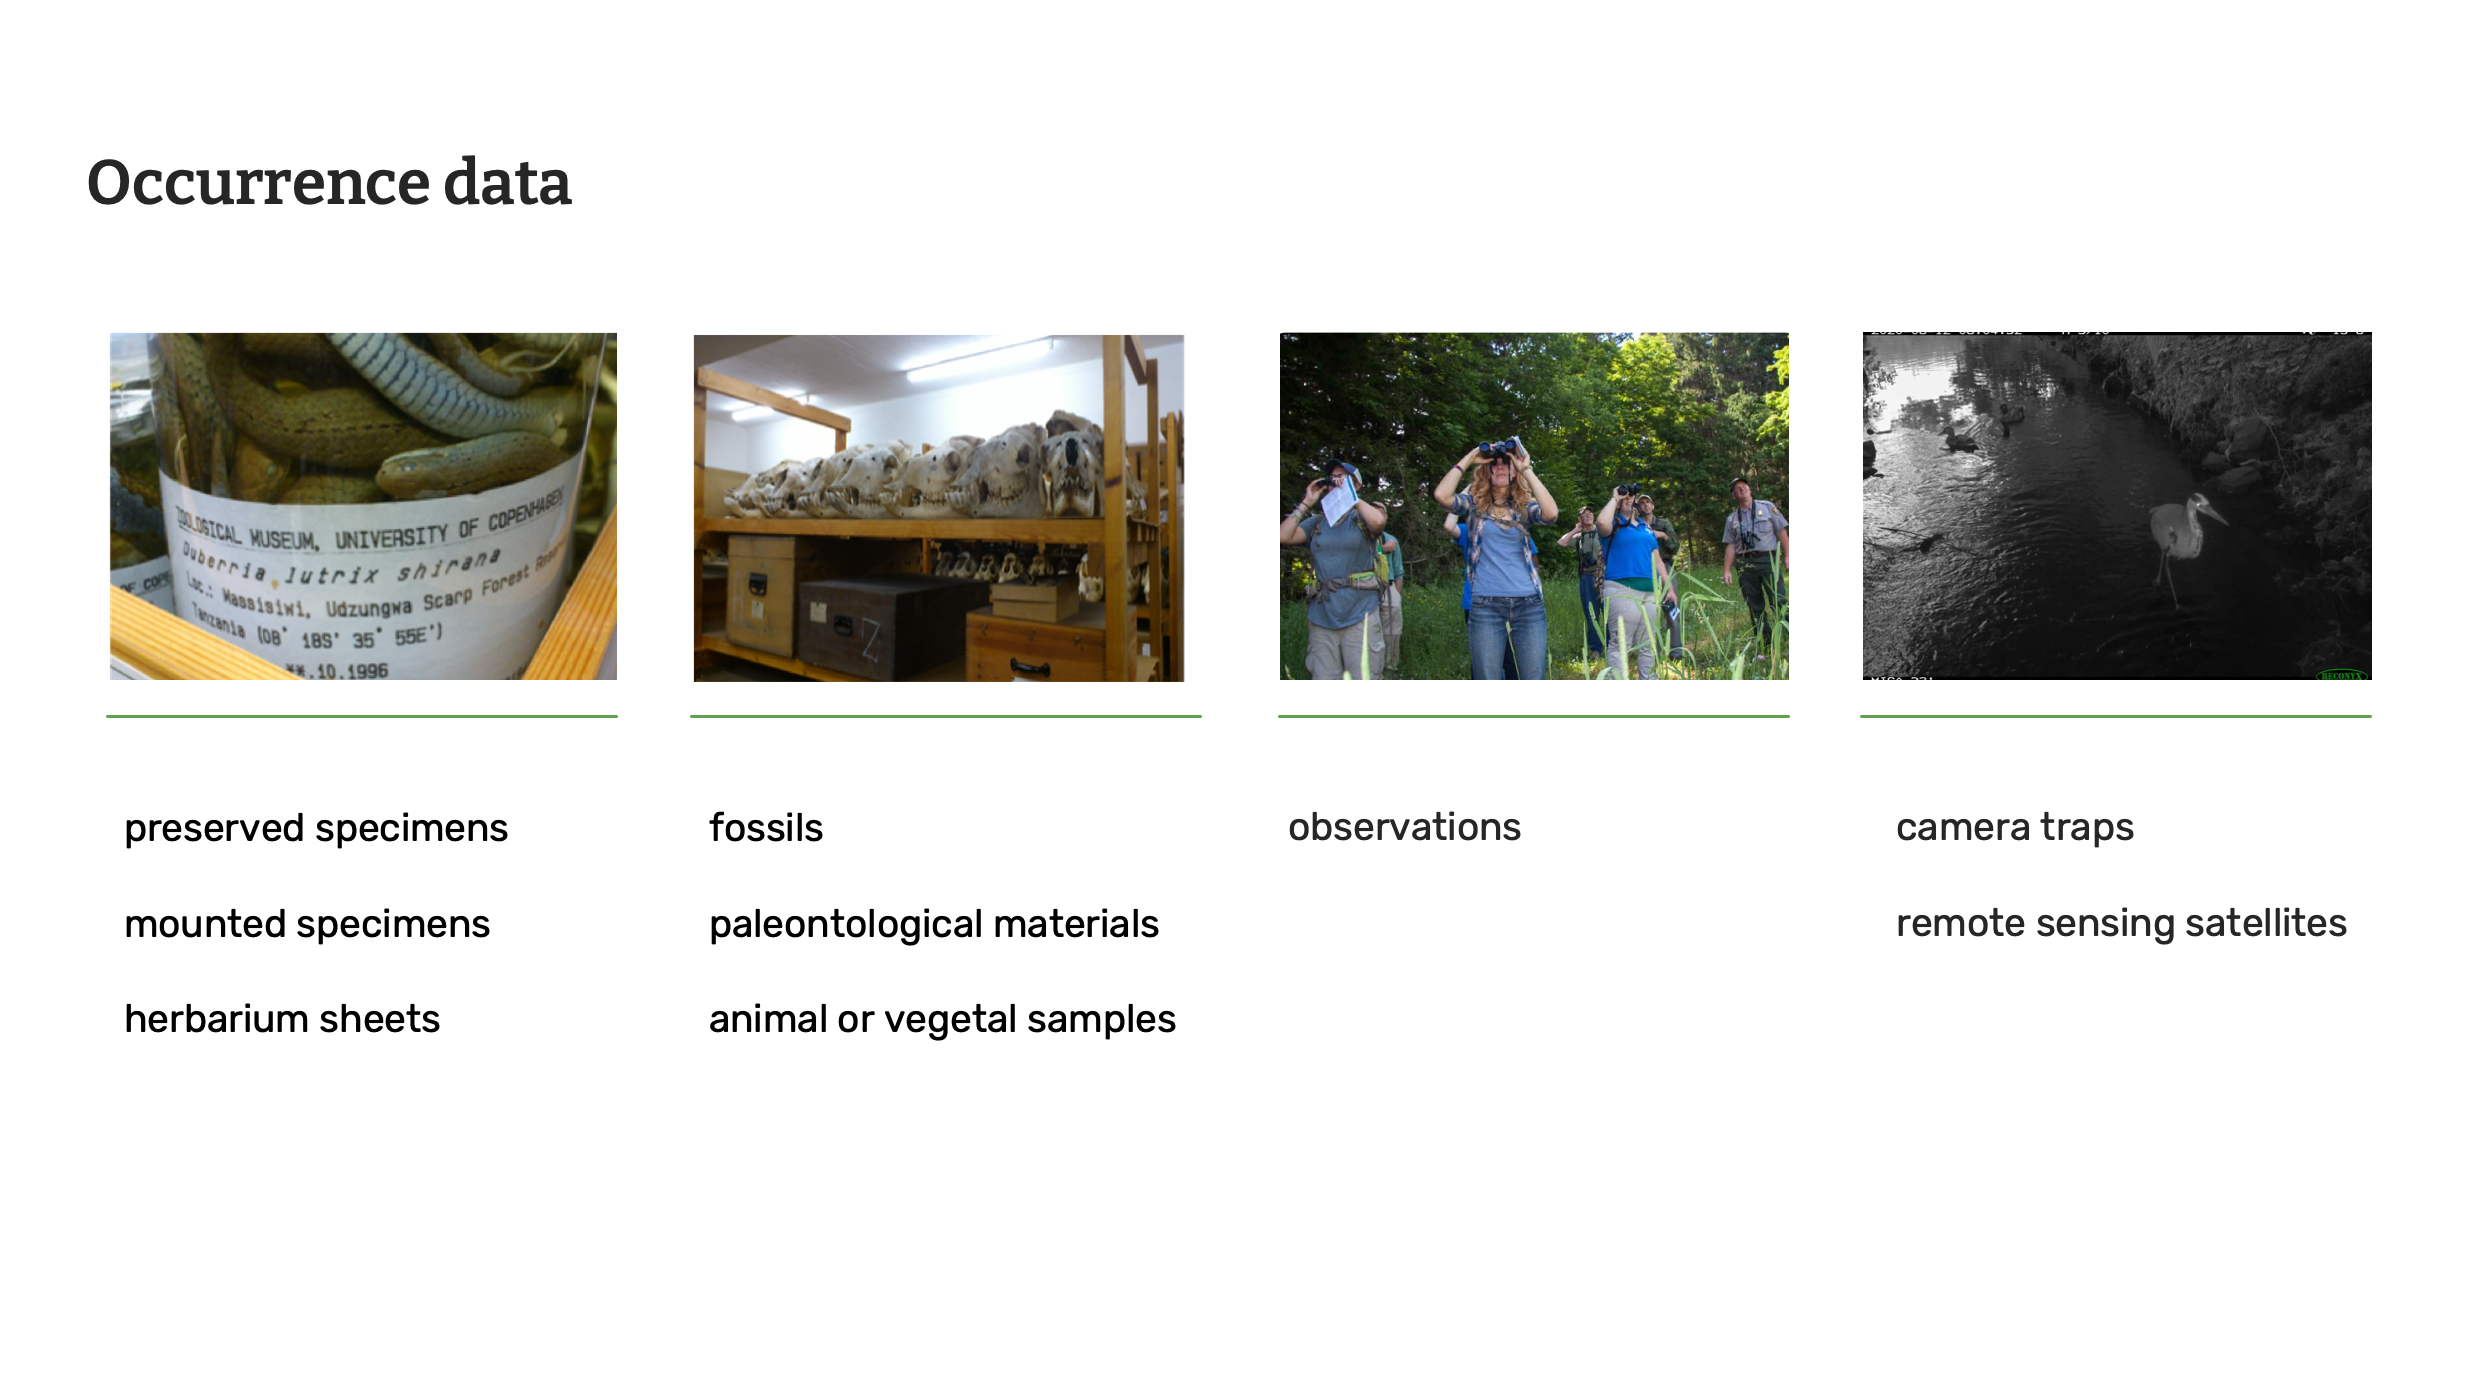
Слайд 5 — Данные о находках организмов
Другие наборы данных, публикуемые через GBIF.org, содержат достаточно подробную и согласованную информацию, чтобы предоставлять сведения о местонахождении отдельных организмов во времени и пространстве. Иными словами, они подтверждают присутствие вида (или другого таксона) в определённом месте в определённую дату.
Наборы данных о находках организмов составляют основную часть данных, публикуемых через GBIF.org. Они могут включать данные об экземплярах и ископаемых остатках из естественно-научных коллекций, наблюдения полевых исследователей и ученых-любителей, а также данные, полученные с помощью фотоловушек или спутников дистанционного зондирования.
Записи о находках в таких наборах данных иногда содержат лишь общую информацию о местонахождении, например только название страны. Однако во многих случаях более точные сведения о местонахождении и географические координаты позволяют проводить детальный анализ и картирование распространения видов.
https://multimedia.agouti.eu/assets/6d65f3e4-4770-407b-b2bf-878983bf9872/file [Снимок с фотоловушки]
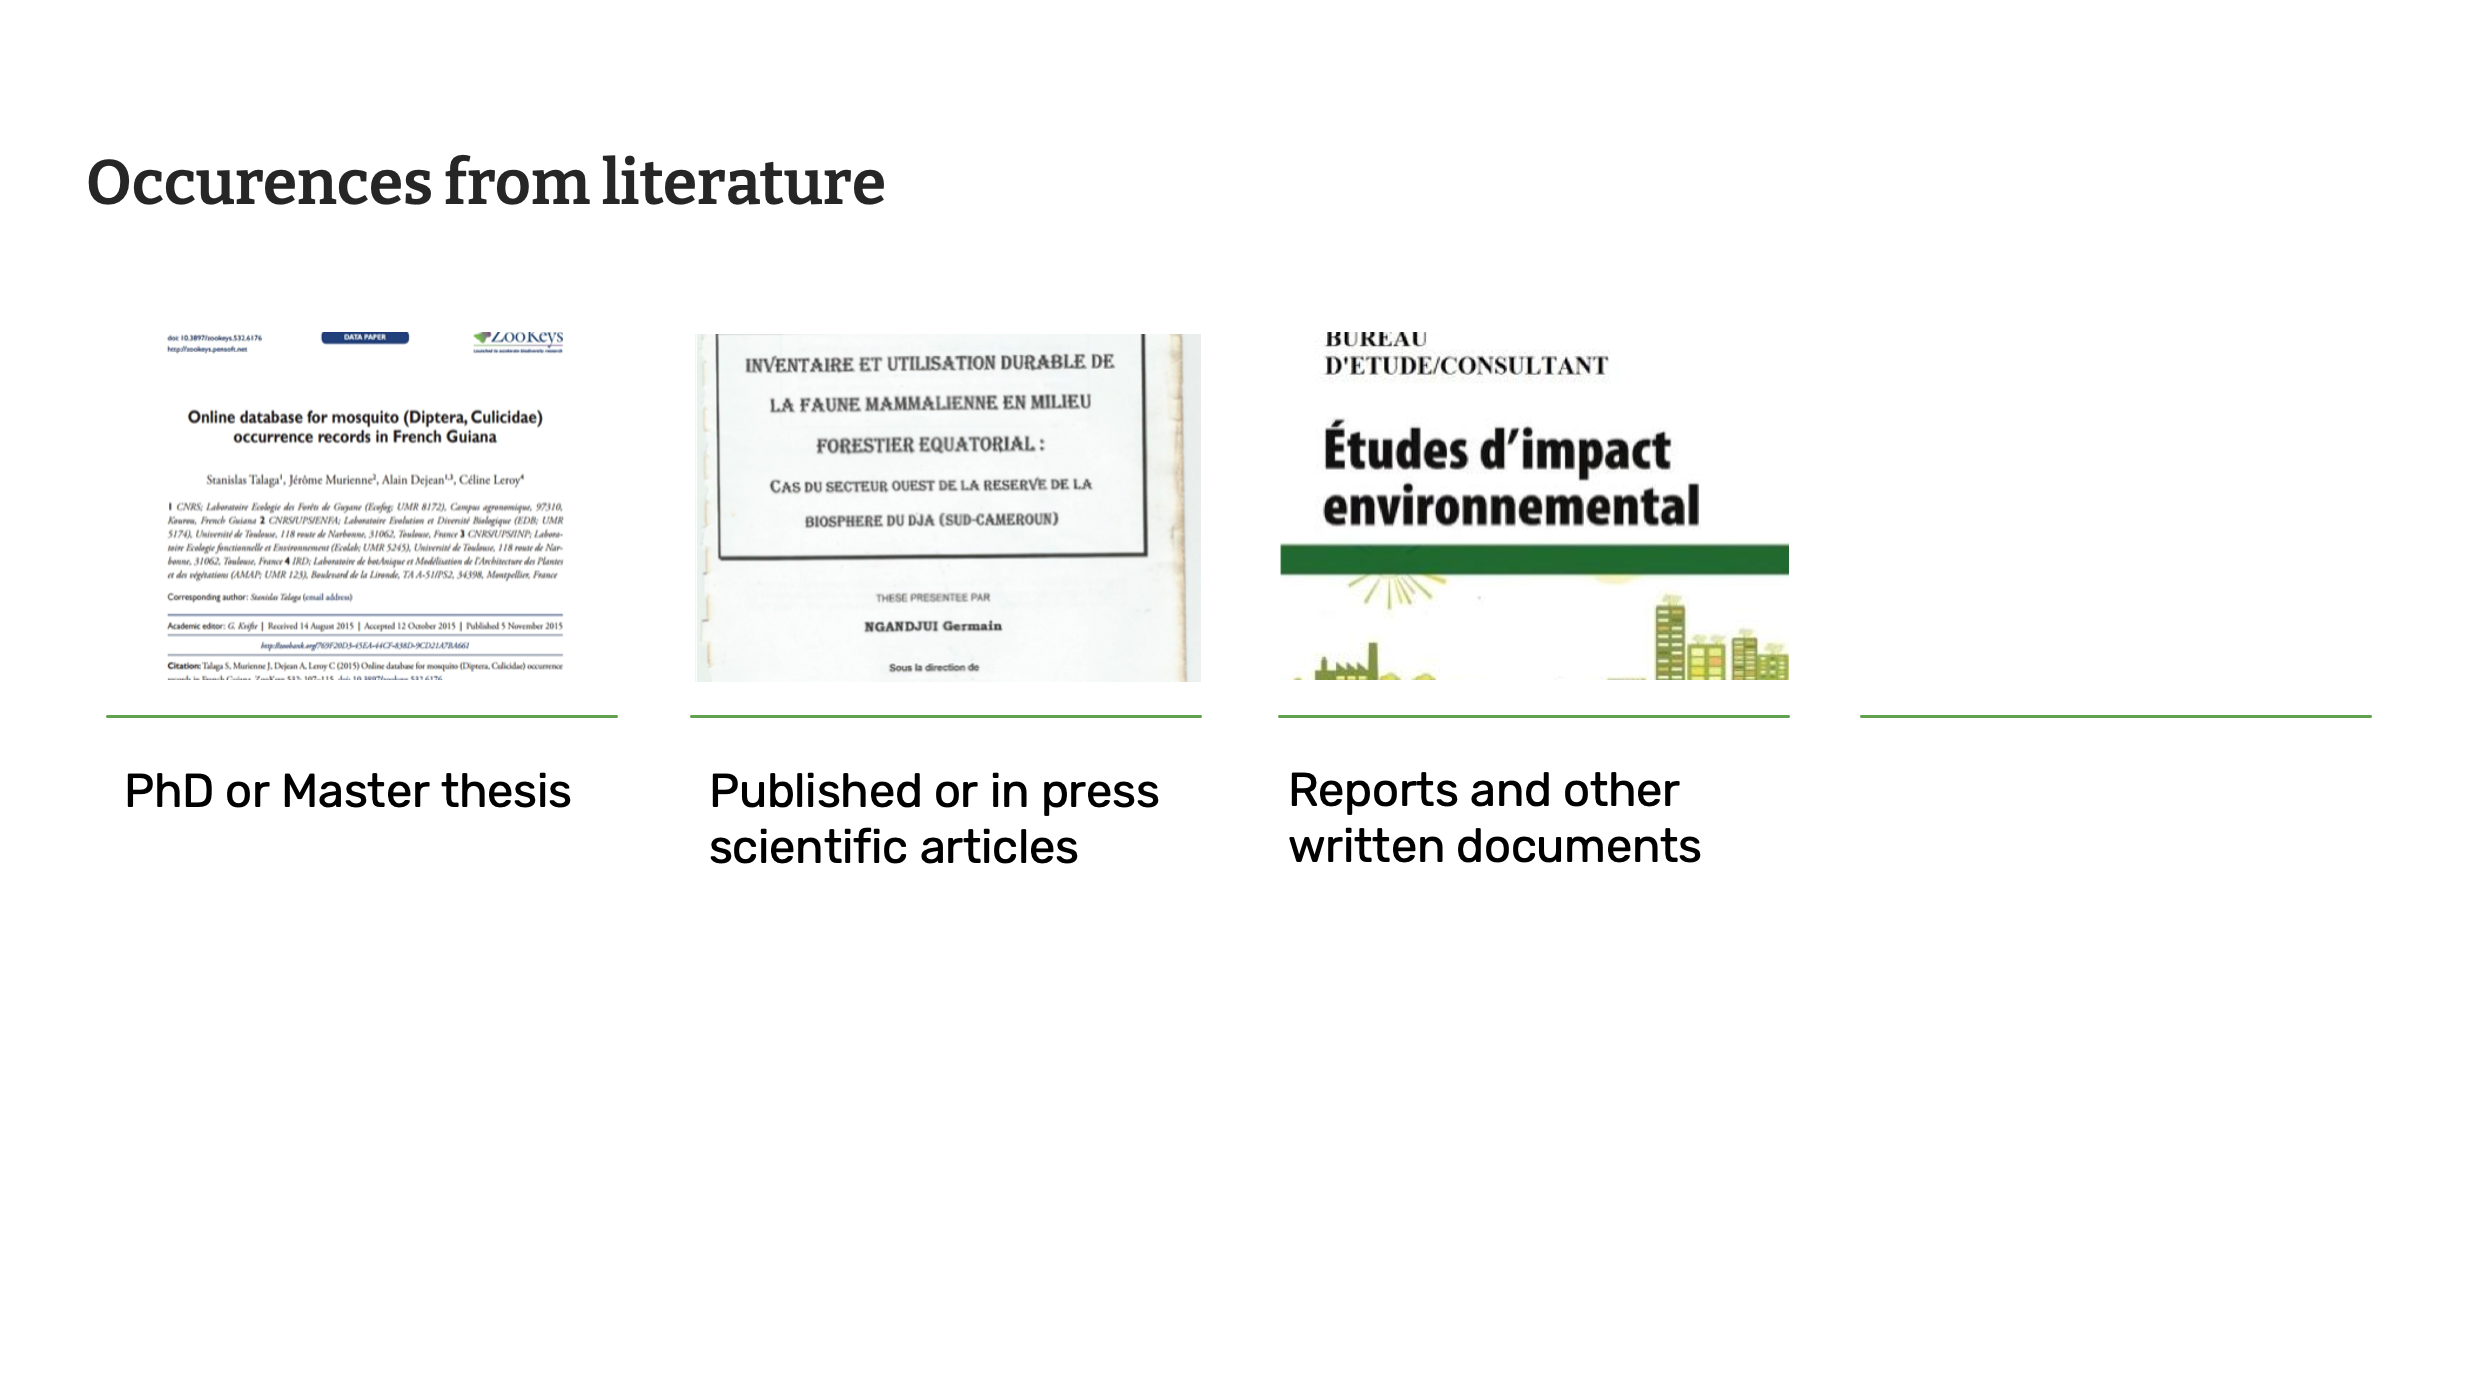
Слайд 6 — Данные о находках из литературных источников
Данные о биоразнообразии также можно найти в технической и научной литературе. Такие данные можно собирать и публиковать через GBIF, однако при этом следует особенно внимательно следить за тем, чтобы не публиковать дублирующиеся данные. Например, экземпляр, описанный в научной статье, уже может быть представлен на GBIF.org в наборе данных соответствующей коллекции.
При отсутствии оцифрованных наборов данных сведения о биоразнообразии можно извлекать и собирать из научных статей, докторских и магистерских диссертаций, отчётов и других документов. При сборе данных из литературных источников ВСЕГДА сначала связывайтесь с владельцем данных, чтобы получить разрешение на их публикацию в GBIF.
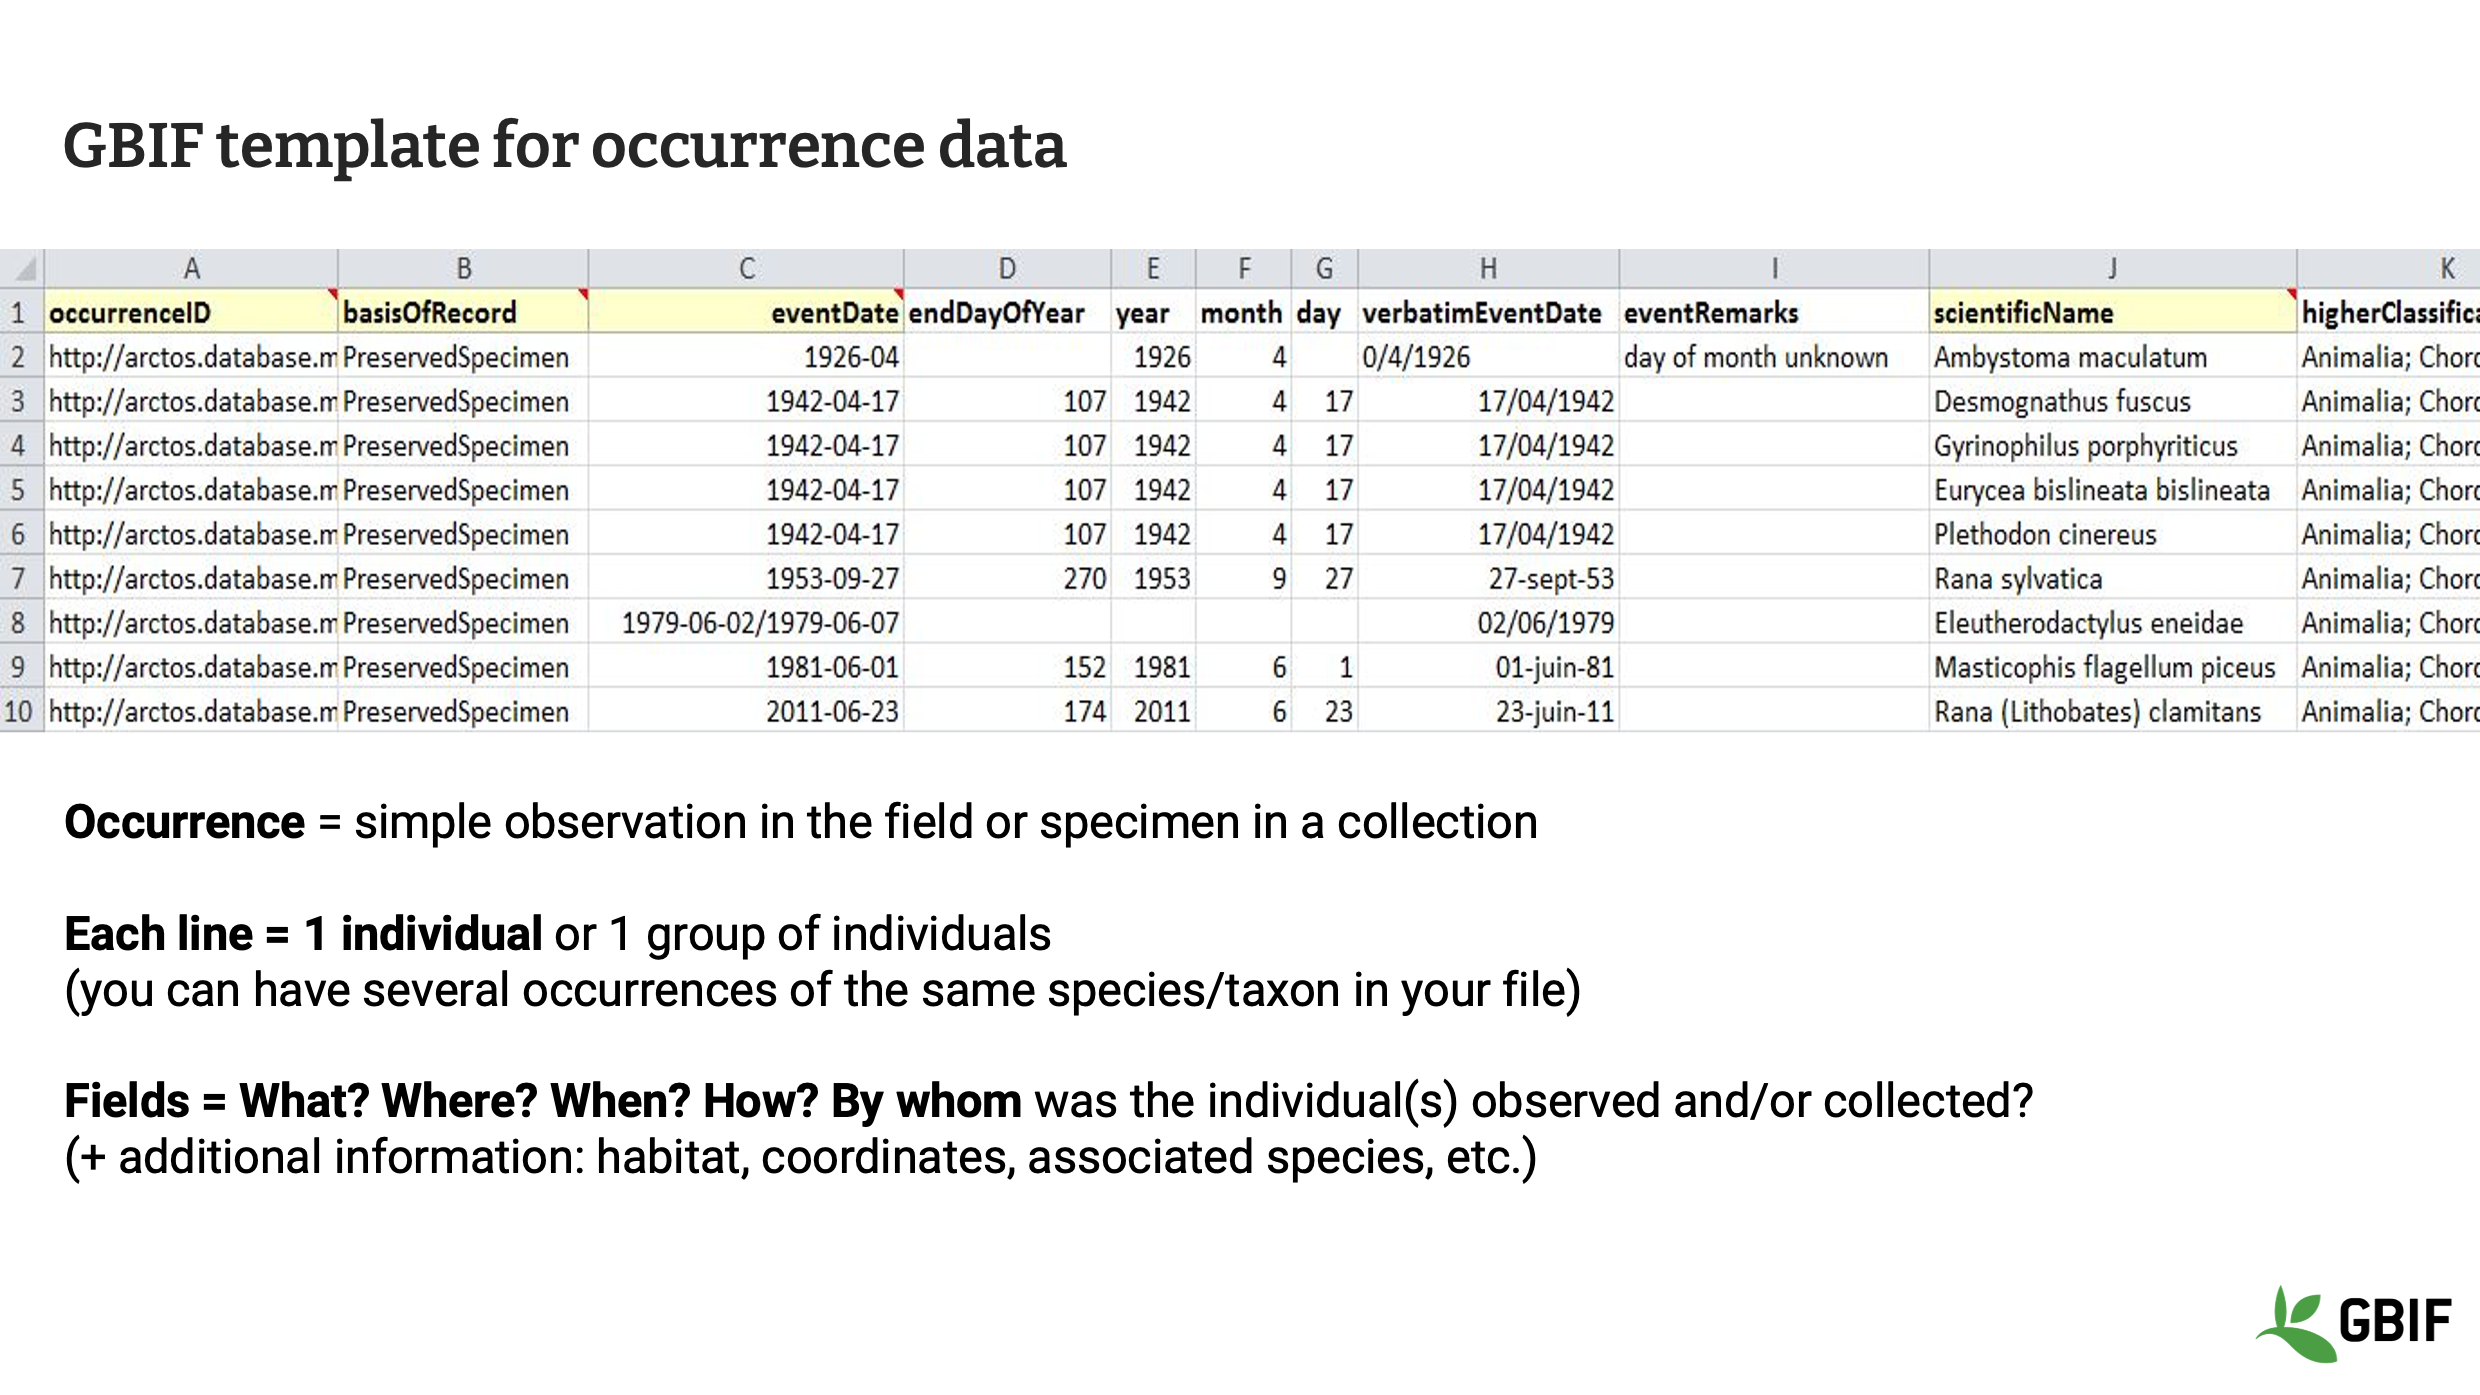
Слайд 7 — Шаблон GBIF для данных о находках организмов
Данные о находках организмов представляют собой тип наборов данных с наибольшим количеством записей на GBIF.org. С помощью этого шаблона в GBIF можно публиковать данные из коллекций, наблюдений и литературных источников, при этом основное внимание уделяется наблюдаемым особям или собранным экземплярам. В данном наборе данных для одного таксона может быть зарегистрировано несколько особей или экземпляров при условии, что каждый из них имеет уникальный идентификатор. Другие поля данных о находках содержат информацию о том, где, когда, каким образом и кем каждая находка была зарегистрирована и/или собрана в полевых условиях.
Слайд 8 — Данные о событиях отбора проб
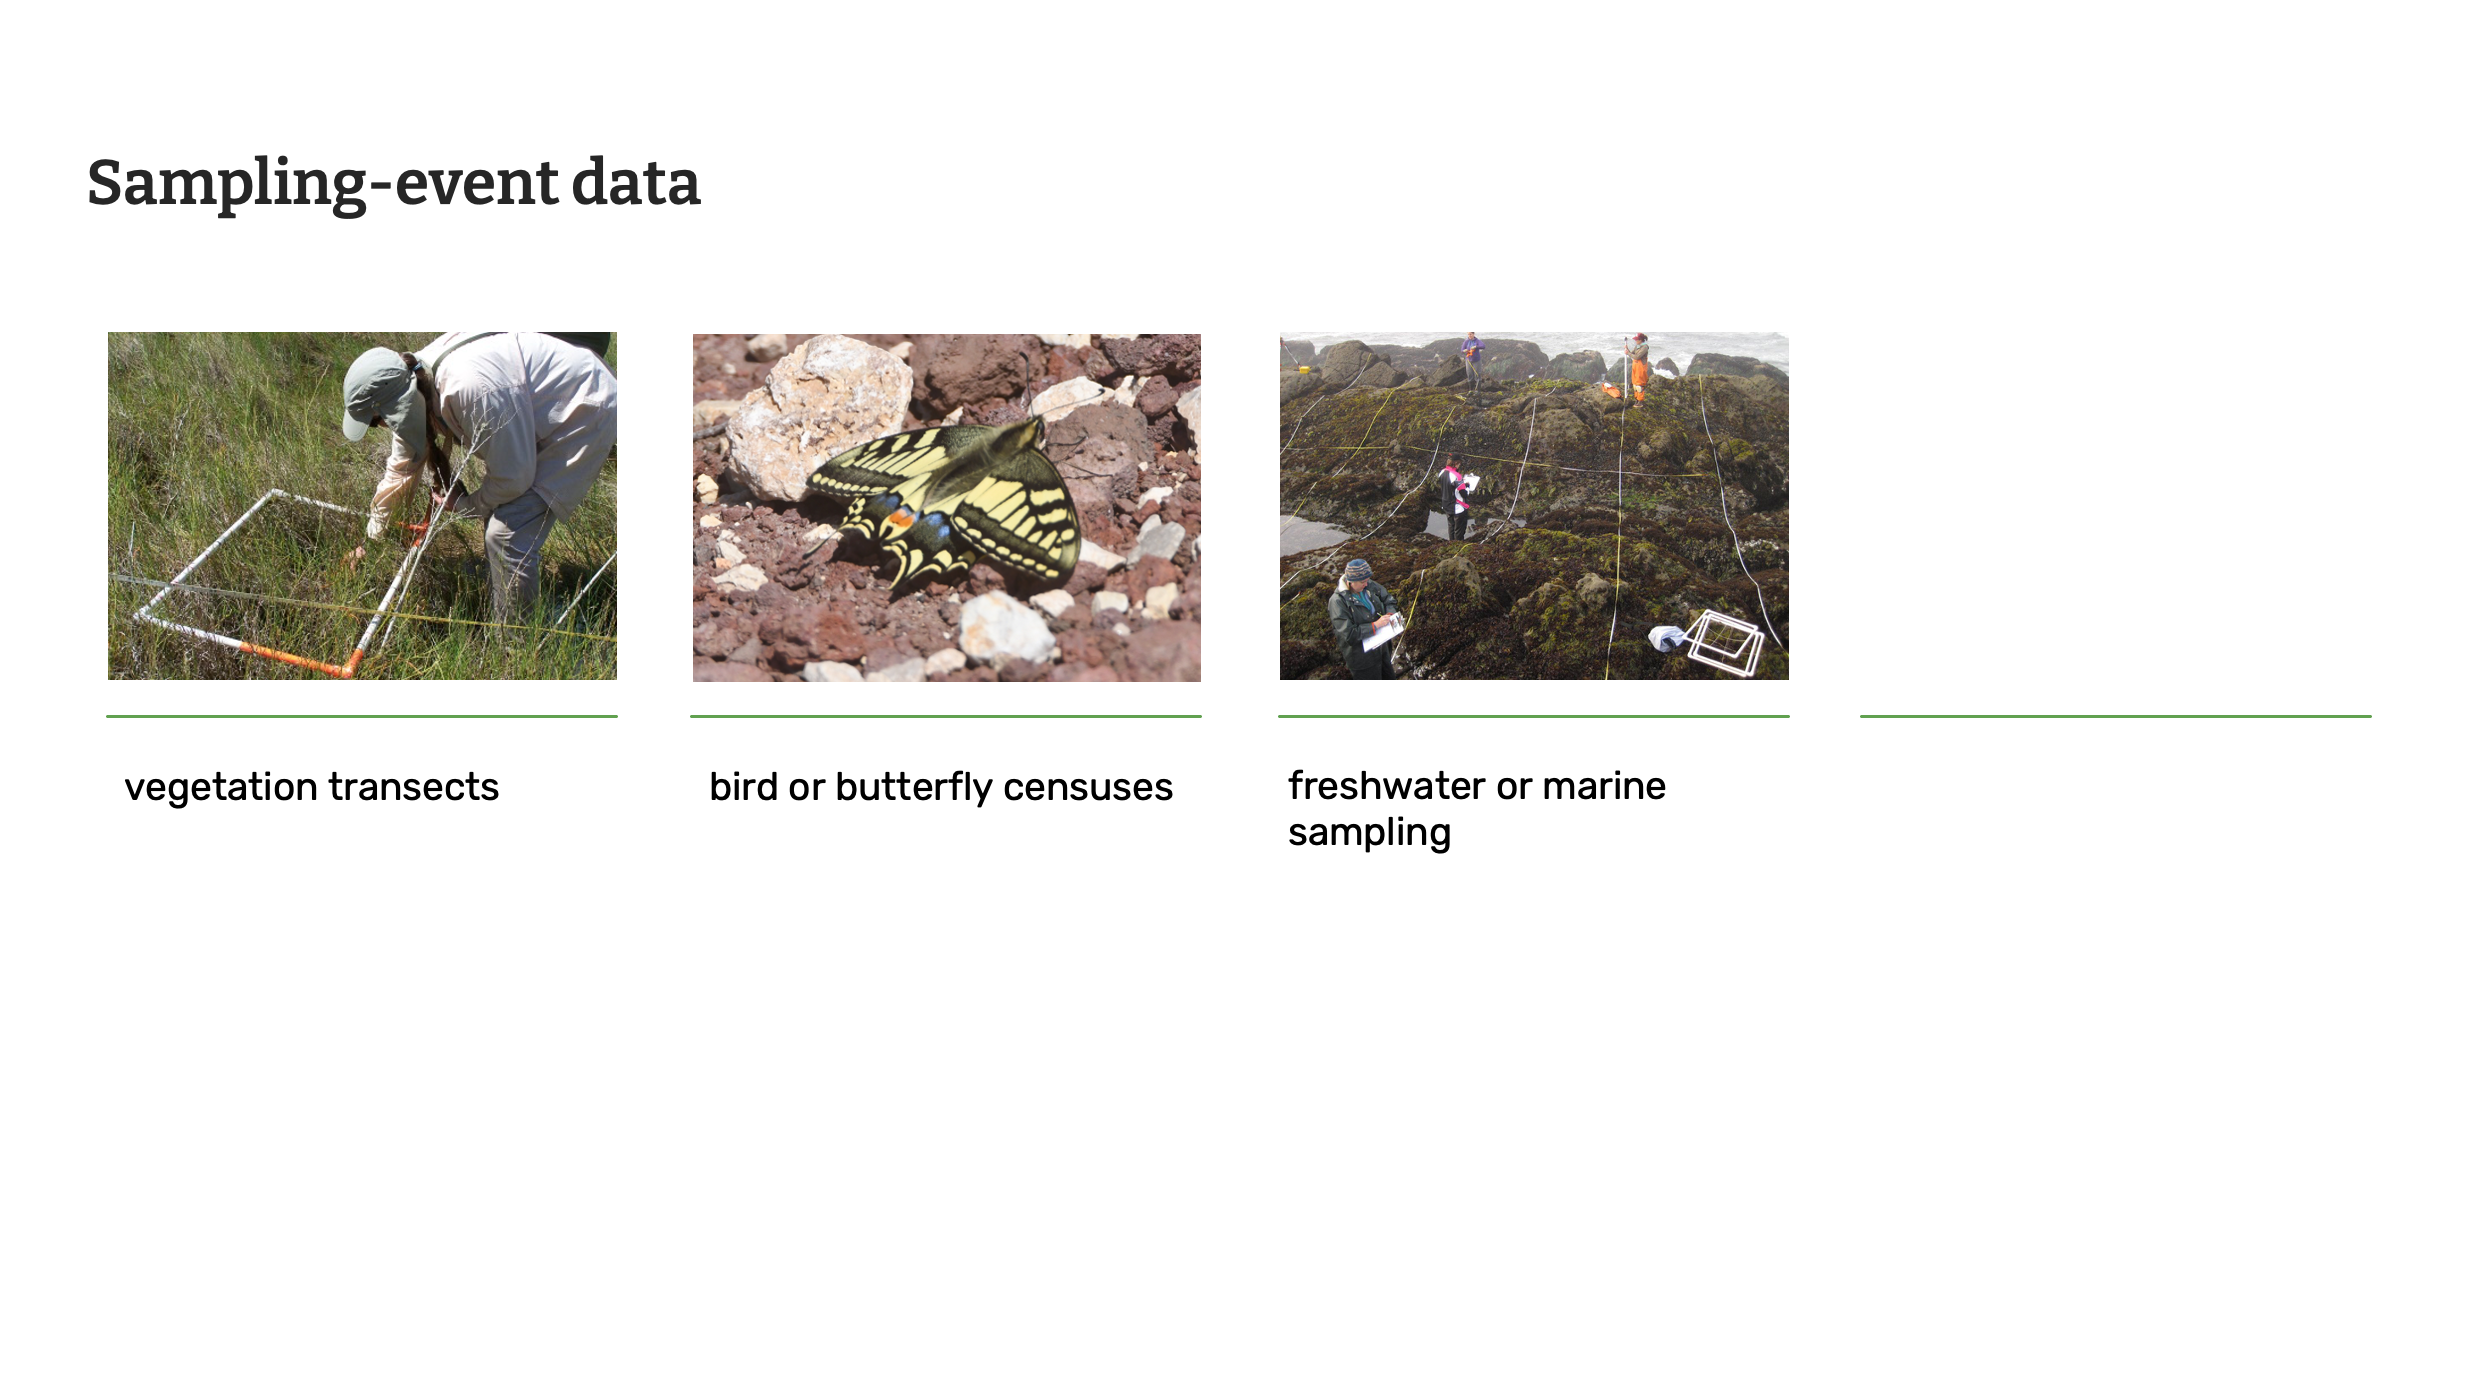
Некоторые наборы данных содержат более подробную информацию, не только подтверждая присутствие вида в определённом месте и в определённую дату, но и позволяя оценивать состав сообществ для более широких таксономических групп или даже численность видов в разные периоды времени и в разных местах. Такие количественные наборы данных, или наборы данных о событиях отбора проб, обычно получают с использованием стандартных протоколов изучения и мониторинга биоразнообразия, таких как растительные трансекты, учёты птиц и отбор проб в пресноводных или морских экосистемах.
Указывая методы, события отбора проб и относительную численность видов, зарегистрированных в пробе, такие наборы данных позволяют лучше сравнивать данные, собранные с использованием одних и тех же протоколов в разное время и в разных местах. В некоторых случаях это даже позволяет исследователям делать вывод об отсутствии определённых видов в конкретных местах.
https://www.usgs.gov/media/images/sampling-permanent-vegetation-transects [Трансект растительности — USGS] https://www.gbif.us/post/2024/marine-published/ [Исследование приливной зоны]
Слайд 9 - Шаблон GBIF для данных о событиях отбора проб
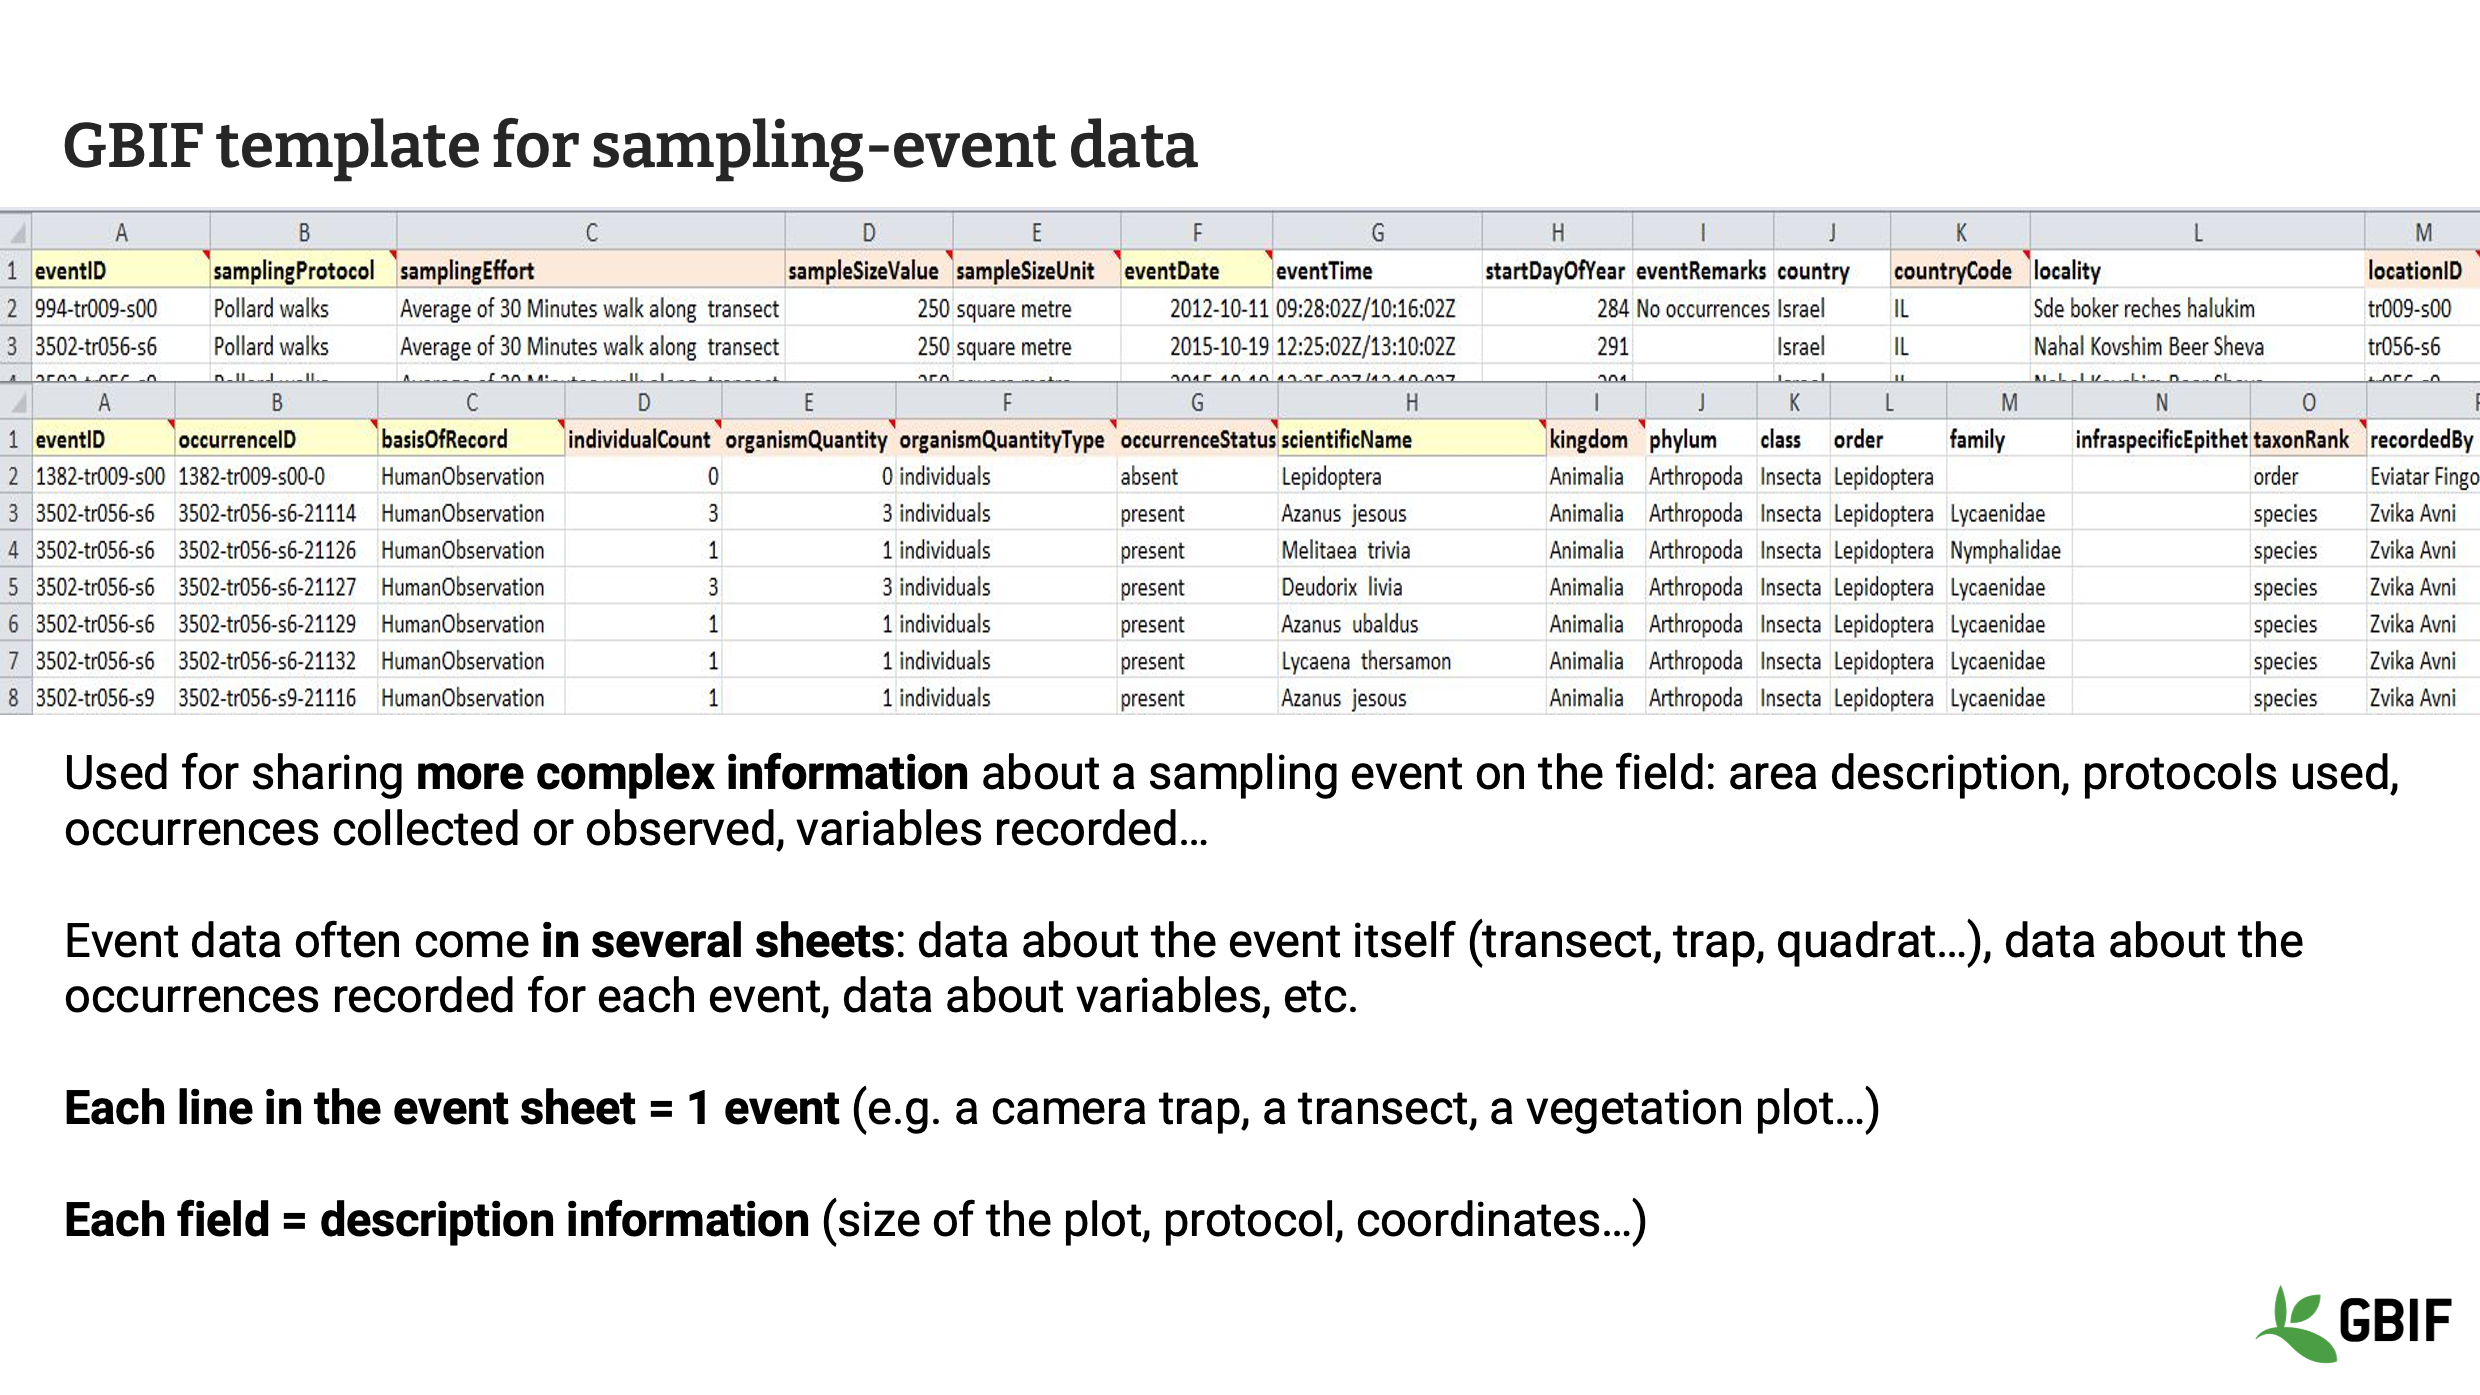
Шаблон GBIF для данных о событиях позволяет издателям данных предоставлять больше информации о контексте событий сбора или регистрации данных о биоразнообразии, таких как использование фотоловушек, ловушек для насекомых, выполнение геоботанических описаний, учётов птиц и т. д. Его структура несколько сложнее, чем структура таксономических наборов данных и наборов данных о находках организмов, поскольку включает как минимум два файла (например, две вкладки в электронной таблице): один для описания событий (например, каждой ловушки), а другой — для описания экземпляров или находок организмов, связанных с каждым событием. Также могут использоваться дополнительные файлы или вкладки для описания измерений или фактов либо для предоставления более подробной информации о протоколах отбора проб.
Слайд 10 — Типы наборов данных и требования к качеству данных
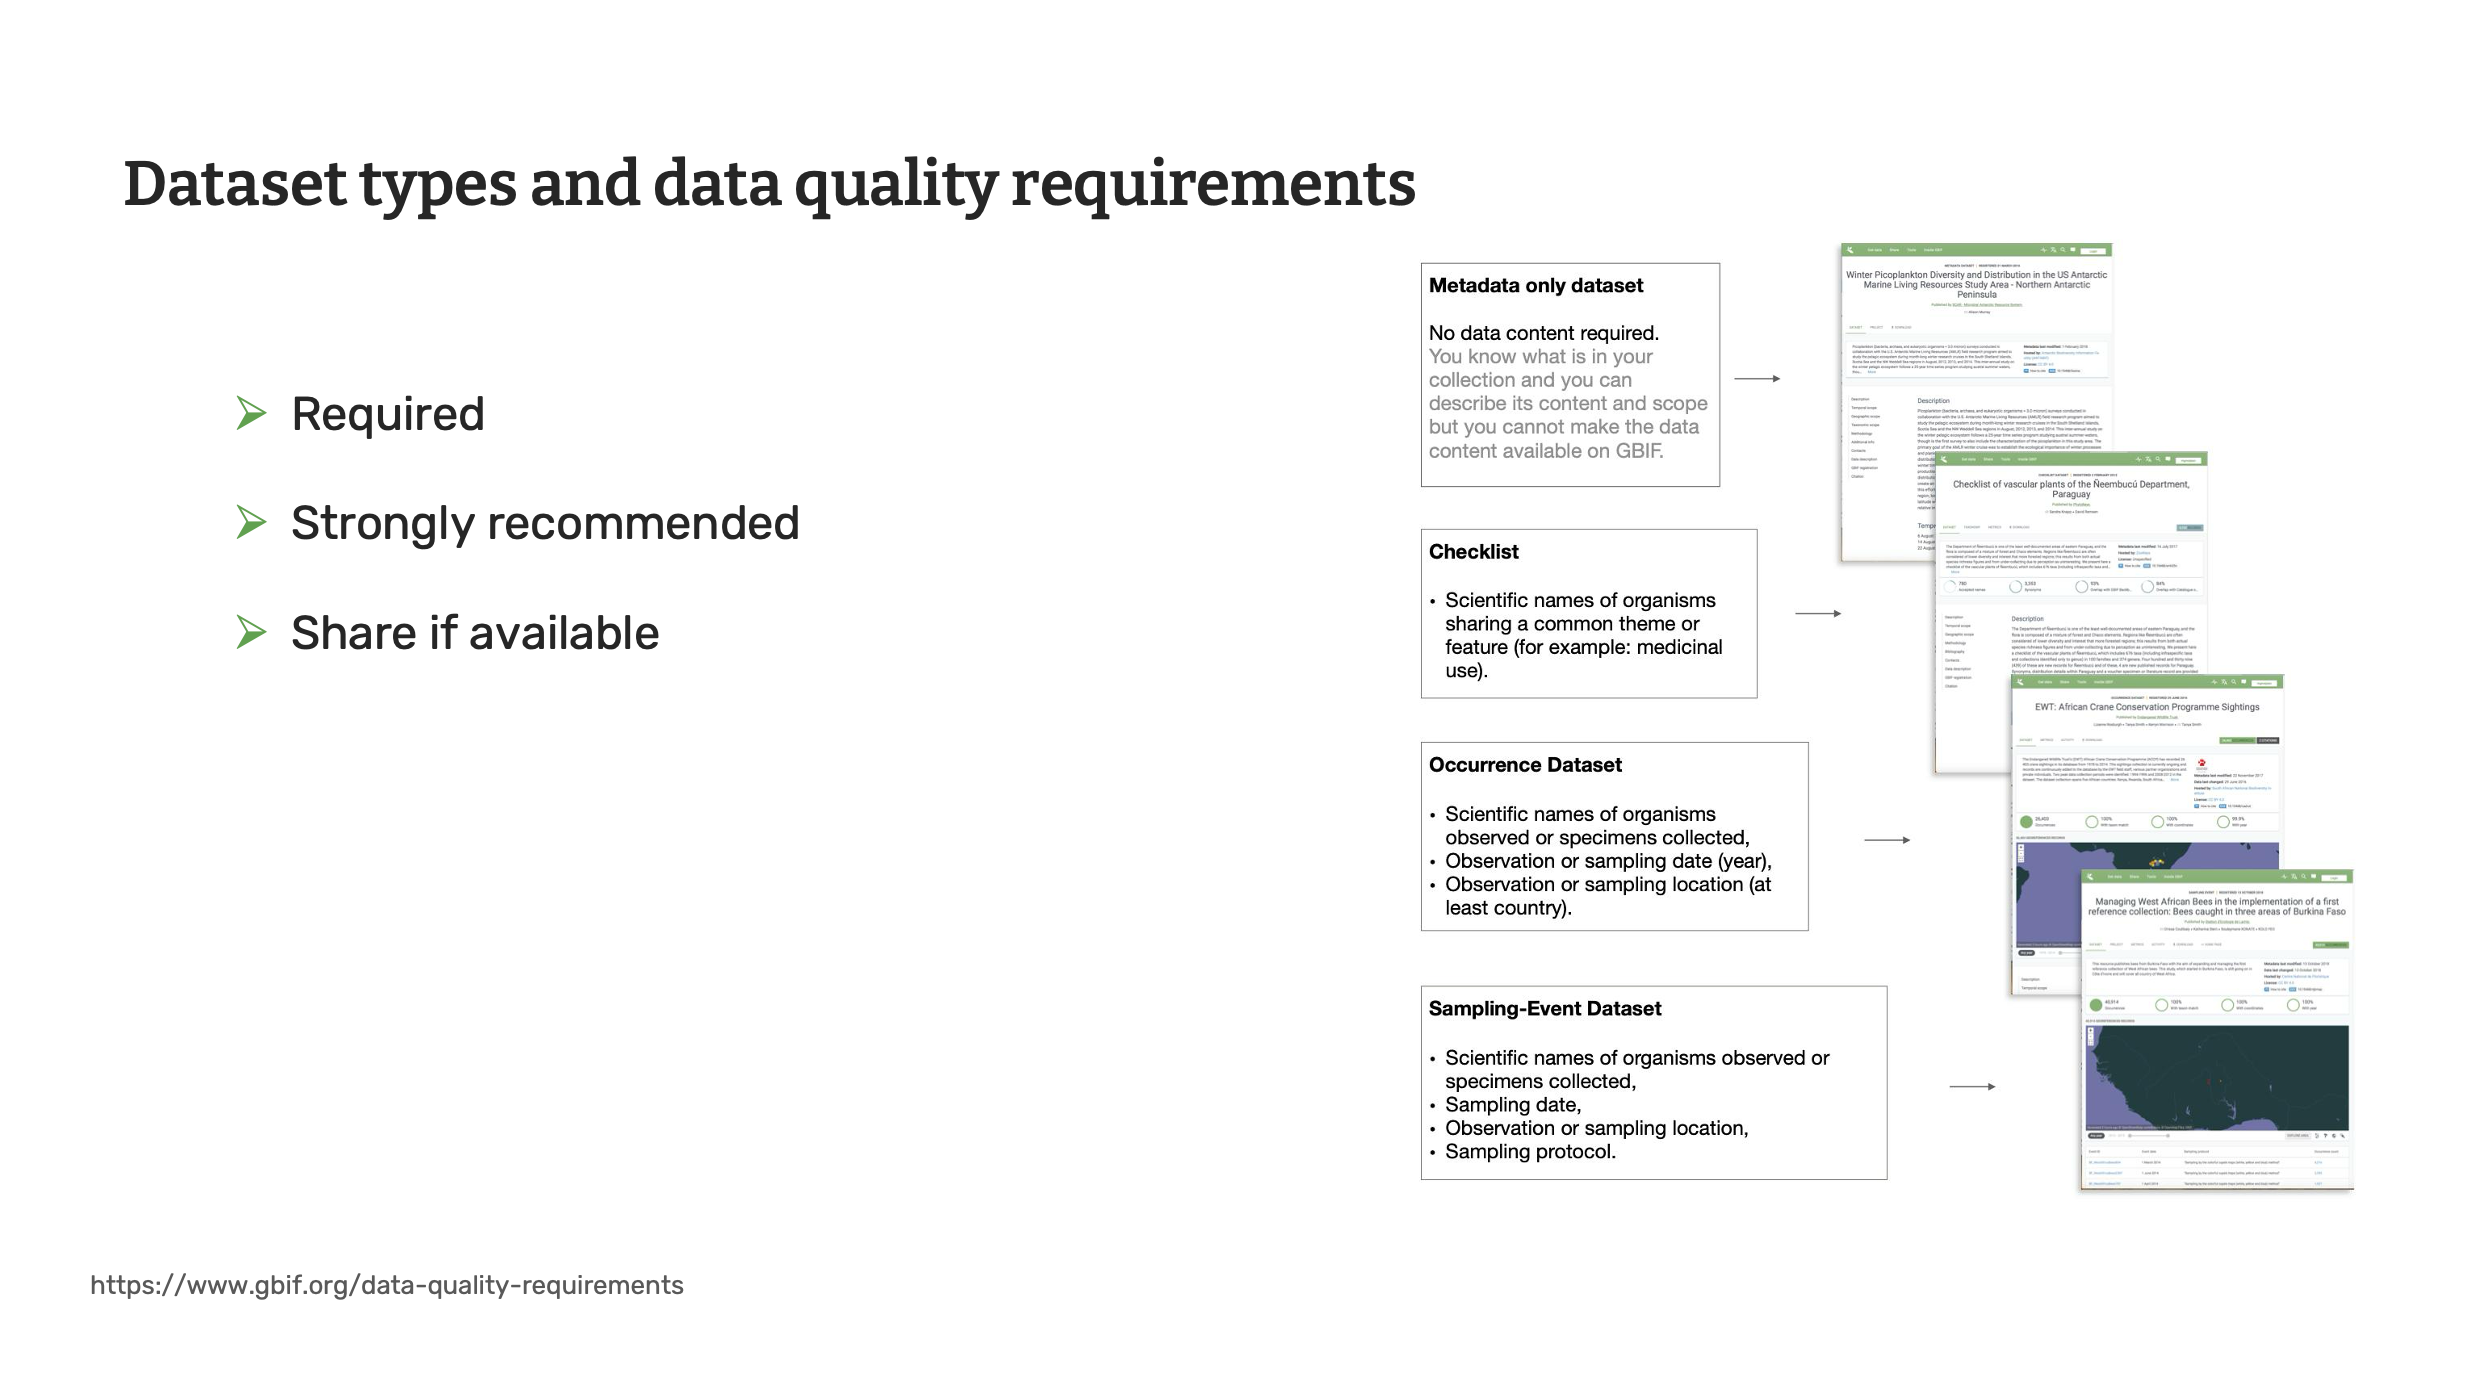
GBIF устанавливает требования к качеству данных, которые определяют, какую информацию следует предоставлять для каждого типа наборов данных. Это не означает, что данные не будут проиндексированы, если некоторые значения отсутствуют, однако эти требования определяют, какая информация считается значимой для каждого типа наборов данных. Разумеется, вы можете предоставлять и больше информации.
Некоторые элементы являются обязательными (например, occurrenceID, taxonID или eventID — в зависимости от типа набора данных), другие необязательны, но настоятельно рекомендуются (например, географические координаты в десятичных градусах). С этими требованиями можно ознакомиться на GBIF.org.
Слайд 11 — Как выбрать тип набора данных?
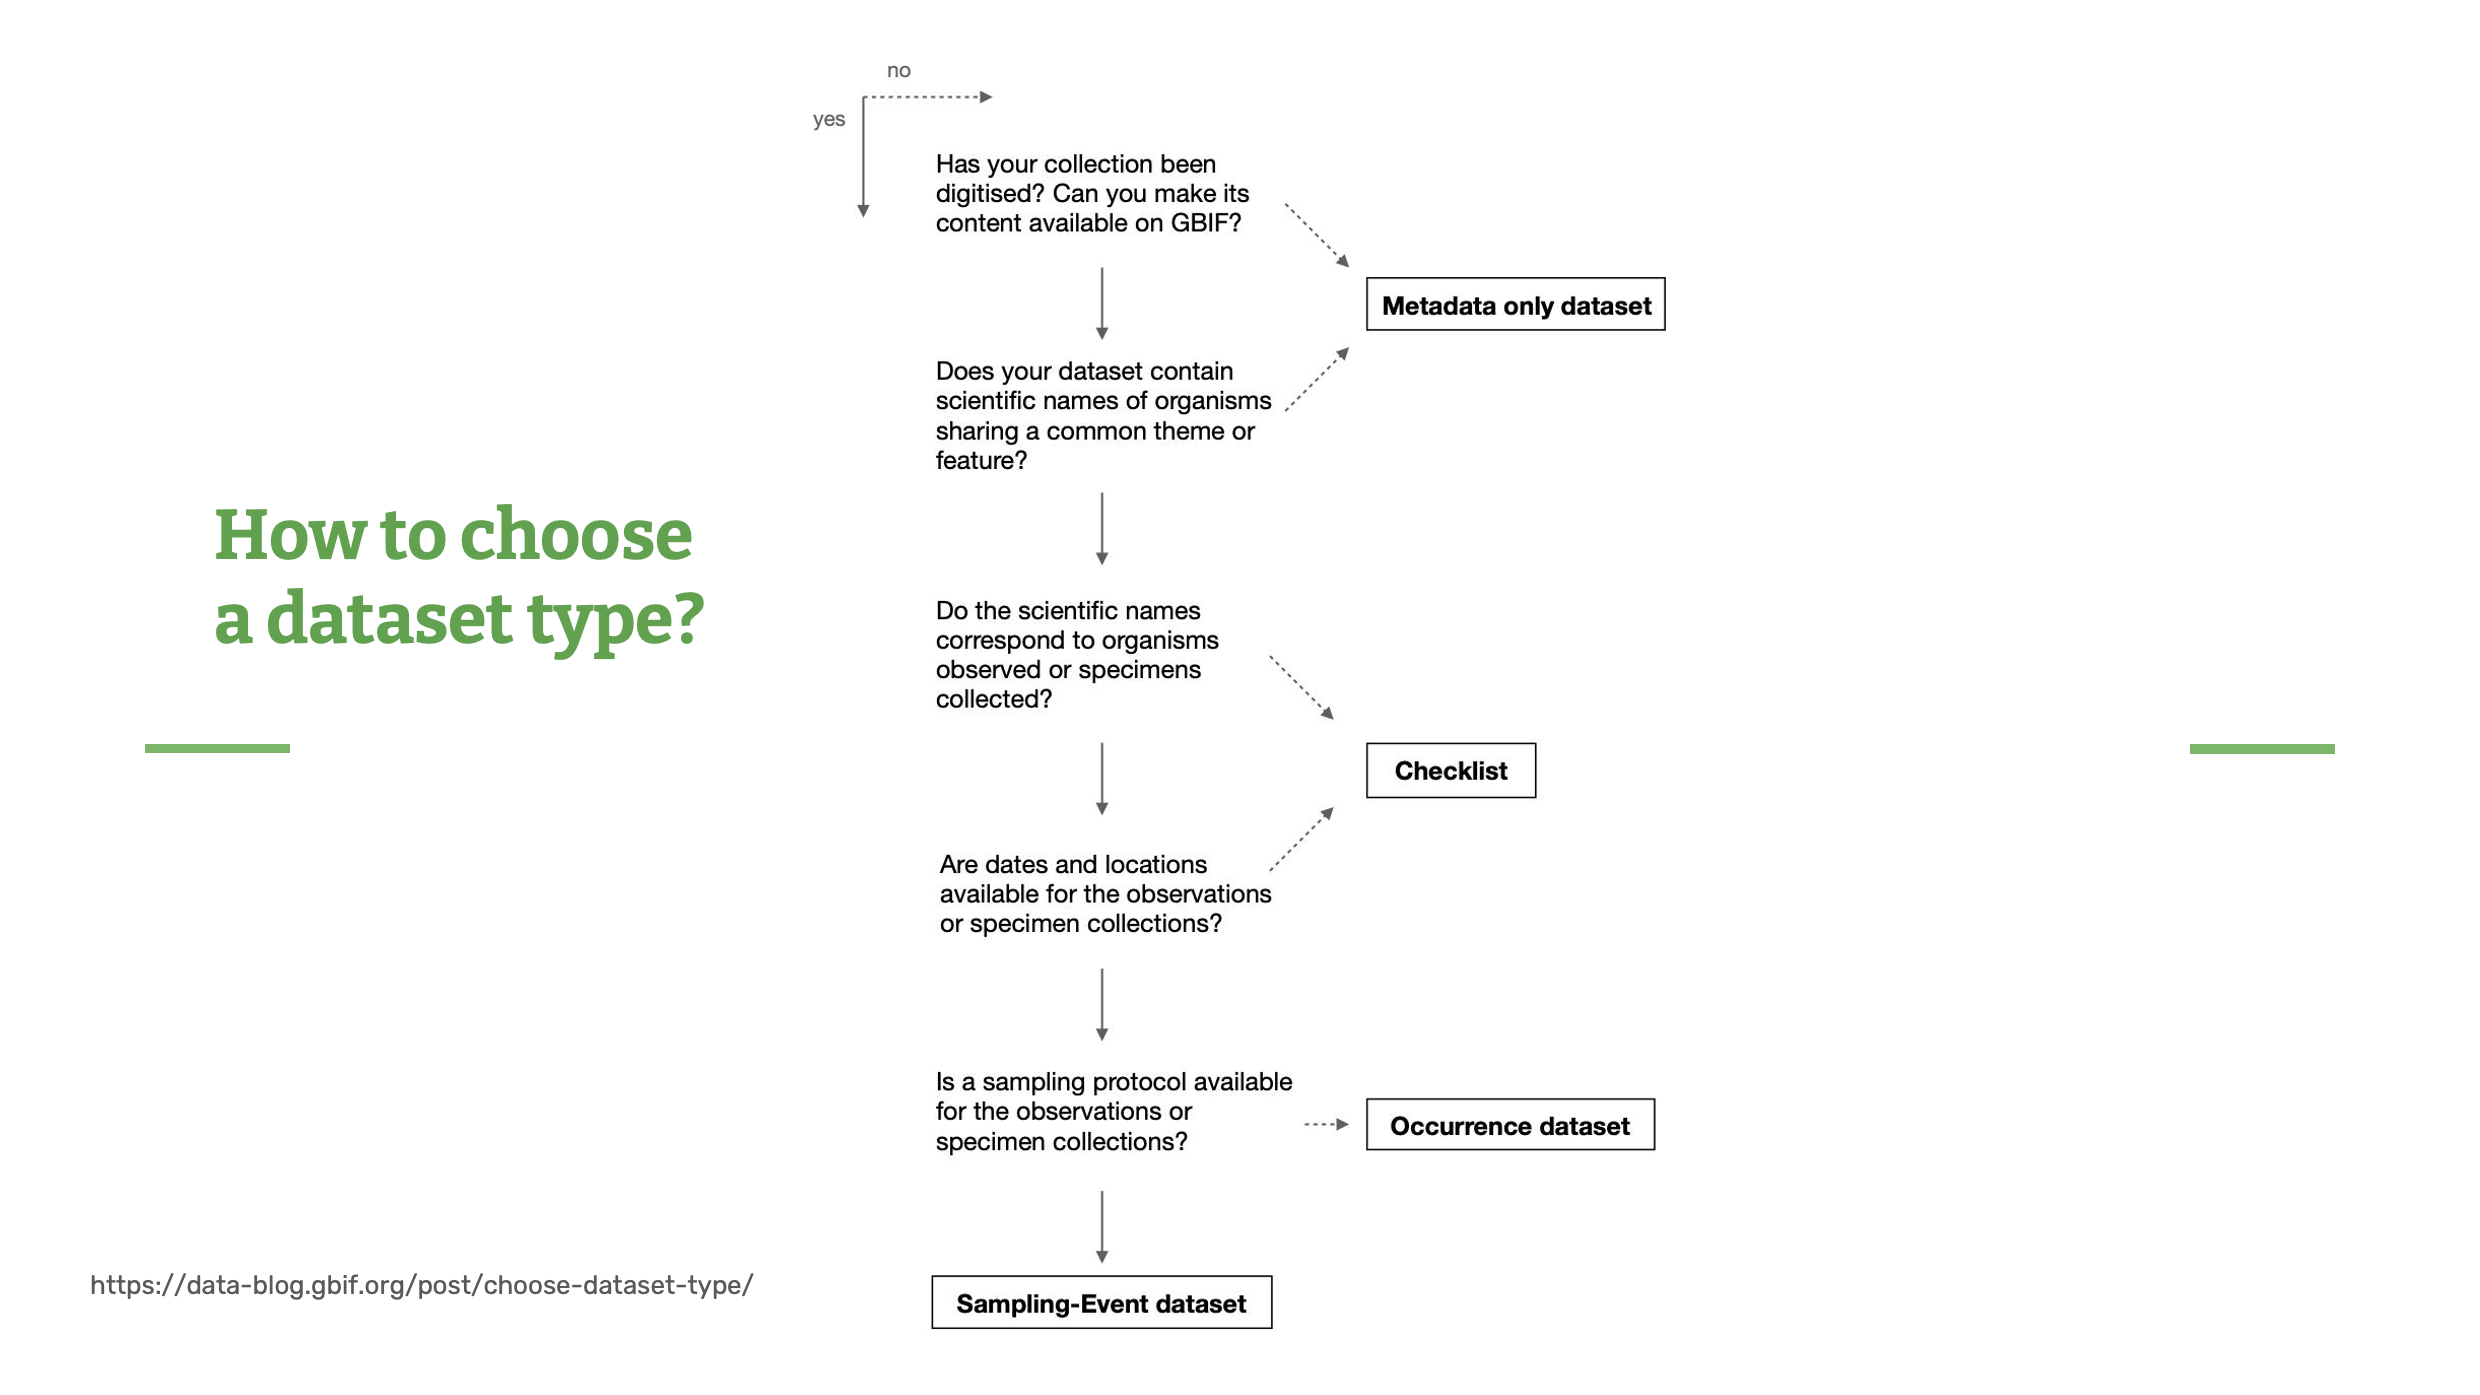
Мы понимаем, что выбор типа набора данных может занять некоторое время, особенно если вы только начинаете заниматься мобилизацией данных и их публикацией через GBIF. Команда службы поддержки GBIF подготовила полезную блок-схему, которую можно найти в блоге GBIF Data Blog и использовать, если вам нужна дополнительная помощь при выборе типа набора данных.
Слайд 12 — Подведение итогов
Чтобы иметь возможность публиковать данные через GBIF, важно понимать различия между типами наборов данных уже на ранних этапах сбора данных и управления ими. Вы можете обдумать эту тему с помощью следующих вопросов:
С какими данными вы работаете?
Отличается ли тип ваших данных от того, каким вы представляли его изначально?
Как бы вы опубликовали эти данные в GBIF?
Слайд 13 — Заключение
Эта презентация является частью серии презентаций, используемых в курсе GBIF по мобилизации данных о биоразнообразии. Учебная программа по мобилизации данных о биоразнообразии была первоначально разработана в рамках Программы развития информационных ресурсов по биоразнообразию (Biodiversity Information for Development Programme), финансируемой Европейским союзом.
Данная презентация была первоначально подготовлена Sophie Pamerlon при участии Laura Anne Russell, а также тренеров и наставников GBIF. Закадровый текст к презентации озвучила я, Laura Anne Russell.
Сбор данных, их обработка и качество
|
В этом видео (12:06) вы познакомитесь с принципами качества данных, применяемыми при их сборе, в частности при внесении данных с этикеток коллекционных экземпляров, из полевых дневников, электронных таблиц и других источников. Если у вас не получается посмотреть встроенное видео, вы можете download скачать его на свой компьютер. Субтитры к этому видео пока недоступны. (MP4 — 42 МБ) Если вы предпочитаете ознакомиться с материалом в текстовом виде, транскрипт видеоролика приведён ниже |
Presentation transcript
Нажмите, чтобы раскрыть
Слайд 1 — Сбор, обработка и качество данных
Эта презентация основана на работе Артура Чепмена «Принципы качества данных» (Principles for data quality)
Слайд 2 — Структура
В этой презентации мы рассмотрим принципы качества данных применительно к их сбору, в частности при внесении данных с этикеток коллекционных экземпляров, из полевых дневников, электронных таблиц и других источников.
Слайд 3 — Разработка рабочего процесса обработки и контроля качества данных
Качество данных имеет важное значение на каждом этапе процесса мобилизации данных, особенно на этапах их сбора.
Каждый участник процесса сбора данных несёт определённую ответственность за их качество, однако большинство решений, связанных с качеством данных, должны приниматься на уровне учреждения.
Ключевые слова здесь: планирование и документирование!
Как уже упоминалось в презентации «Основы — Документация», используйте существующие стандарты и планируйте рабочие процессы в соответствии с вашими целями; документируйте всё, что возможно, на каждом этапе и по возможности делитесь документами, данными, инструментами и стандартами или используйте их повторно.
Слайд 4 — Рабочий процесс обработки и контроля качества данных
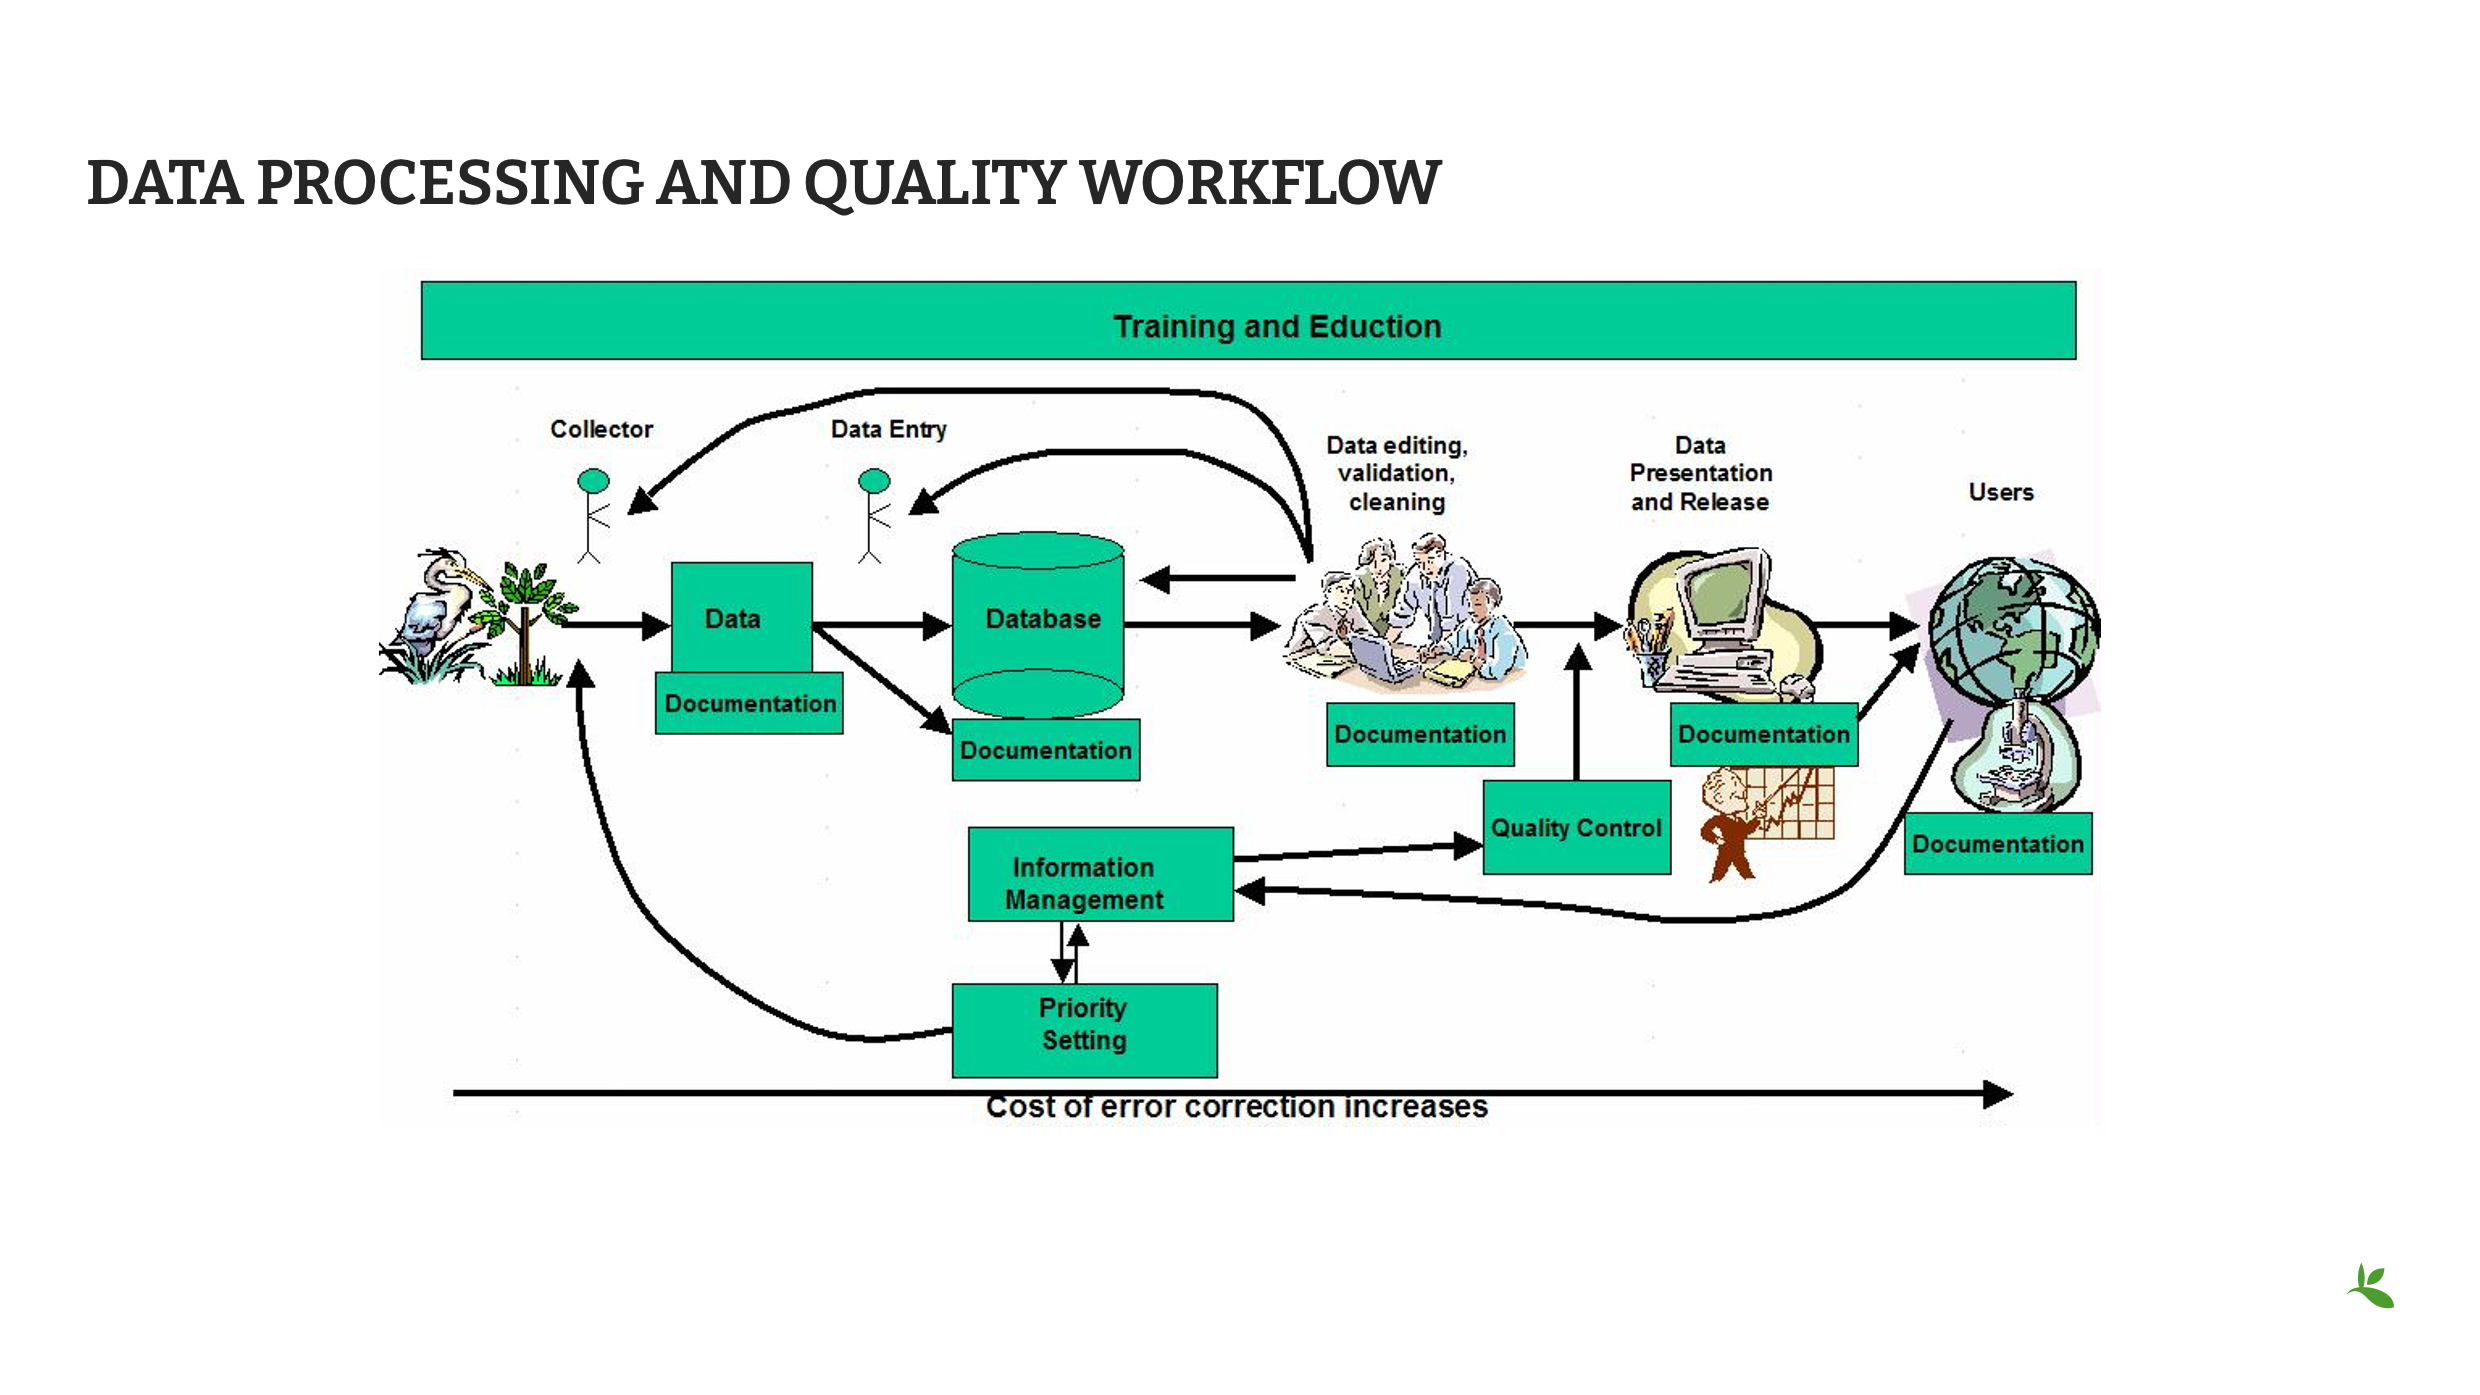
Это пример рабочего процесса обеспечения качества данных.
В этом рабочем процессе всё начинается со сбора экземпляров, затем следуют сбор данных, контроль качества, публикация и, наконец, использование данных.
Качество данных — это ответственность не только первого участника процесса (в данном случае коллектора): она распределяется между всеми этапами, и каждый участник процесса должен нести ответственность за качество данных.
Для проверки, дополнения, обновления или исправления данных необходимо обеспечить работающий механизм обратной связи.
Именно здесь документирование имеет ключевое значение: необходимо знать, кто отвечал за каждый этап процесса, чтобы проверять изменения, которые уже были внесены в данные или которые необходимо внести.
Слайд 5 — Ответственность за обработку и качество данных
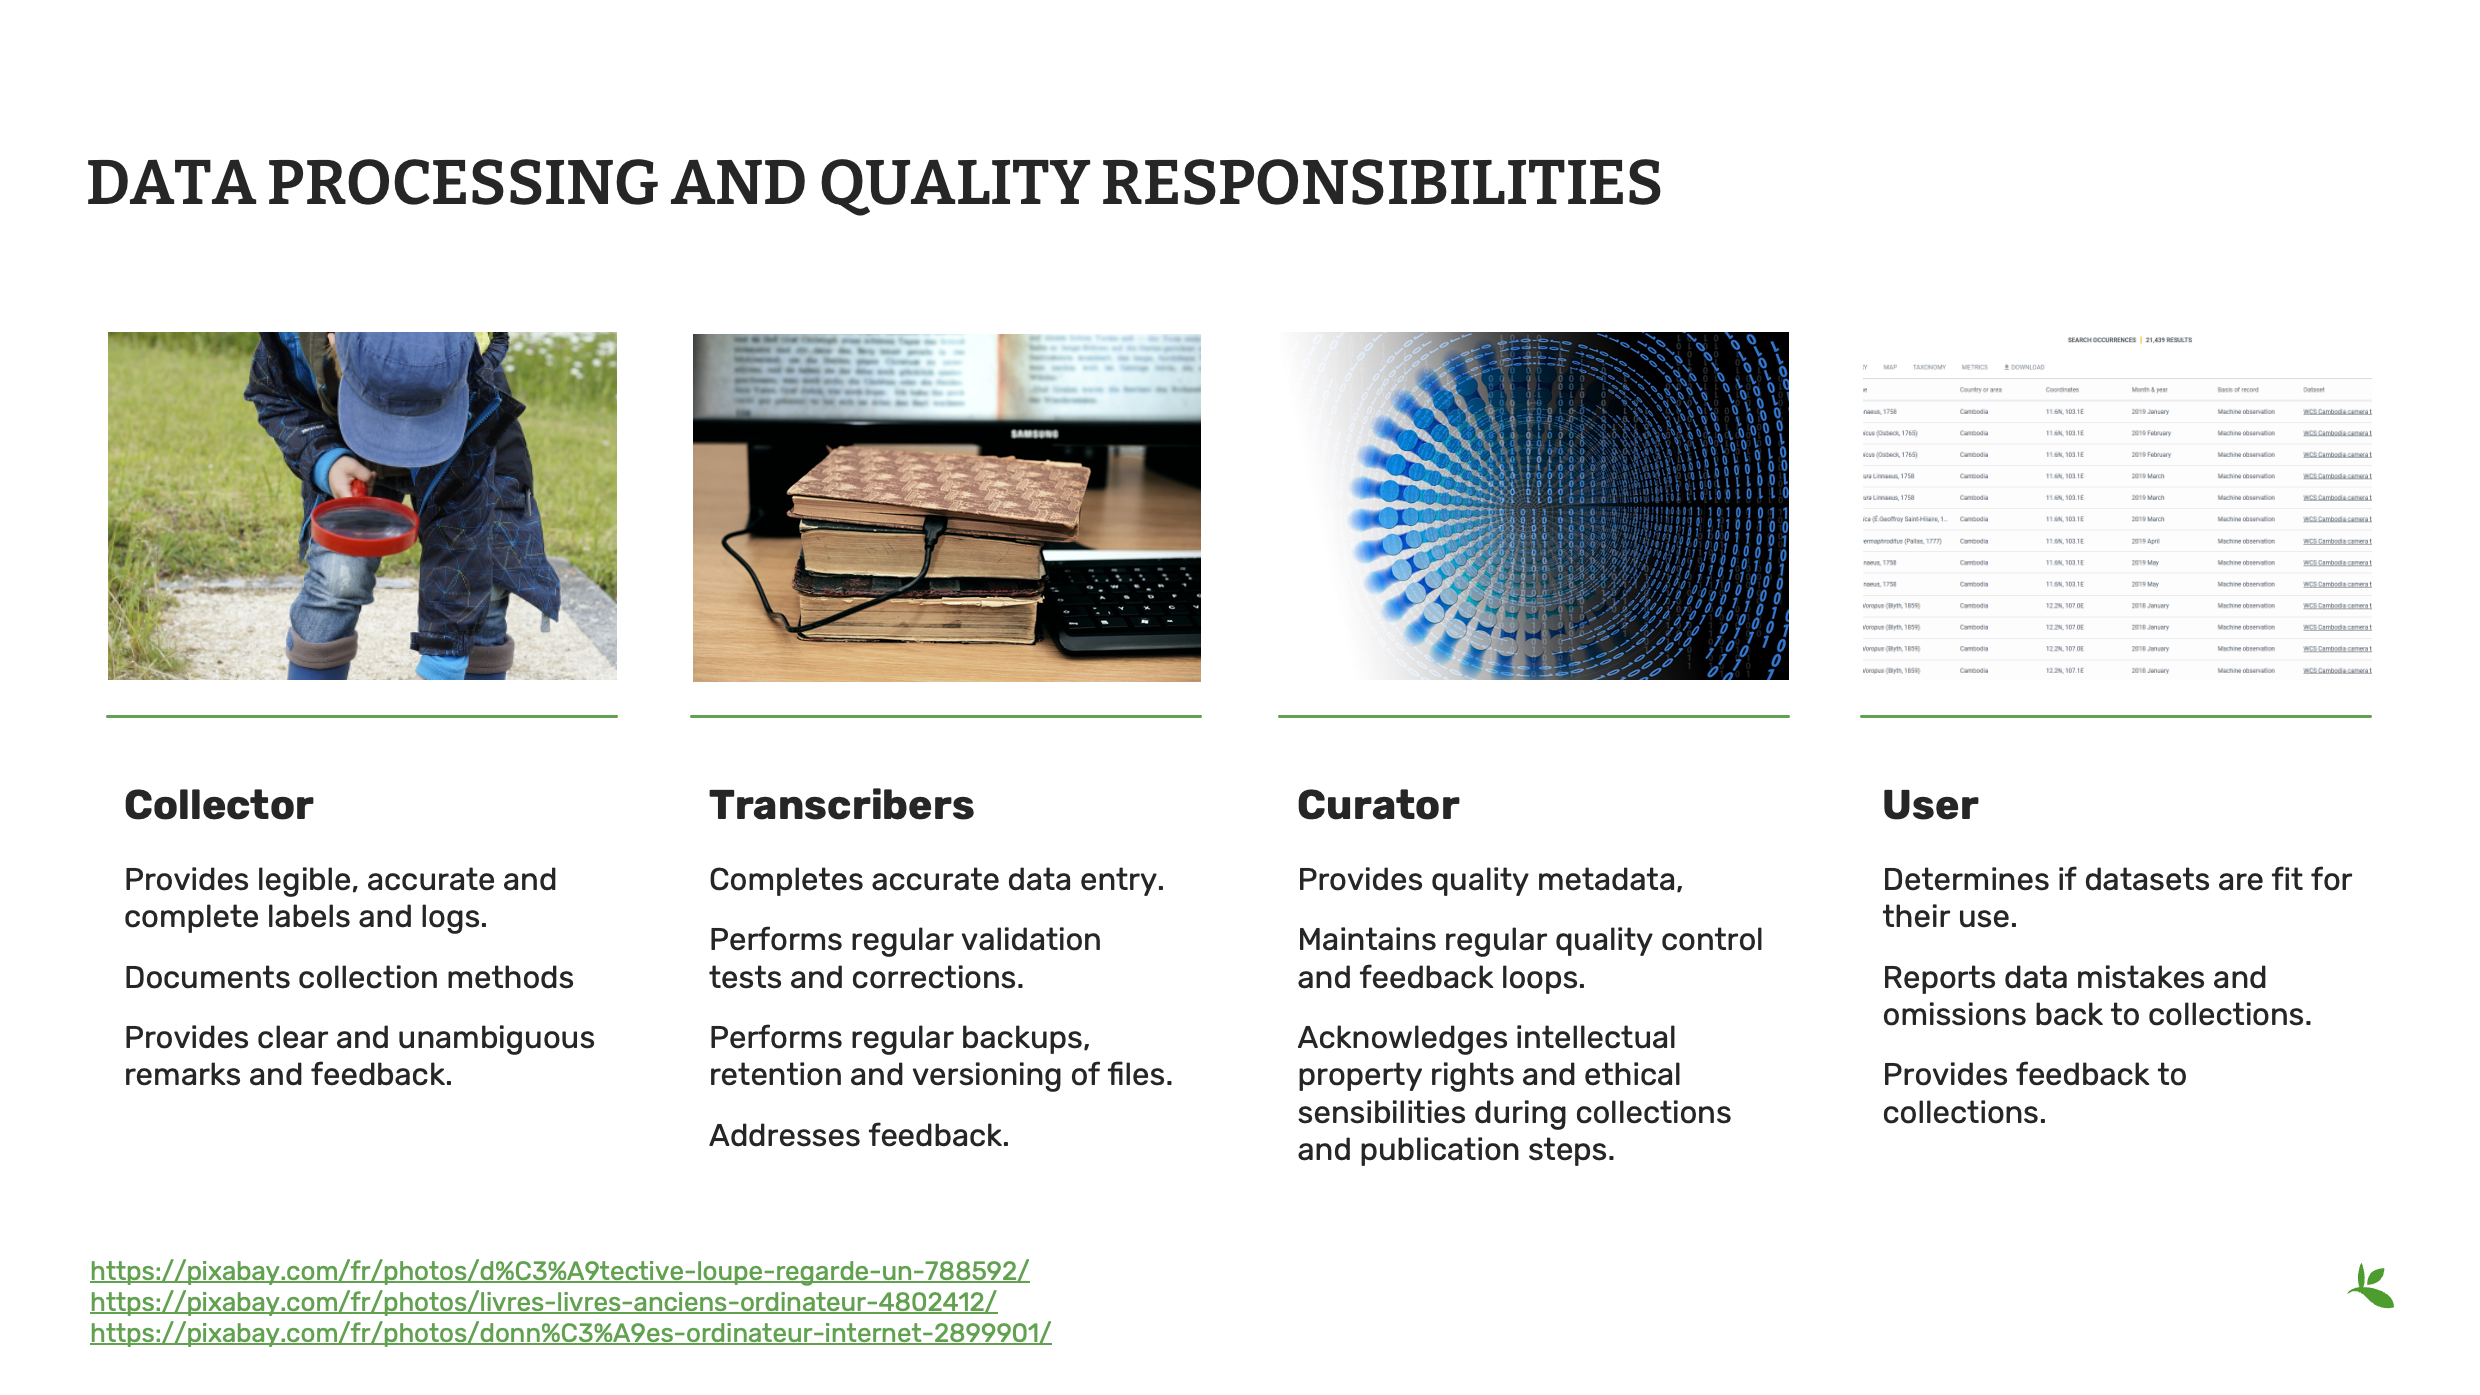
На этой упрощенной схеме потока данных показаны некоторые аспекты ответственности за качество данных для каждой группы участников процесса.
В этом примере команду, отвечающую за мобилизацию данных, можно разделить на две роли: «операторы ввода данных» и «куратор».
Команда операторов ввода данных должна обеспечить максимально качественный сбор и сохранение данных, в то время как «куратор» несёт общую ответственность за то, чтобы каждая команда надлежащим образом выполняла свою роль в этом процессе.
Фотография из коллекции: https://pixabay.com/fr/photos/d%C3%A9tective-loupe-regarde-un-788592/
Аватар пользователя: www.gbif.org (результаты поиска по набору данных с фотоловушек WSC в Камбодже)
Фотографии куратора: https://pixabay.com/fr/photos/livres-livres-anciens-ordinateur-4802412/ & https://pixabay.com/fr/photos/donn%C3%A9es-ordinateur-internet-2899901/
Слайд 6 — Структура
После того как рабочий процесс организован, можно приступать непосредственно к сбору данных.
На следующих слайдах мы рассмотрим различные типы информации, которую можно собирать с коллекционных экземпляров или полевых наблюдений, а также наиболее распространённые ошибки, которых следует избегать при работе с каждым типом информации.
Основными темами будут: таксономическая информация, пространственная информация, информация о коллекции и описательная информация.
Пожалуйста, обратите внимание, что каждая находка (каждая строка в вашей базе данных или электронной таблице) должна содержать информацию, относящуюся к этим четырём основным темам, чтобы данные можно было соответствующим образом публиковать и повторно использовать.
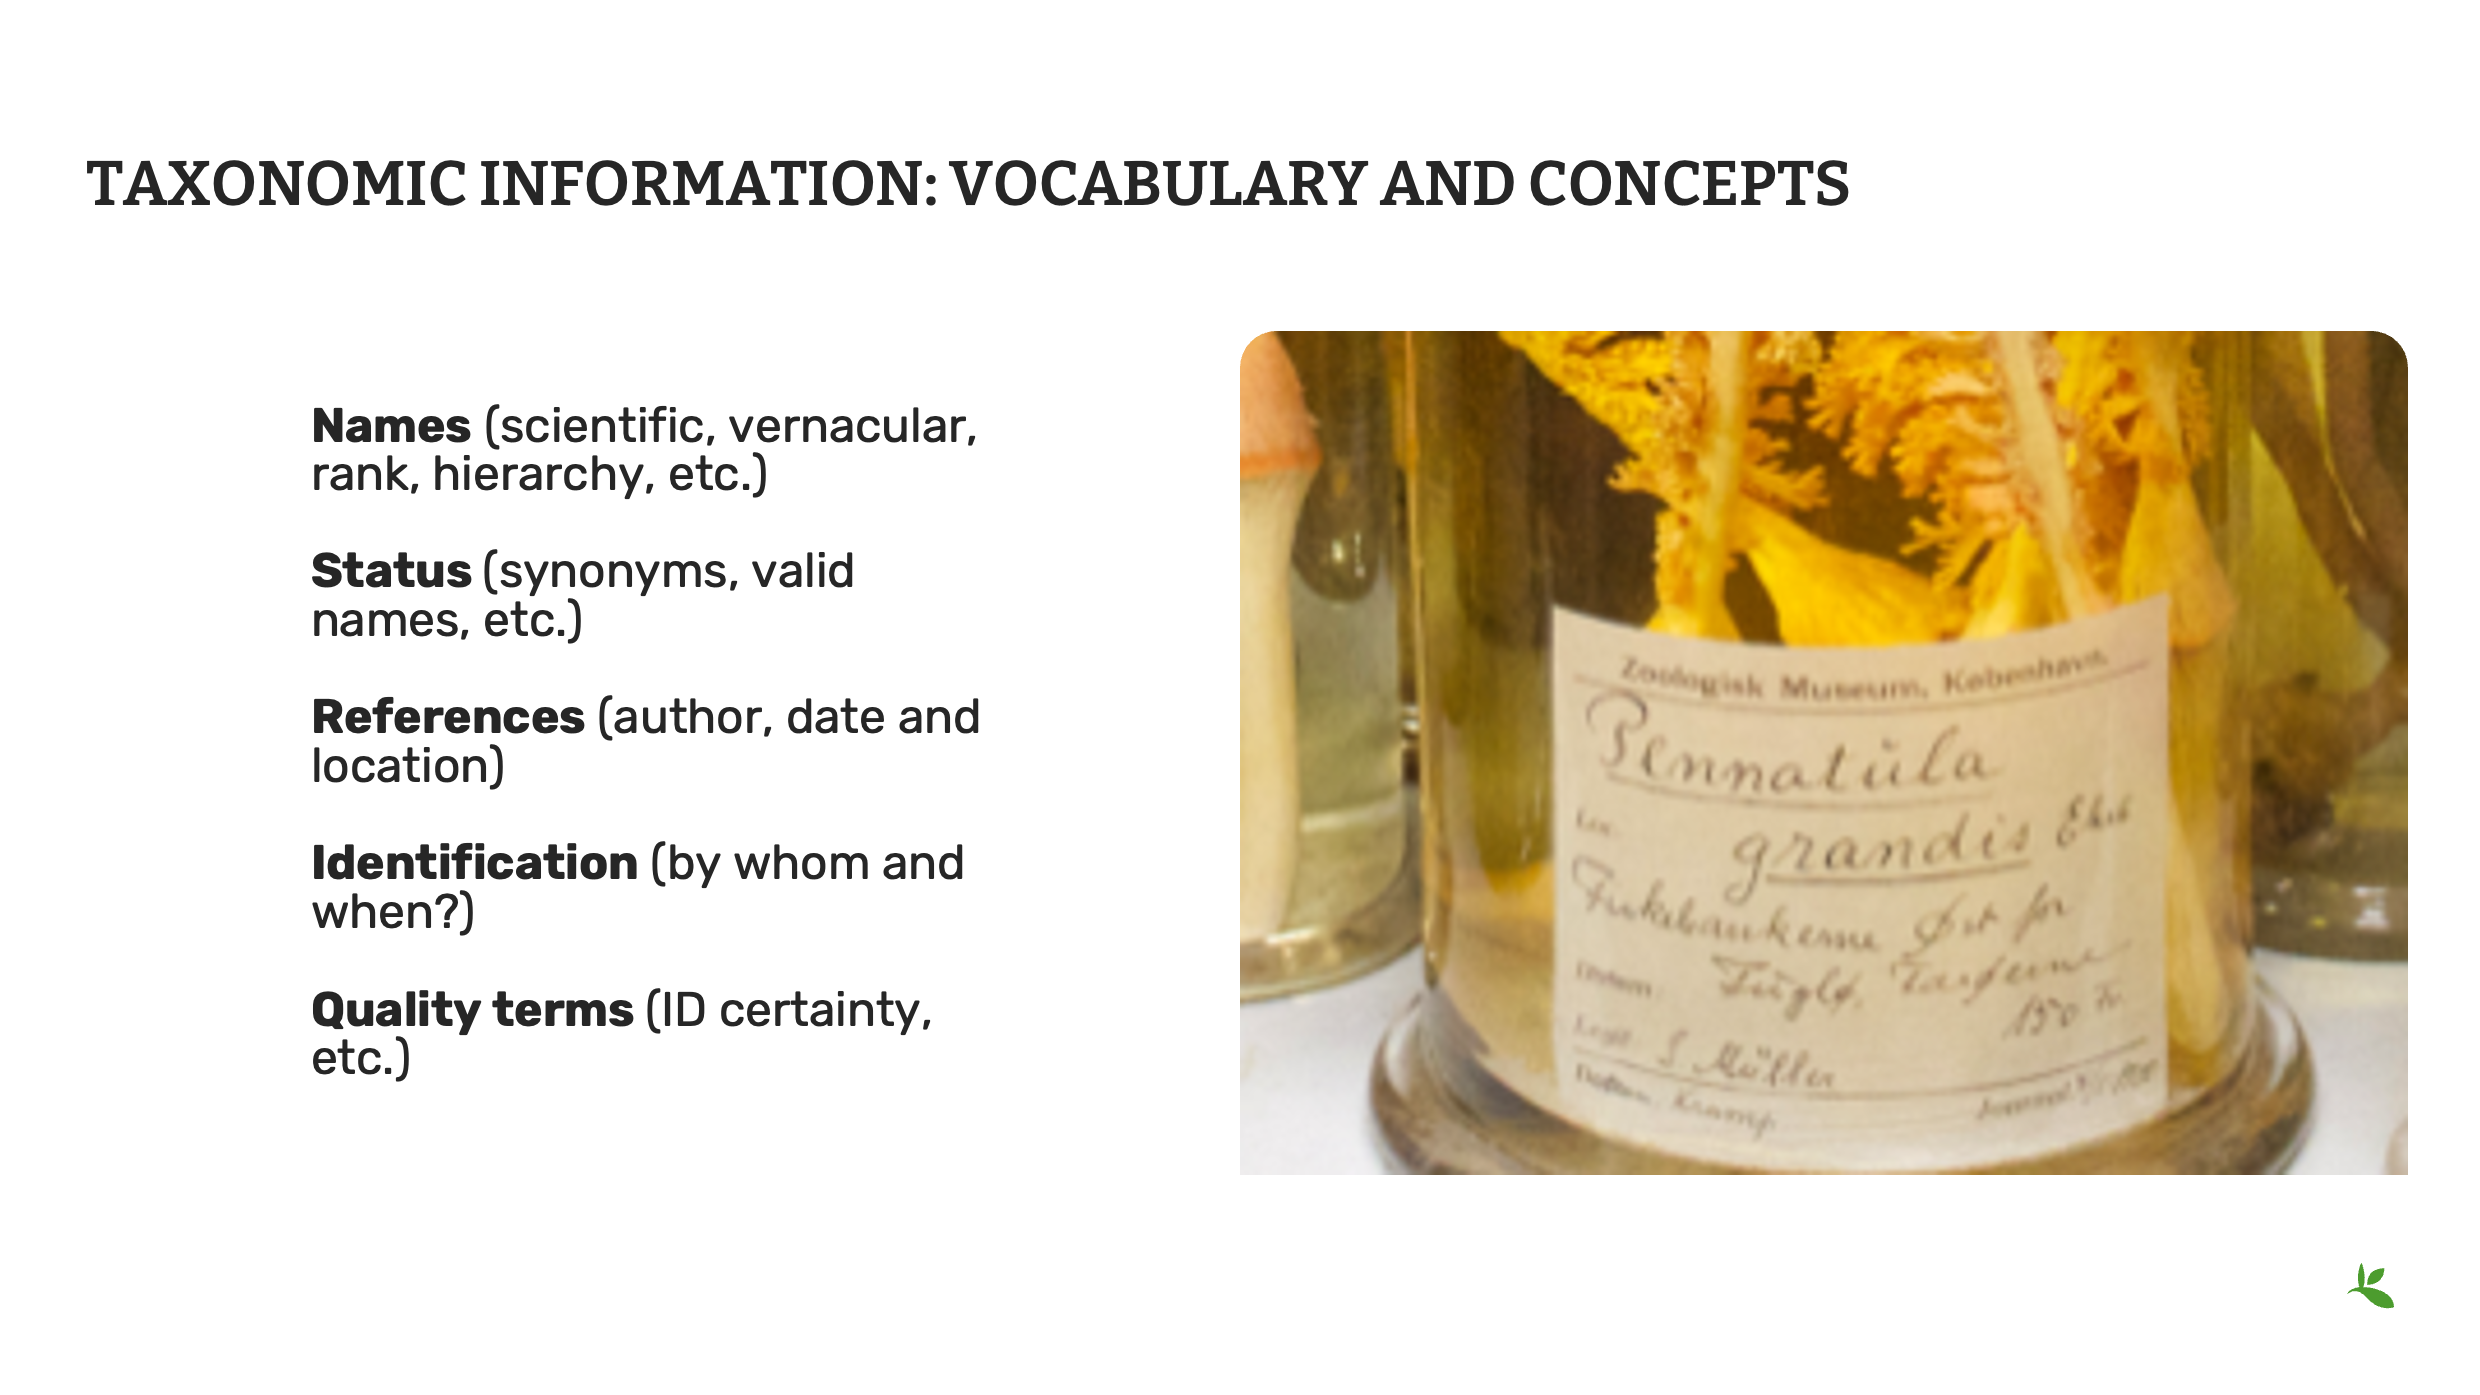
Слайд 7 — Таксономическая информация: терминология и понятия
Таксономическая информация является важнейшей частью процесса сбора данных.
Без неё оцифрованный экземпляр практически бесполезен, поскольку его невозможно правильно интерпретировать или повторно использовать.
Обратите внимание, что название вида — не единственный вид таксономической информации, которую можно использовать в процессе сбора данных: иногда экземпляр не определён до вида, и в таких случаях более высокие таксономические уровни, например род или семейство, также полезны для специалистов по управлению данными и пользователей.
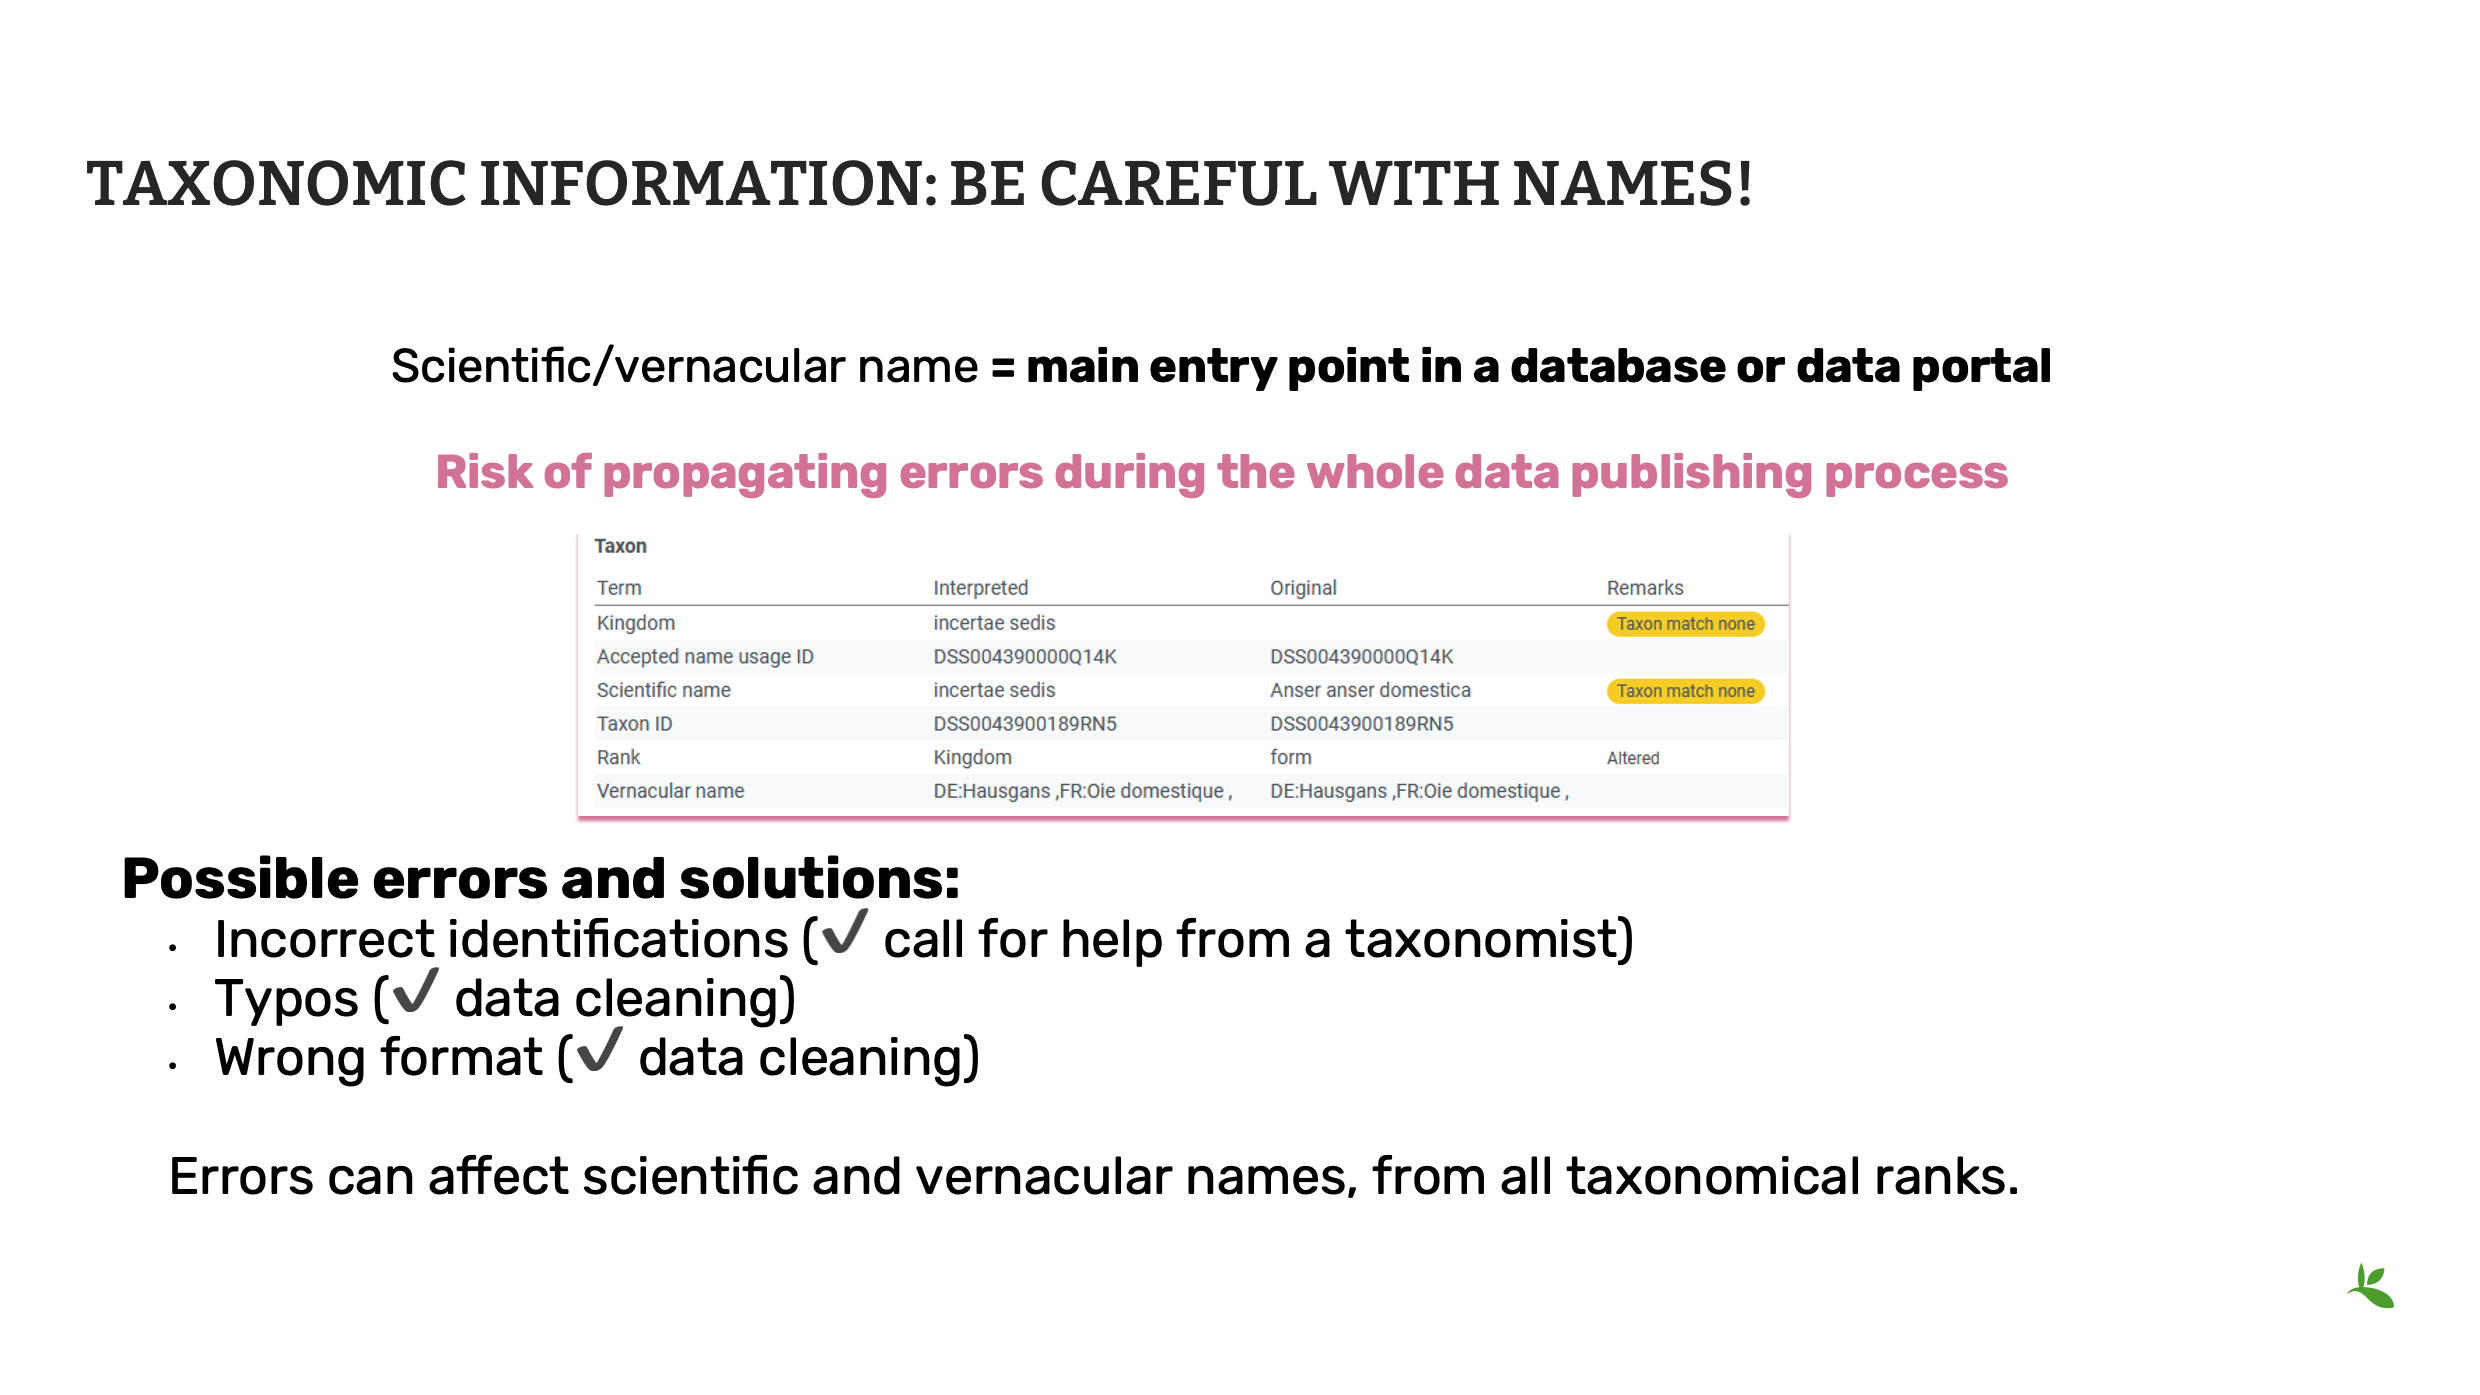
Слайд 8 — Таксономическая информация — будьте внимательны с названиями!
В большинстве случаев научное название является основным способом поиска данных в базе данных, на портале, веб-сайте, в браузере и т. д.
Любая ошибка в написании научного названия или его авторства может привести к неверным или пустым результатам поиска, что затрудняет управление данными и их возможное повторное использование.
Именно поэтому очень важно проверять все элементы научных названий, чтобы исправлять ошибки и/или устранять пропуски.
Слайд 9 — Таксономическая информация: типичные ошибки, которых следует избегать
Наиболее распространённые проблемы с таксономической информацией — это отсутствующие или несогласованные данные, некорректные или неделимые значения, дубликаты и неопределённость.
Всегда проверяйте определения и примеры таксономических терминов Darwin Core, чтобы избежать ошибок в номенклатуре: http://rs.tdwg.org/dwc/terms/index.htm
Слайд 10 — Пространственная информация: терминология и понятия
Географическая информация имеет большое значение во многих случаях повторного использования данных, например при моделировании экологических ниш или изучении распространения видов.
Хотя для «старых» коллекций или экземпляров определить точное географическое положение может быть сложно, а иногда и невозможно, по возможности рекомендуется предоставлять точные координаты или текстовую информацию о местонахождении.
о возможности координаты следует регистрировать непосредственно в полевых условиях вместе с указанием их неопределённости и используемой геодезической системы отсчета. В остальных случаях для географической привязки данных следует использовать достоверные и проверенные источники.
Следует учитывать, что в некоторых случаях координаты или другая географическая информация могут быть обобщены или вообще не публиковаться, например в целях охраны уязвимых видов.
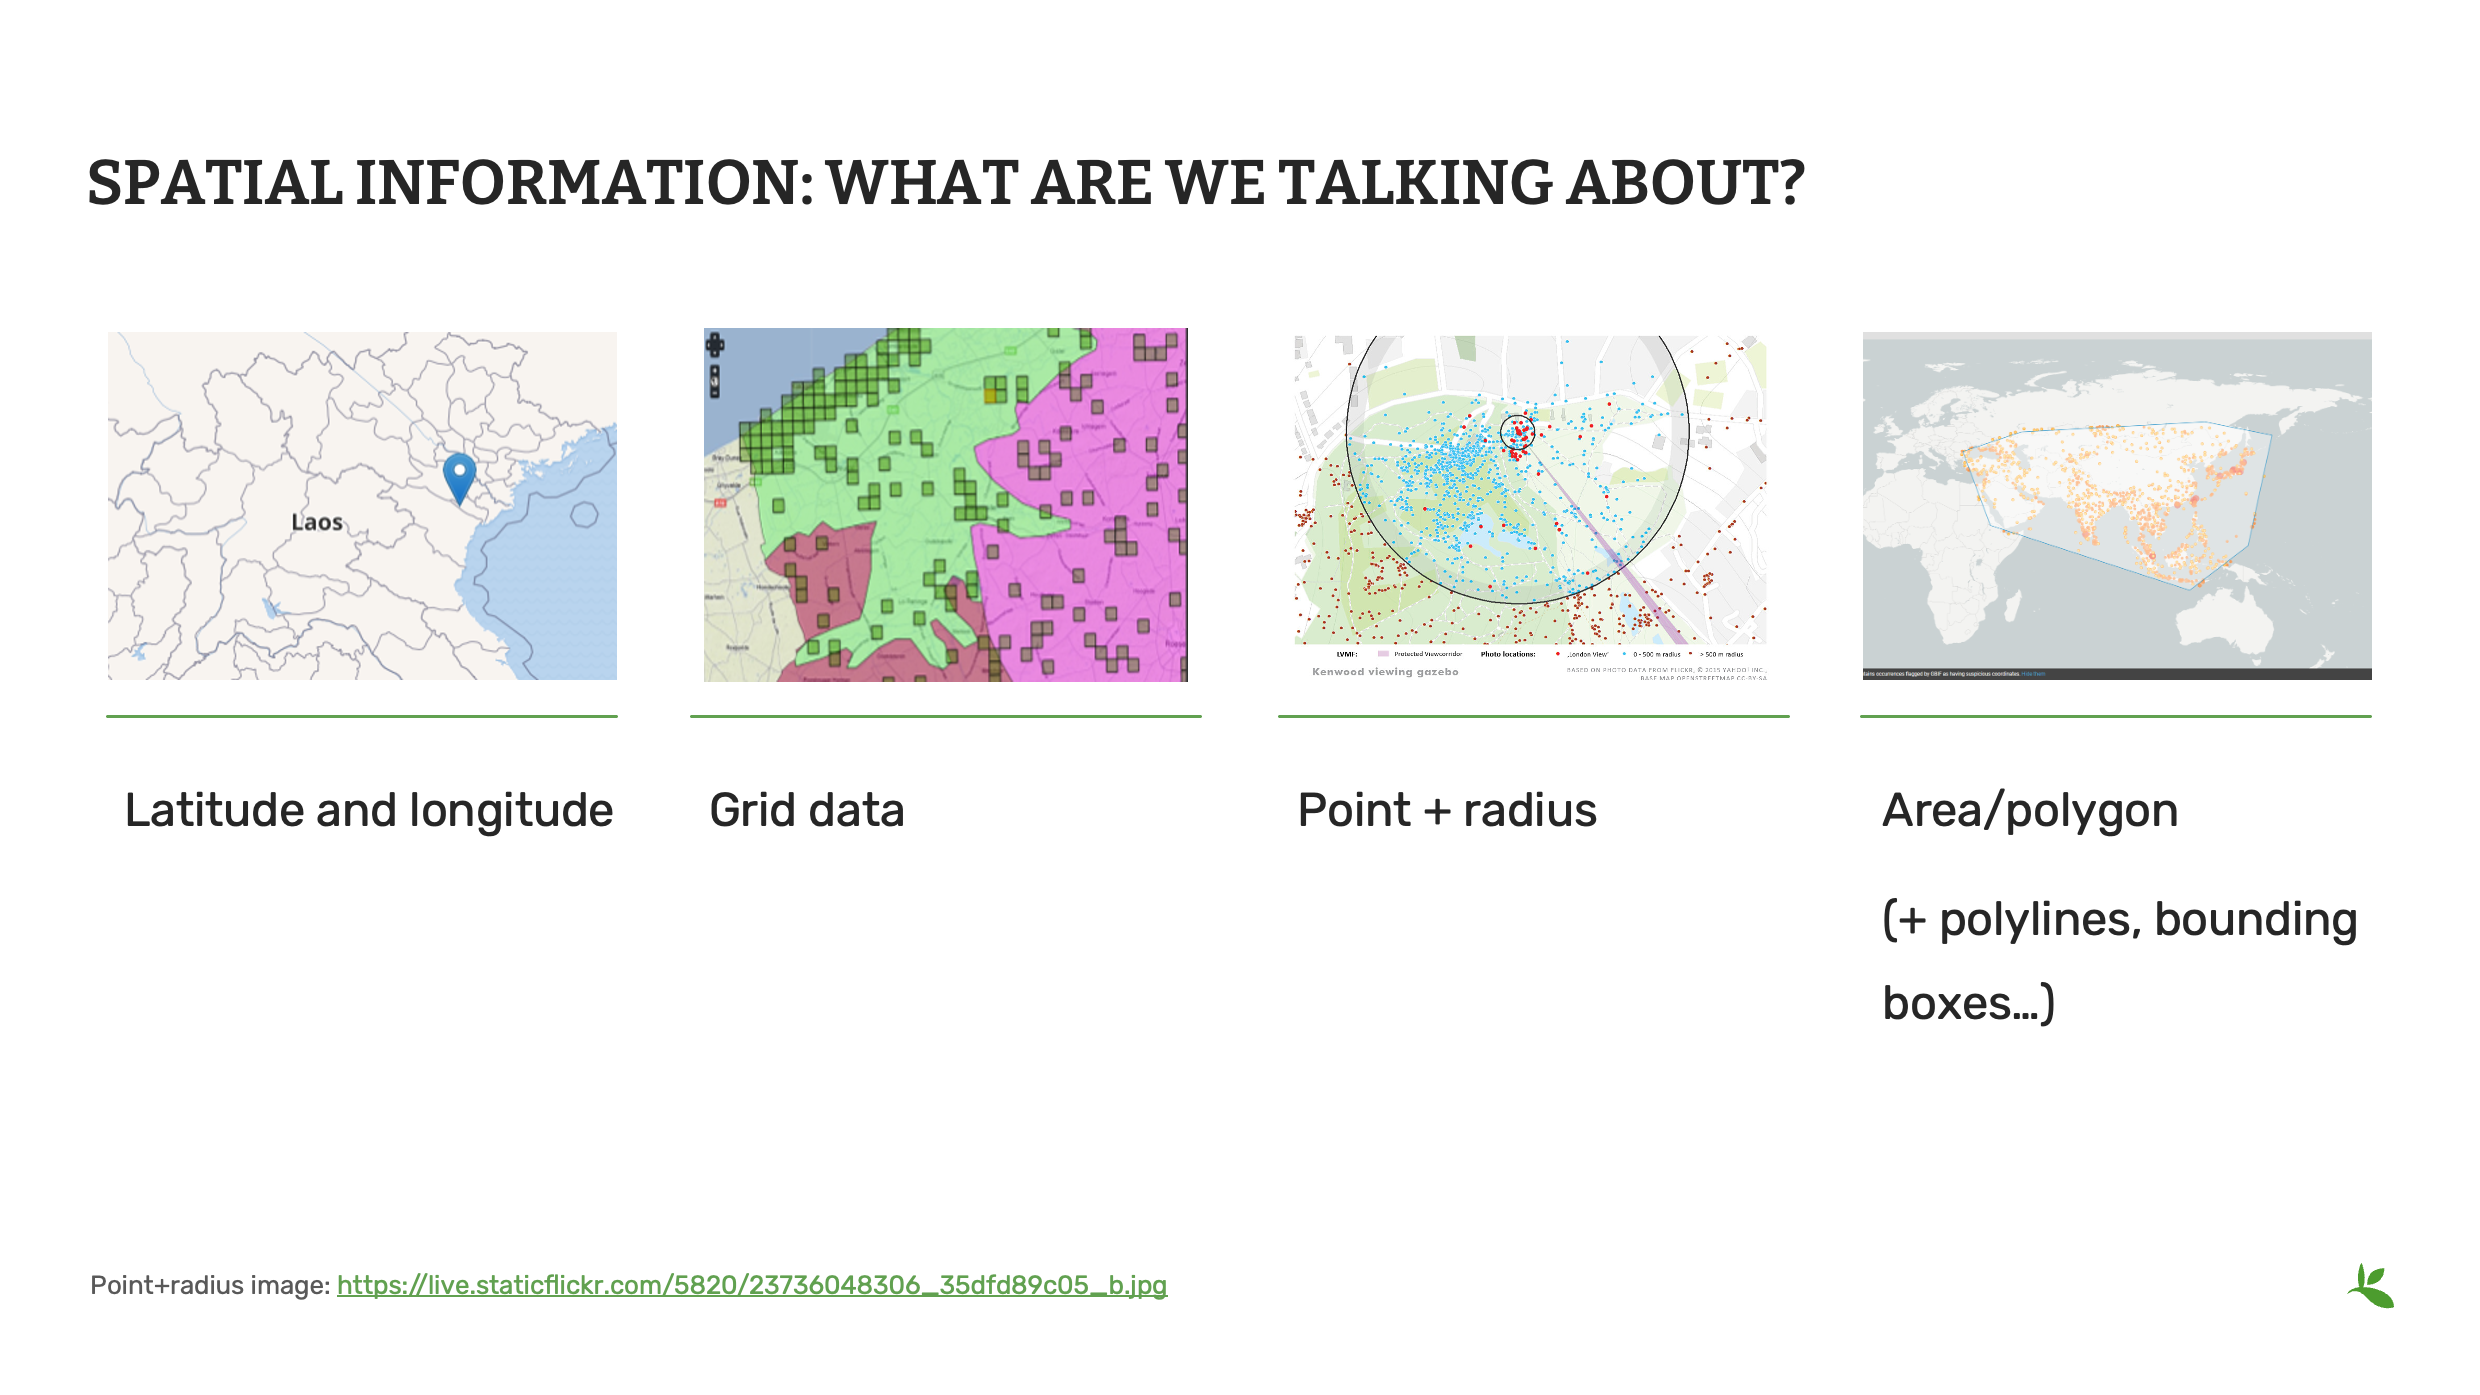
Слайд 11 — Пространственная информация: о чём идёт речь?
Пространственная информация может быть представлена в различных форматах, а не только в виде географических координат. К таким форматам относятся (но не ограничиваются ими), например, данные координатной сетки, точка с заданным радиусом или полигоны.
Каждый из этих видов информации полезно предоставлять для проверки согласованности географических данных (например, соответствия координат коду страны или соответствия указанного местонахождения маршрутам поездок коллектора)
Изображение «Точка + радиус»: https://live.staticflickr.com/5820/23736048306_35dfd89c05_b.jpg

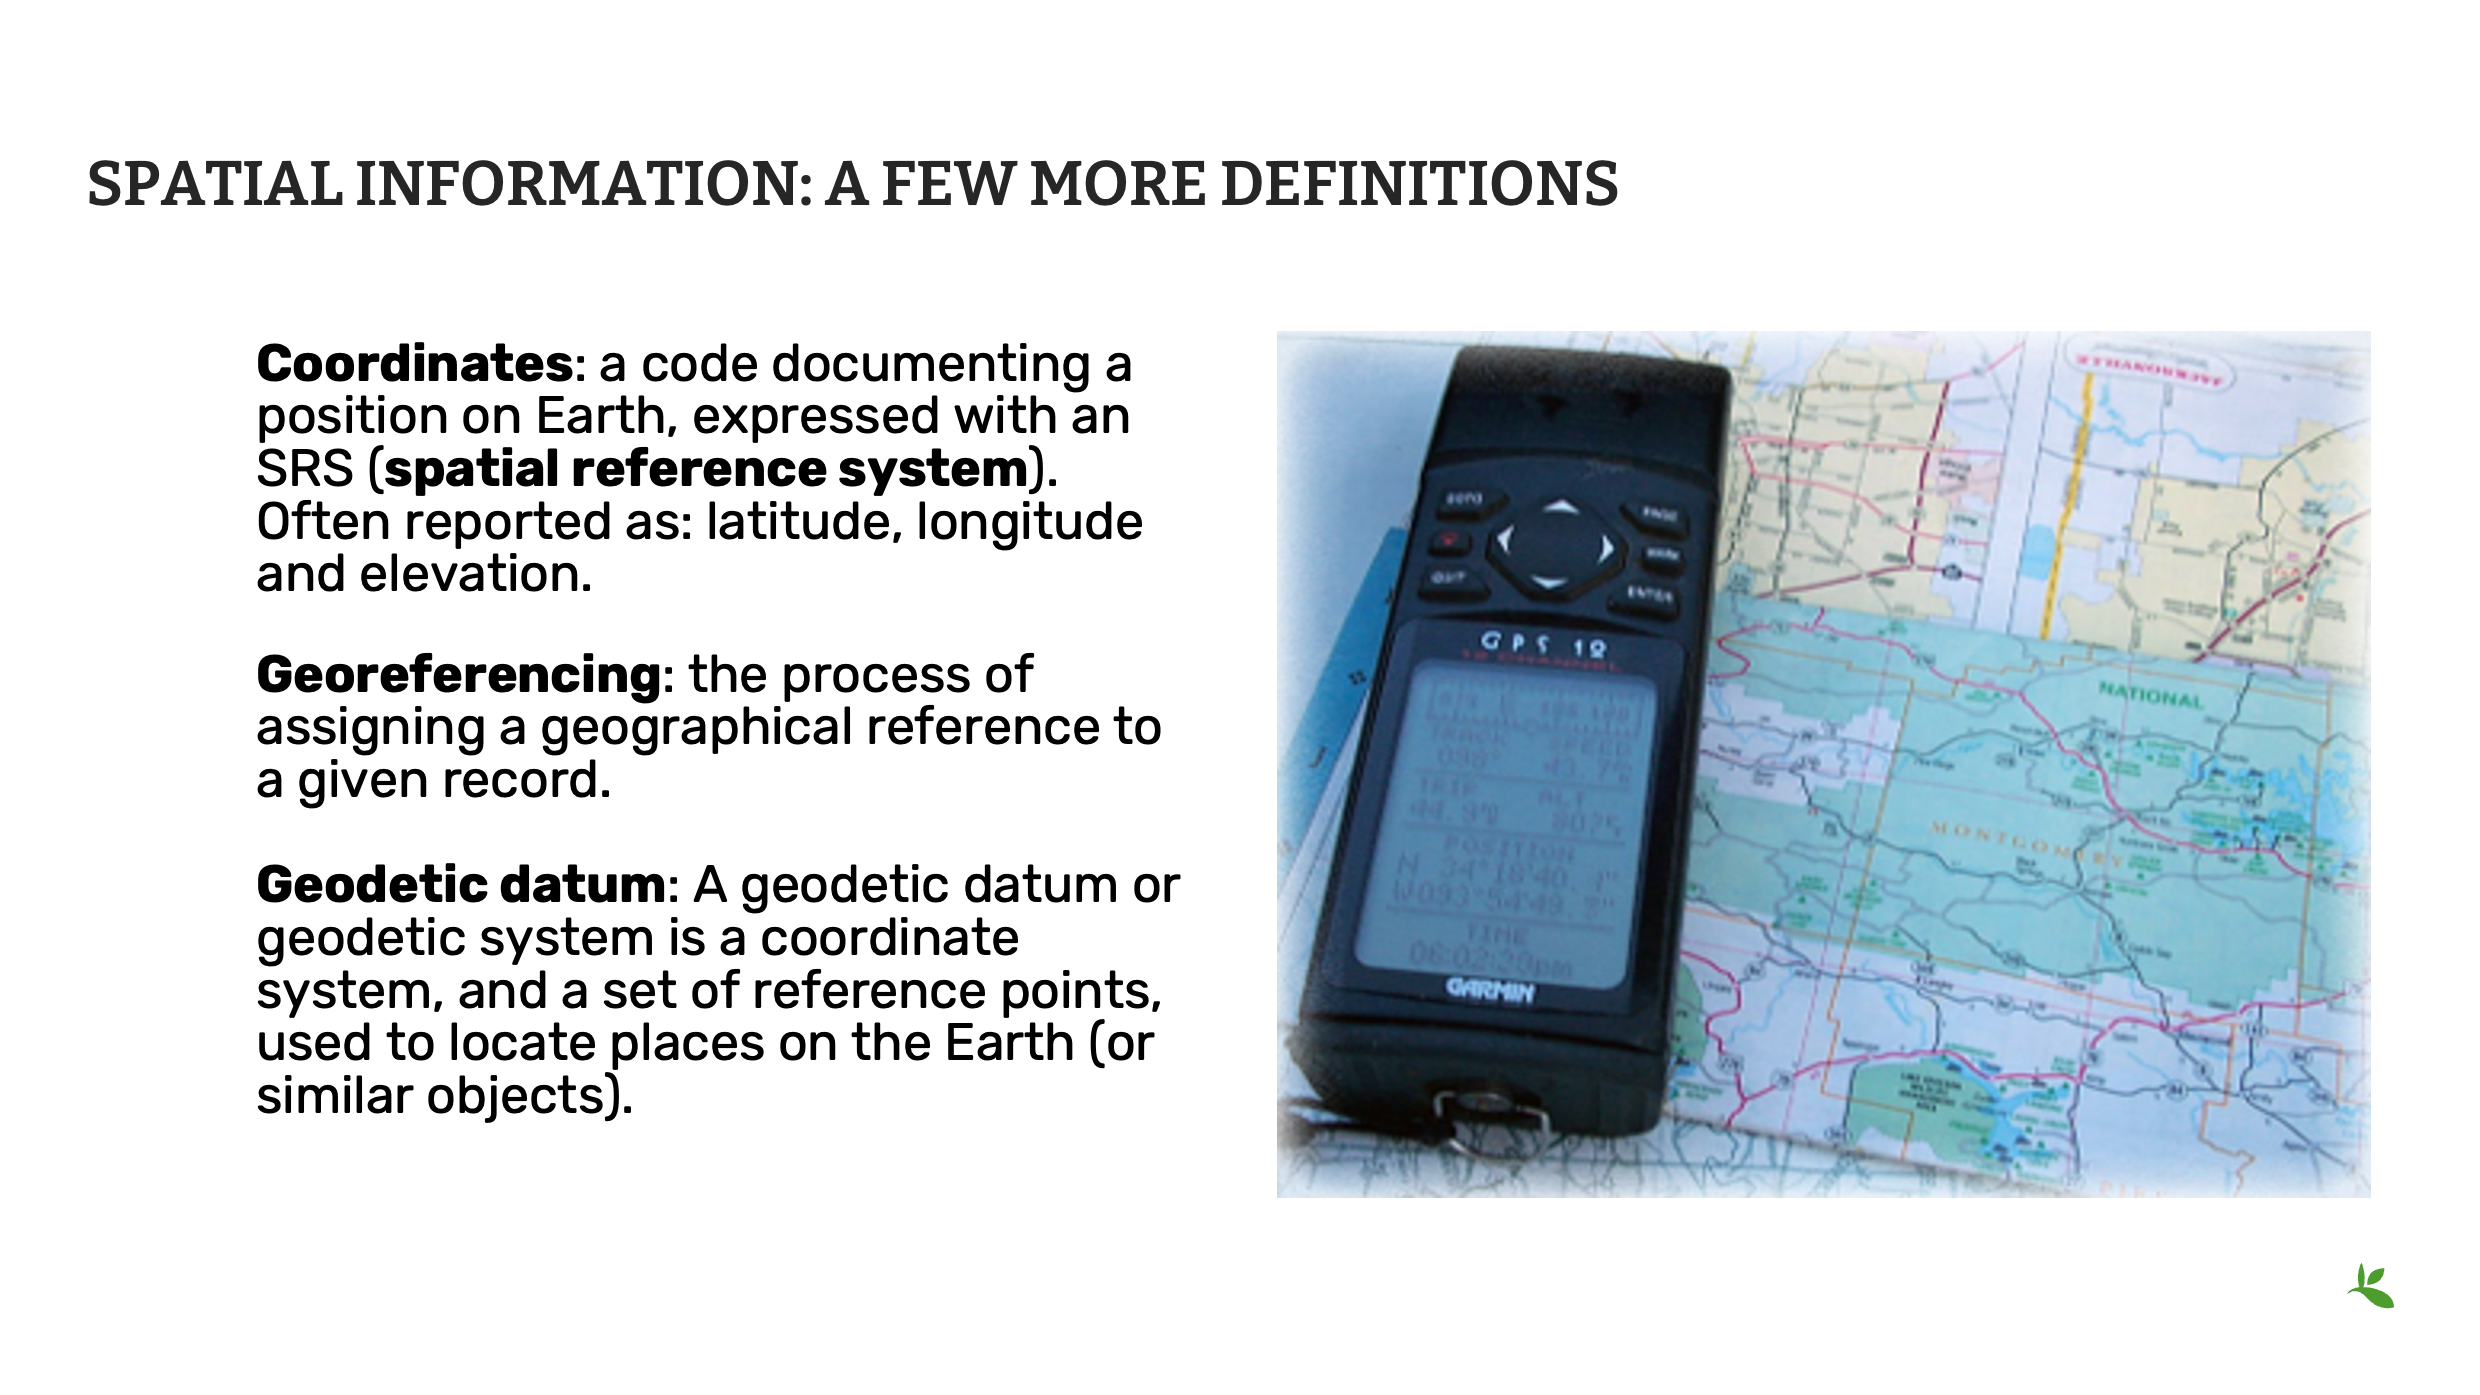
Слайд 12 — Пространственная информация: ещё несколько определений
В GBIF рекомендуется указывать геодезическую систему отсчета, которая использовалась для определения публикуемых координат (десятичной широты и долготы).
При отсутствии конкретной геодезической системы отсчета GBIF по умолчанию будет считать, что используется WGS84.
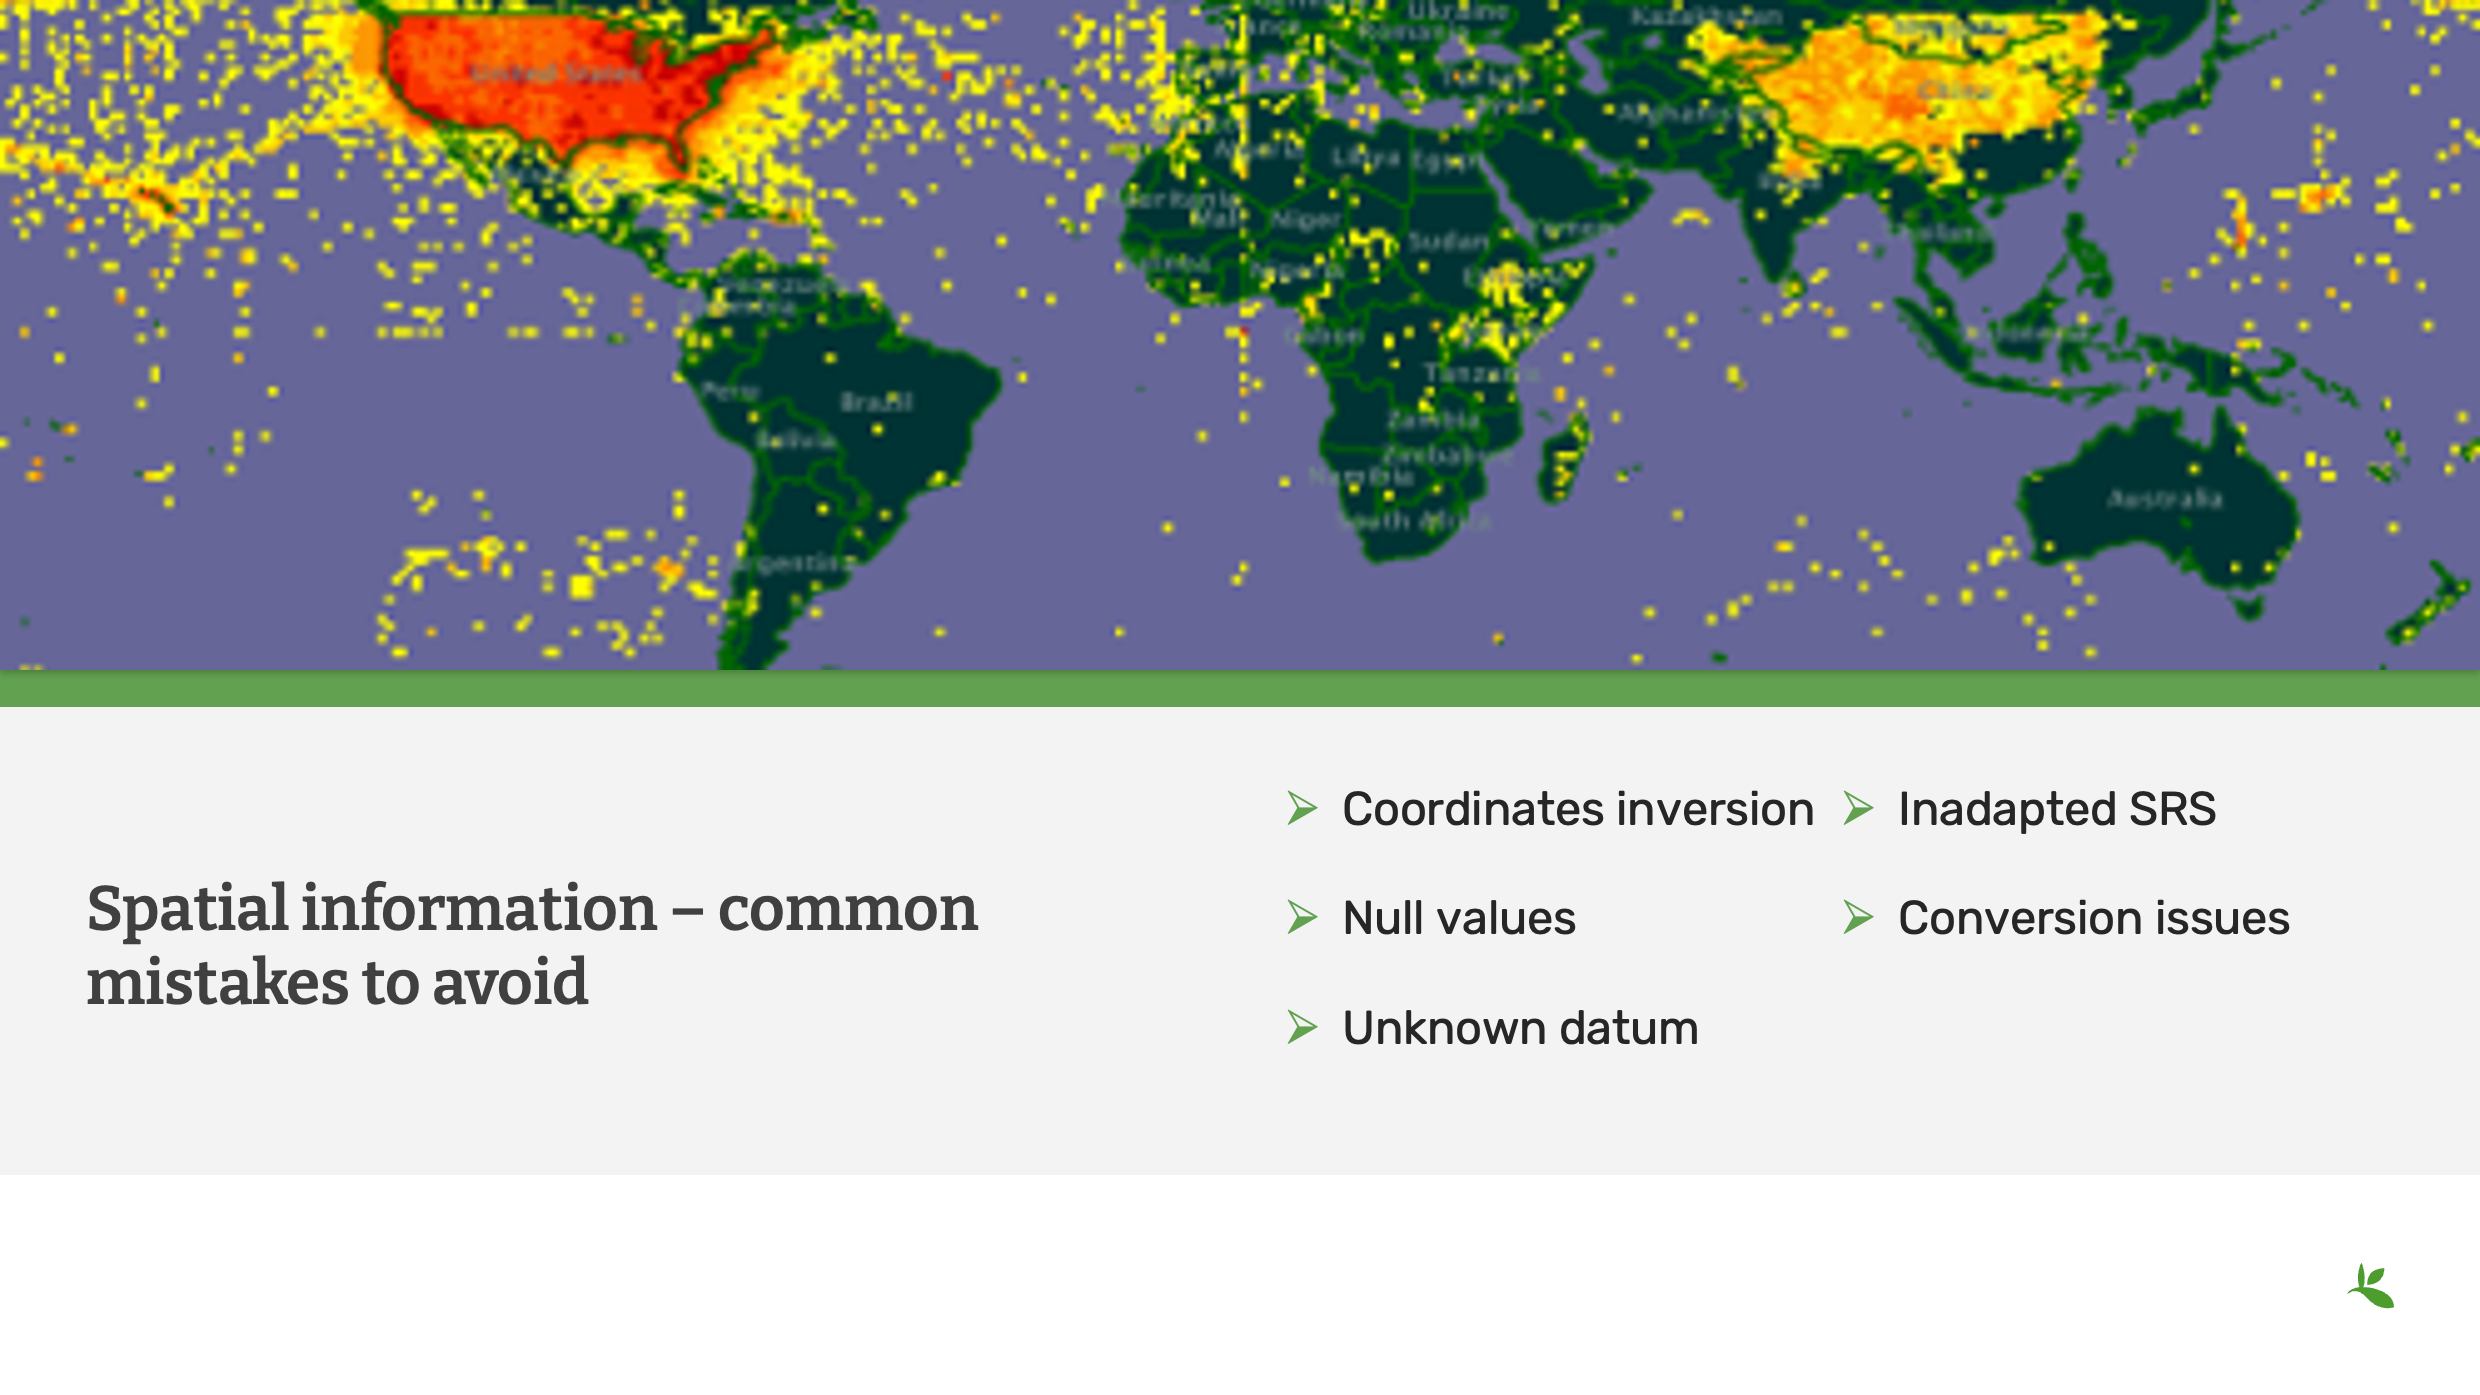
Слайд 13 — Пространственная информация: типичные ошибки, которых следует избегать
На этом слайде показана старая карта GBIF с различными типами ошибок в географических данных. Наиболее очевидная из них — зеркальное отображение данных между США и Китаем из-за перевернутых координат,
Также можно заметить искусственную линию вдоль Гринвичского меридиана, возникшую из-за значений «0» в поле decimalLongitude, а также аналогичную линию вдоль экватора, где значения «0» были указаны в поле decimalLatitude.
В процессе индексирования GBIF теперь осуществляется автоматическая проверка соответствия между координатами и кодом страны, указанным в наборе данных. При необходимости координаты могут быть автоматически переставлены местами, чтобы соответствовать указанной стране.
Слайд 14 — Информация о сборе: терминология и основные понятия
Информацию об условиях сбора данных или проведения наблюдений очень полезно публиковать, чтобы предоставить как можно больше сведений о каждой находке.
Такая информация, как имя коллектора, протокол сбора или наблюдения, местообитание и другие факторы, может иметь важное значение при повторном использовании данных, например для моделирования экологических ниш.
В зависимости от типа набора данных может оказаться актуальной и другая информация.
Источник изображения: https://pixabay.com/fr/photos/tige-afrique-jumelles-bush-safari-863823/
Слайд 15 — Информация о сборе: что следует учитывать
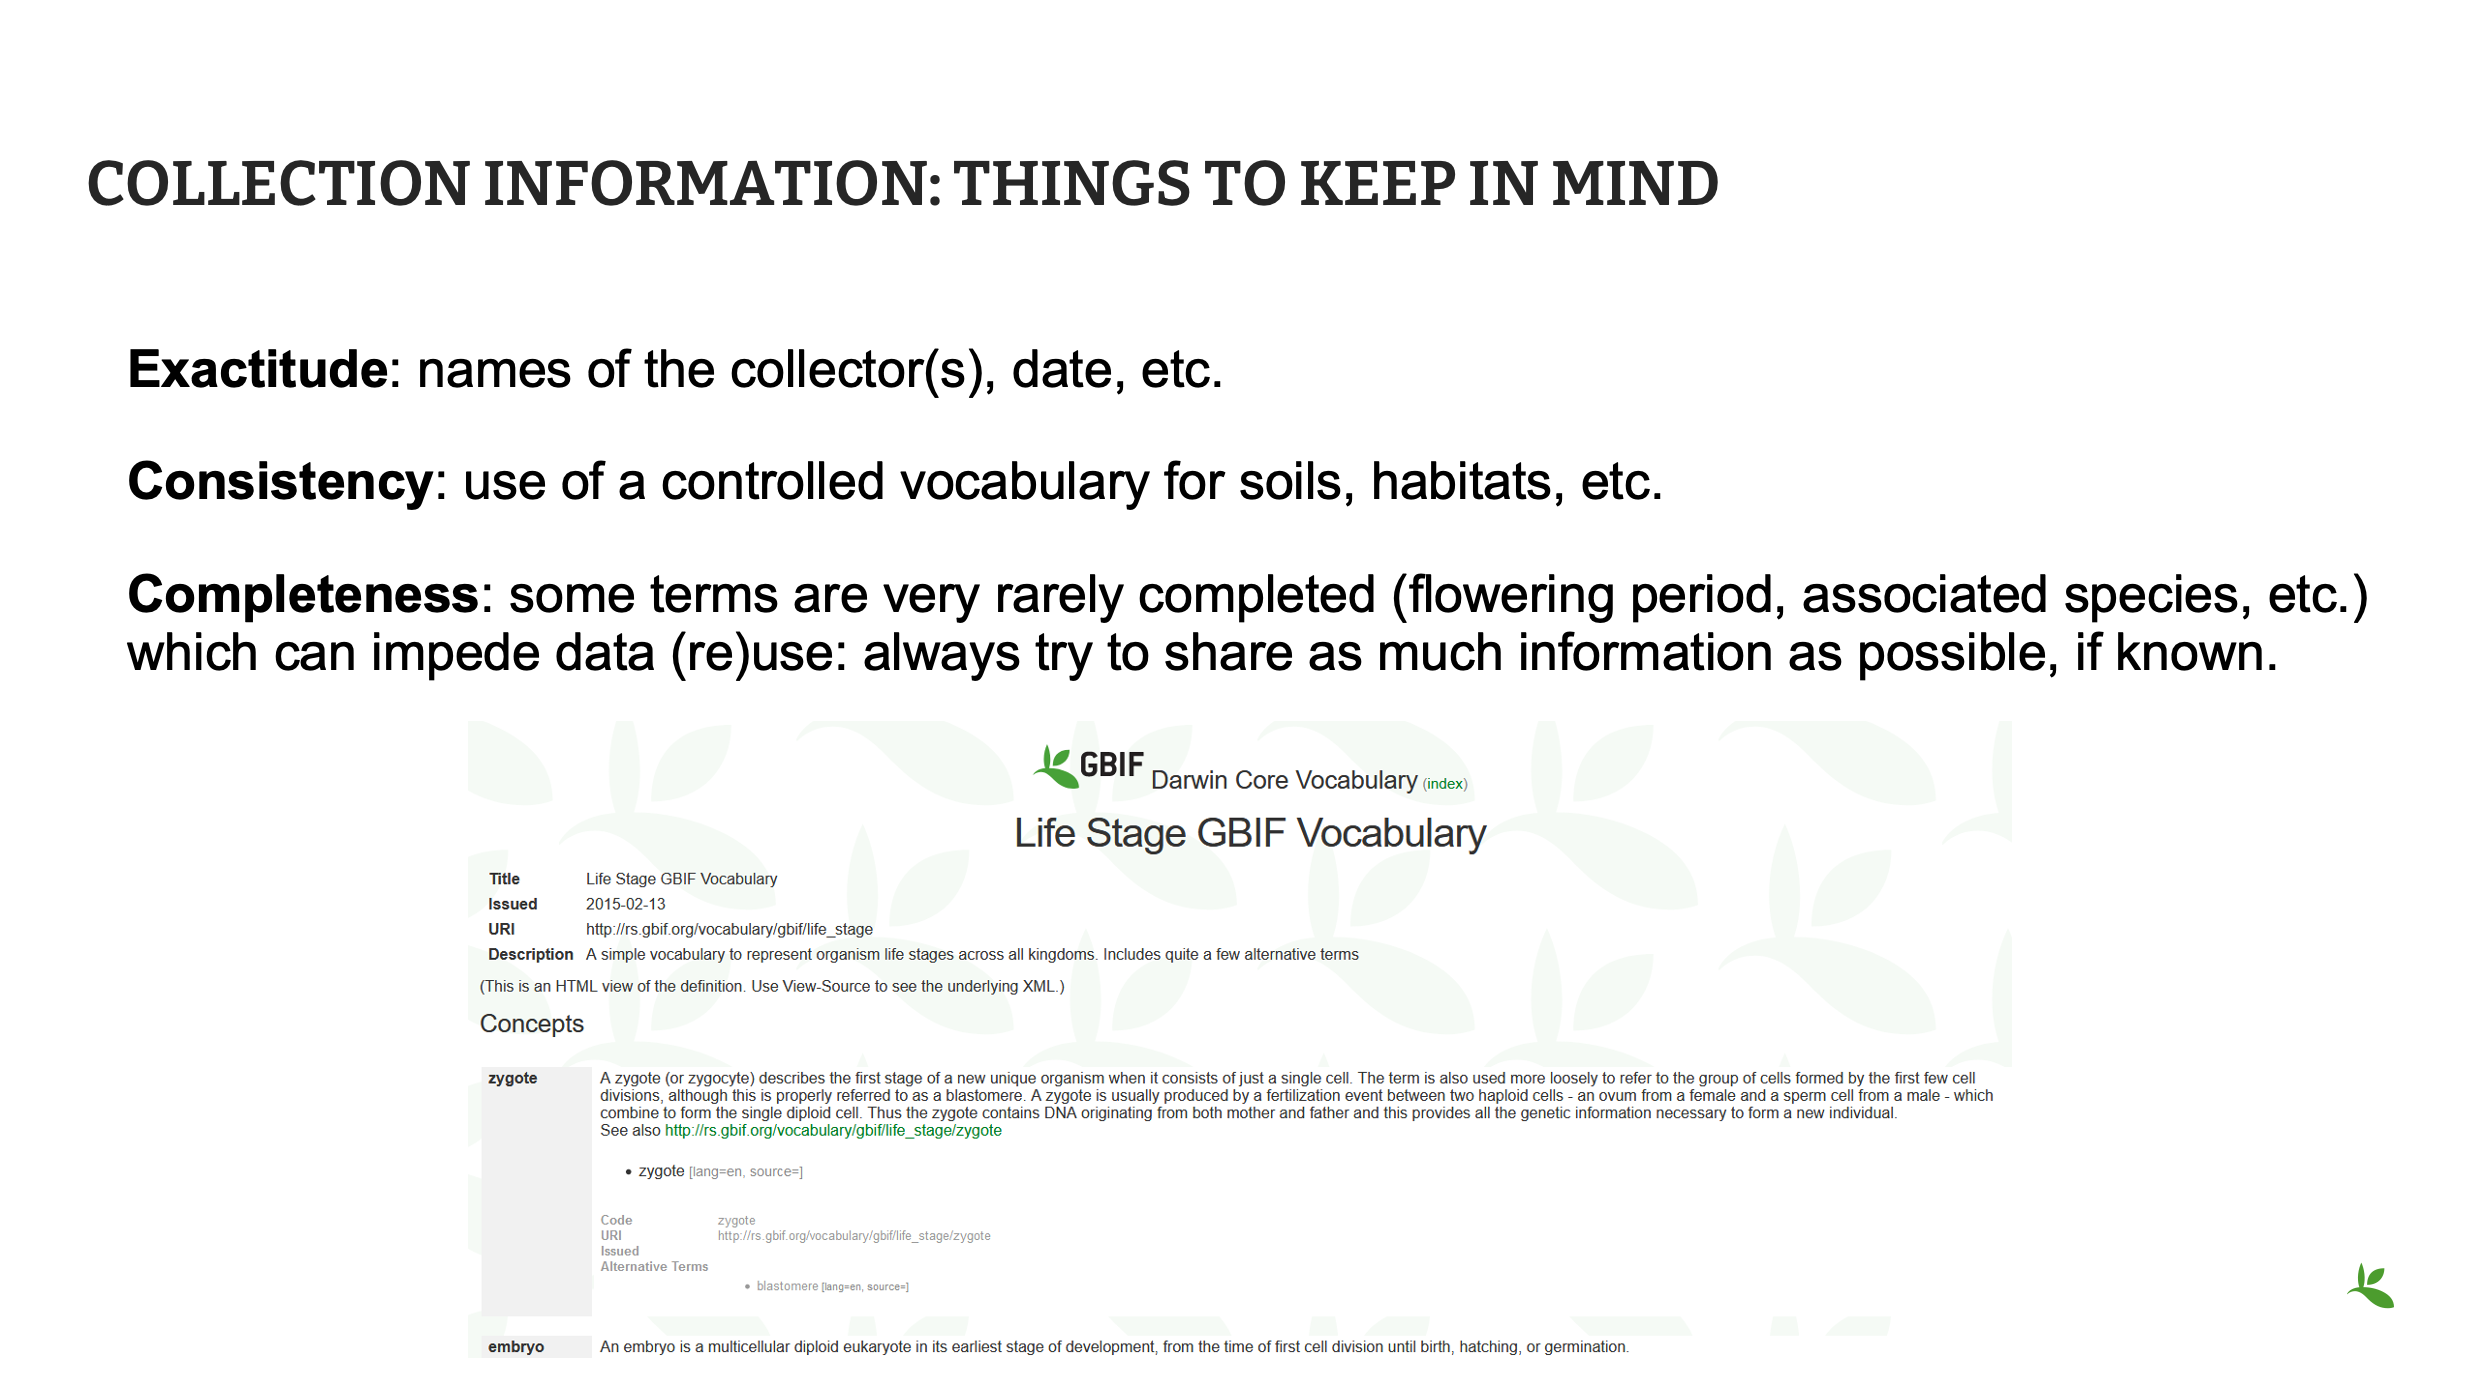
Факторы качества информации о сборе в основном связаны с точностью, например правильным указанием имени коллектора; согласованностью, например использованием единой терминологии для описания почв и местообитаний; а также полнотой, то есть предоставлением всей имеющейся информации при описании конкретного вида, включая период цветения, окраску листьев и использование в медицинских целях.
В Darwin Core и IPT для некоторых полей, например lifeStage, можно найти рекомендуемые контролируемые словари. Рабочая группа TDWG по словарям занимается продвижением словарей и повышением удобства их использования.
Слайд 16 — Описательная информация: терминология и понятия
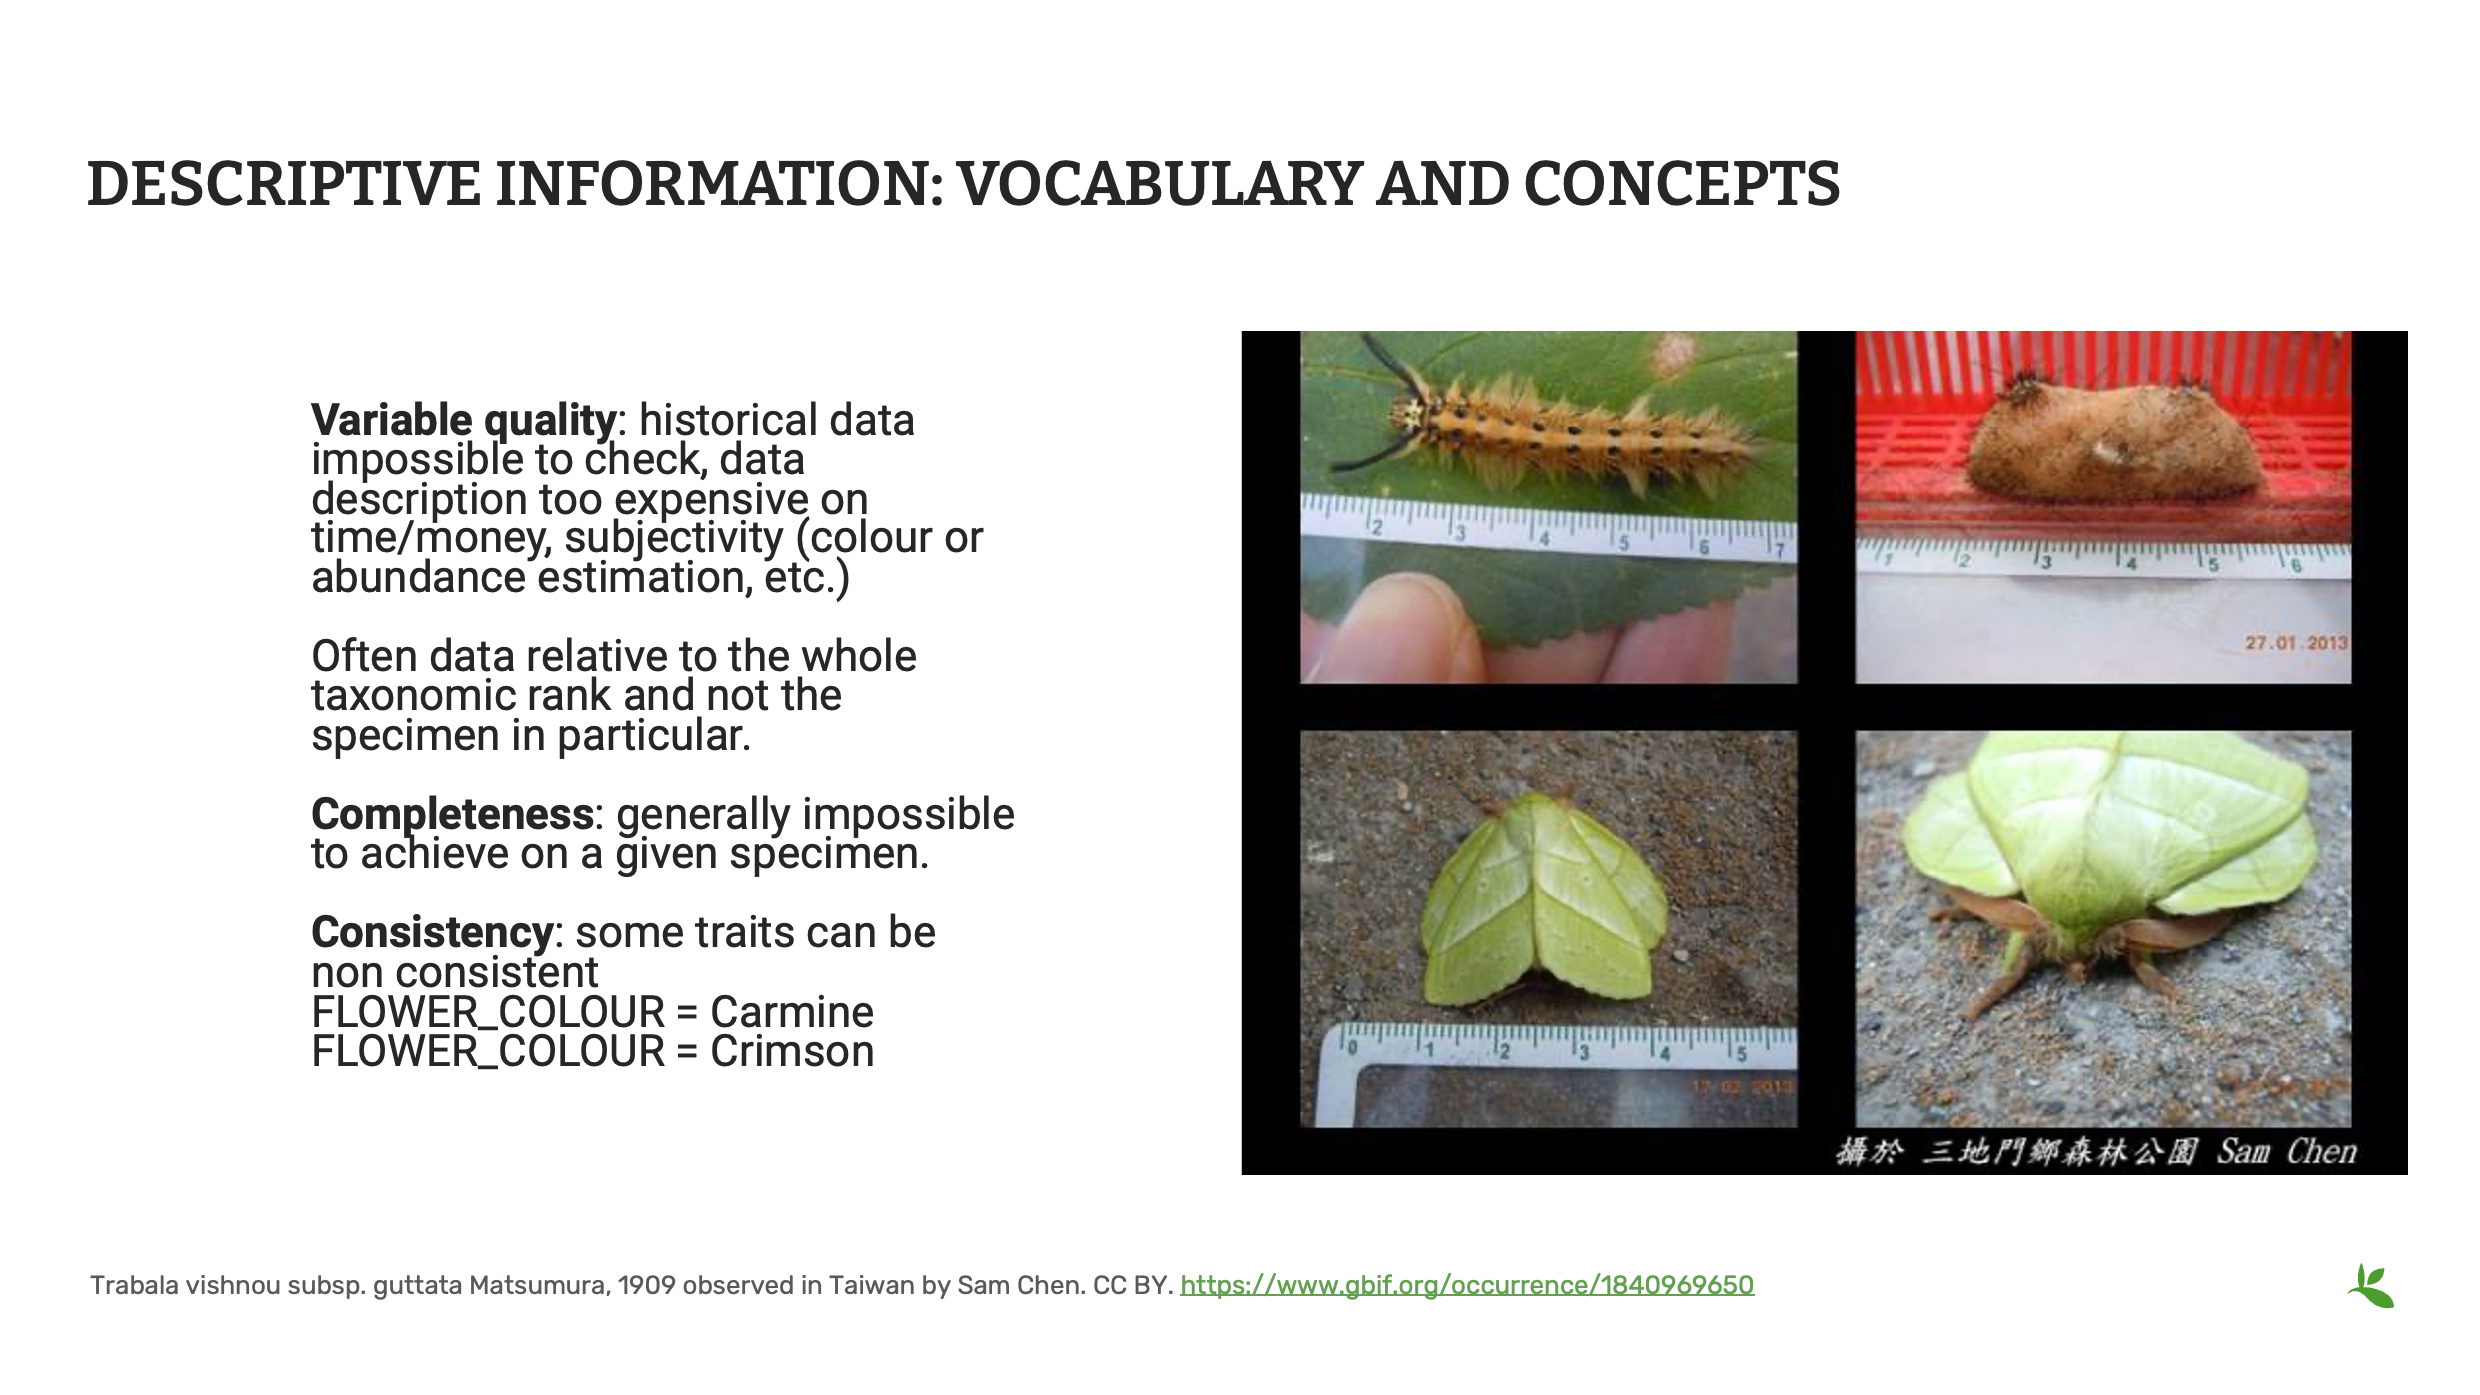
Следует учитывать, что описательная информация часто бывает неполной по целому ряду причин.
В зависимости от состояния коллекции некоторые этикетки могут быть неполными или не содержать важной информации; полноты данных (например, описания вида) часто невозможно достичь на основании одного экземпляра. Кроме того, всегда следует проверять согласованность данных в базе данных или электронной таблице, например терминов, используемых для описания окраски, чтобы избежать избыточной информации.
Источник изображения: набор данных о встречаемости бабочек на Тайване, собранный из социальных сетей

Слайд 17 — Заключение
Эта презентация была посвящена качеству данных применительно к процессу их сбора. Именно на этих этапах особенно важно обеспечить правильный и полный сбор всей информации, относящейся к каждой записи, чтобы данные были максимально ясными и понятными для будущих пользователей.
Это возможно только при условии принятия согласованных решений на уровне учреждения, позволяющих создать надёжный рабочий процесс сбора данных и управления ими.
Ответственность за качество данных распределяется между участниками каждого этапа процесса, однако следует помнить, что данные всегда можно улучшить и исправить, если ошибки или пропуски будут обнаружены на более поздних этапах.
Слайд 18 — Заключение
Эта презентация является частью серии презентаций, используемых в курсе GBIF по мобилизации данных о биоразнообразии. Учебная программа по мобилизации данных о биоразнообразии была первоначально разработана в рамках Программы развития информационных ресурсов по биоразнообразию (Biodiversity Information for Development Programme), финансируемой Европейским союзом.
Эта презентация изначально была разработана и озвучена Sophie Pamerlon при дополнительном участии тренеров, наставников и студентов BID и BIFA. Озвучивает — я, Lily Shrestha.
Упражнение 1c
|
В этом задании вы выполните упражнение, имитирующее перенос данных из аналогового формата в цифровой. Используйте «https://dwc.tdwg.org/terms/» [терминология Darwin Core^], чтобы определить, какие из предоставленных данных необходимы для проекта, и какие из них впоследствии могут быть опубликованы. |
-
Скачайте файл UC-Practice-1-ForCapture-logs.zip. (939 КБ). В сжатом файле содержатся три файла журналов.
-
Скачайте шаблон таблицы: UC-Practice-1-ForCapture-template.xlsx (27 КБ), чтобы внести в него записанные наблюдения.
-
Для ответов воспользуйтесь ранее загруженным листом с упражнениями.
| Вы можете добавить поля в шаблон, если считаете, что вам может понадобиться собрать больше информации, чем предусмотрено в шаблоне. |